0
2
0
0
海光DCU进阶:存储结构与内存管理深度解析——从Bank冲突到页锁定内存
2026-09-20 20:08:40
50
摘要:本文深入解析海光DCU的存储结构与内存管理机制,涵盖可编程存储金字塔、四种存储器的特性对比、共享内存Bank冲突的原理与规避策略、存储修饰符与函数修饰符的使用规范、全局内存的动态管理与Symbol变量、页锁定内存的性能优势,以及同步与异步数据传输的最优实践。旨在帮助开发者理解DCU的存储层次,掌握高效的内存管理技巧。
**关键词:**海光DCU;HIP编程;共享内存;Bank冲突;页锁定内存;存储结构;数据传输
---
## **引言**
在上一篇《第一个程序与执行模型》中,我们解决了“线程如何组织”的问题。但一个高性能的DCU程序,光有正确的线程组织远远不够——**性能的瓶颈往往出现在“数据放在哪儿、怎么访问”上**。第一篇《架构详解》中反复强调过一个判断:**DCU程序的瓶颈,往往不在计算,而在数据读取。**本文正是把这句话落实到代码层面:深入剖析DCU提供了哪几种存储、它们各自的特性是什么、以及如何高效地利用它们——尤其是**共享内存的bank冲突**和**全局内存与主机的数据传输**这两个核心重点。
## **一、可编程存储与不可编程存储**
对开发人员来说,DCU上的存储器可以清晰地分为两类:
* **可编程的:**需要显式地控制哪些数据存放在里面,例如全局内存和共享内存。
* **不可编程的:**程序自动决定数据放在哪里,无法直接干预,例如L1和L2缓存。
这是一个与CPU截然不同的设计理念。在CPU的内存层次中,各级缓存都是不可编程的——编写代码时感觉不到它们的存在,一切由硬件自动完成。而在DCU上,**共享内存是“可编程的缓存”**:它和缓存一样快,但要不要用它、怎么用它,完全由开发者决定。这份额外的控制权,既是DCU能榨出高性能的原因,也是它编程门槛更高的原因。
DCU的可编程存储结构可以看作一个金字塔,如图3-7所示:
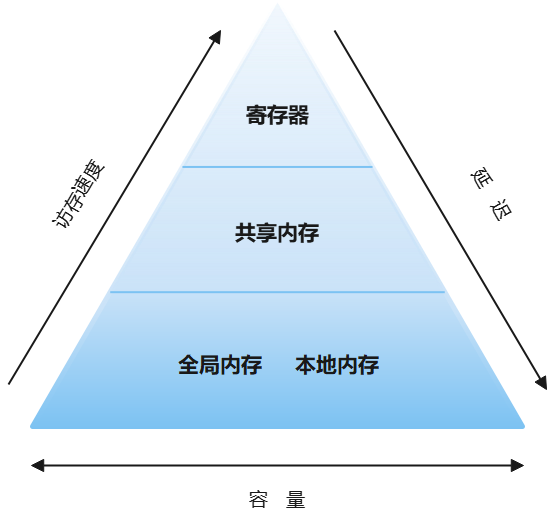
*图3-7 可编程存储结构*
金字塔的三条边清晰地揭示了一个规律:**越往上,访问速度越快、延迟越低,但容量越小;越往下,容量越大,但延迟越高。**
| **层级** | **速度** | **容量** | **归属** | **生命周期** |
| ------------------- | -------------- | -------------- | --------------- | ------------------ |
| 寄存器 | 最快 | 最小 | 线程私有 | 随线程 |
| 共享内存 | 很快 | 64 KB / CU | 线程块内共享 | 随线程块 |
| 全局内存 / 本地内存 | 慢 | 最大 | 全局 / 线程私有 | 随程序 / 随线程 |
## **二、四种存储的脾气**
### 2.1 寄存器:最快,但会“溢出”
寄存器是DCU上访问速度最快的内存空间。**什么变量会进寄存器?**
* 如果核函数中声明的自变量没有其他修饰符,那么它通常存储在寄存器中。
* 在核函数声明的数组中,如果用于引用该数组的索引是**常量且能在编译时确定**,那么该数组也存储在寄存器中。
寄存器变量对于每个线程来说都是**私有**的,通常用来保存需要频繁访问的线程私有变量。它的生命周期与线程相同——**一旦线程执行完毕,就不能再访问它的寄存器变量了。**
**寄存器溢出(register spilling):**寄存器数量是有限的(回忆第一篇:每线程最多256个矢量寄存器)。**如果使用了超过硬件限制数量的寄存器,则会用本地内存替代寄存器**——这种寄存器溢出会给性能带来不利影响。为什么不利?下一节讲本地内存时就会明白。
### 2.2 全局内存:最大、最常用、最慢
全局内存是DCU中容量最大、延迟最高、并且最常使用的内存。它常驻于DCU显存中。“全局”这个词有两层含义:**它贯穿于程序的整个生命周期,并且可以被任何设备(线程)访问**。前面写的核函数,就是在全局内存空间中运行的。全局内存可通过内存事务进行访问,这些内存事务**最好是4字节对齐**——这样可以利用全局内存**合并访存**的特性来减少访问次数。合并访存是全局内存优化的核心,我们放到第三篇专门讲。这里只需记住一句话:
> **优化全局内存事务,对于获得最优性能来说是至关重要的。**
### 2.3 共享内存:可编程的缓存
共享内存是HIP编程模型中提供的**可编程缓存**。在DCU上,每个CU都有一块共享内存,大小为**64 KB**,**其带宽和延迟远远优于全局内存**。它在核函数的范围内声明,是**线程之间相互通信的基本方式**。其生命周期伴随着整个线程块——一个块内的线程,通过使用共享内存中的数据可以相互合作。共享内存是本文的重点,第三、四节会专门展开。
### 2.4 本地内存:名字骗人,其实很慢
“本地内存”这个名字具有很强的误导性。听起来它应该离线程很近、很快,但事实恰恰相反:
> **本地内存,位于全局内存上的一个空间。在逻辑上,它属于线程私有,但物理上它和全局内存在同一块存储区域,因此高延迟、低带宽。**
它是怎么产生的?这就接上了2.1节的寄存器溢出:
* 当一个线程执行核函数时,核函数的变量、数组、结构体**首先会考虑放在寄存器中**。
* 但当定义的变量、数组、结构体**过大**,编译器判断这部分数据过度占用寄存器资源时,就会把它们**直接存放在本地内存中**。
换句话说:
```text
变量少,寄存器放得下 → 放寄存器(飞快)
变量多/数组大,寄存器放不下 → 溢出到本地内存(= 全局内存,很慢)
```
这就是为什么“寄存器溢出会损害性能”——**溢出的本质,是把本该在最快存储里的数据,踢到了最慢的存储里。**所以在核函数里定义大数组、大结构体时要格外小心。
## **三、共享内存与bank:一个“多体交叉存储器”**
现在进入本文的核心。共享内存之所以快,是因为它的物理结构是**并行的**;而它的坑,也正来自这个并行结构。学过计算机组成原理的读者会很快认出来:**共享内存的组织方式,本质上就是一个多体交叉存储器(interleaved memory)。**理解了这一点,bank冲突就不再是需要死记硬背的规则,而是一个必然的推论。
### 3.1 什么是bank
为了获得高内存带宽,共享内存被分成**32个同样大小的内存模块,称为存储体(Bank)**,它们**可以被同时访问**。这正是多体交叉存储器的思路:把一块内存拆成多个能独立、并行工作的体,只要访问落在不同的体上,就能同时进行,总带宽是单体的很多倍。官方教材给了一个很形象的比喻:
> 可以把存储体比喻为一串糖葫芦。每一根穿山楂的签子对应一个内存通道(Bank),每个山楂就是一个4字节的存储单元。
关键在于地址是**如何映射到bank的**——这就是“交叉”二字的含义:
> **共享内存是一个一维地址空间,以4字节为单位,地址【交错】分布在32个bank上。**也就是说:第0个4字节 → bank0,第1个 → bank1,……第31个 → bank31,第32个又回到bank0。
用组成原理的语言说,这是典型的**低位交叉编址**:地址的低位用来选bank,所以**连续的地址会被均匀打散到各个体上**。物理上,同一个bank里相邻的两个存储单元,在地址上正好相隔32(个单位)。
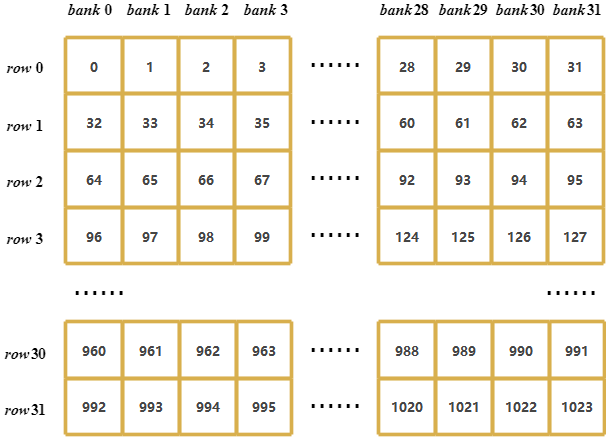
*图3-8 二维共享内存示意图(数字为元素的线性下标,列为bank)*
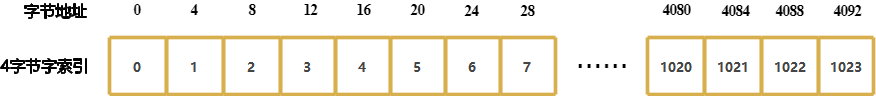
*图3-9 四字节数据排布示意图*
### 3.2 什么是bank冲突
> **如果通过线程束发布共享内存加载或存储操作,且在每个存储体上只访问不多于一个的内存地址,那么该操作可由一个内存事务来完成(最快)。否则,该操作由多个内存事务来完成——这种情况被称为Bank冲突,会降低内存带宽的利用率。**
翻译成组成原理的话:**多体交叉存储器的并行性,只有在各个请求分散到不同存储体时才能兑现;一旦多个请求撞进同一个体,这个体只能一次服务一个,退化成串行。**有两种典型的访问模式:
* **广播访问:**线程束里的多个线程访问**同一个bank的同一个地址**。这种情况硬件有优化,可以一次广播给所有线程,不算冲突。
* **串行访问:**多个线程访问**同一个bank的【不同】地址**。这就是冲突——当多个地址属于同一个bank时,必须以串行的方式逐个请求。
冲突的代价是线性叠加的。举个最坏的例子:
> **如果线程束中64个线程全都访问同一存储体中的不同内存地址,那么将需要64个内存事务,消耗的时间是单一请求的64倍。**
一个原本应该“一拍完成”的访问,硬生生变成了64拍。这就是为什么bank冲突是共享内存优化里最需要盯的东西。
> **一个wavefront=64带来的细节:**DCU的线程束是64个线程,而bank只有32个。所以一个线程束的共享内存访问,本身就要分成两拍(前32线程、后32线程)来处理。分析冲突时,通常以半个线程束(32线程)为单位来看是否撞bank。
### 3.3 一个真实的坑:按行访问 vs 按列访问
共享内存中,无论声明一维还是二维数组,实际存储都是线性排布的。两种静态声明:
```cpp
__shared__ int tile[N];
__shared__ int tile[Row][Col];
```
现在假设我们有一块 `tile[32][32]`的二维共享内存(就是图3-8那块),有两种访问方式:
```cpp
tile[threadIdx.y][threadIdx.x]; // 模式一
tile[threadIdx.x][threadIdx.y]; // 模式二
```
这两种写法只是把 `x`和 `y`换了个位置,看起来无伤大雅,性能却天差地别。原因在于**线程编号的增长规则**(第一部分讲过):**线程编号沿x、y、z依次递增**,所以相邻的线程,是 `threadIdx.x`相差1的线程。
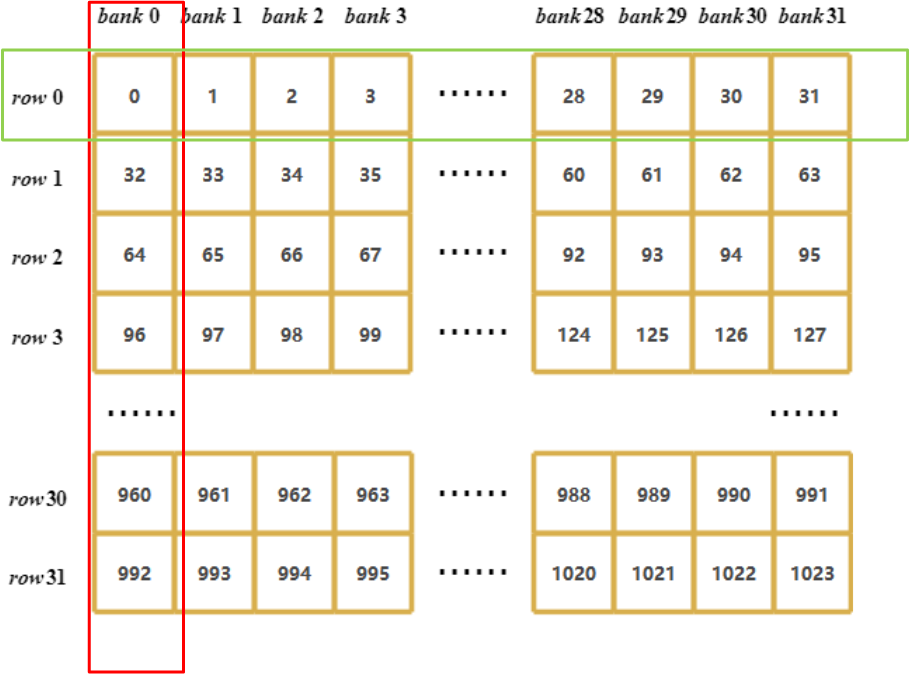
*图3-10 两种访问模式区别(绿色横框:模式一;红色竖框:模式二)*
**模式一 `tile[y][x]`(图中绿色横框):**相邻线程(x相差1)访问的是 `tile[y][0]`、`tile[y][1]`、`tile[y][2]`……也就是**同一行的相邻元素**。由图3-8,同一行的相邻元素正好落在**相邻的bank**上(bank0、bank1、bank2……)。于是32个相邻线程刚好铺满32个bank,**一个冲突都没有**。这是最优的访存方式。
**模式二 `tile[x][y]`(图中红色竖框):**相邻线程(x相差1)访问的是 `tile[0][y]`、`tile[1][y]`、`tile[2][y]`……也就是**同一列的不同行元素**。由图3-8,同一列的元素(0、32、64、96……)**全都落在同一个bank**上。于是32个相邻线程全部撞进同一个bank,**退化成32路串行**,带宽掉到1/32。
一句话总结这个规律:
> **让相同线程束中的线程访问不同的bank,是最优的访存方式。邻近线程在【内层维度(x)】访问相邻的单元,会因为产生更少的bank冲突而得到更好的性能。**
### 3.4 怎么规避:padding
那么模式二这种“天生要按列访问”的场景(比如矩阵转置)怎么办?**对于共享内存中的bank冲突,可通过转换全局内存和共享内存的索引来缓解。**而最常用的一招,就是第一篇提到过的**padding(填充)**。思路很直接:既然冲突来自“同一列的元素相隔32、正好同bank”,那我们就人为地把这个“32”破坏掉——把数组多开一列:
```cpp
__shared__ int tile[32][33]; // 33 而不是 32
```
这样一来,每一行占33个单位,同一列相邻两行的元素地址就相差**33**而不是32。33和32互质,于是原本挤在一个bank里的那一列元素,被均匀地错开到了不同的bank上,冲突消失。代价仅仅是每行多浪费一个元素的空间。这一招在矩阵转置、GEMM等需要按列访问共享内存的场景里几乎是标配。第三篇讲GEMM优化时会再用到它。
### 3.5 共享内存的价值
> **在核函数中使用共享内存,可以减少对全局内存的访问。**
把经常使用的数据先存进共享内存,利用它高带宽、低延迟的特性,当多次访问该数据时,所花的时间将远远小于访问全局内存。典型模式是:
```text
块内线程协作,把数据从【慢】的全局内存搬进【快】的共享内存(搬一次)
↓
__syncthreads() // 等所有线程都搬完
↓
之后所有计算都从共享内存读(读很多次)
```
**用“搬一次”换“读很多次的加速”——这就是共享内存优化的核心思想。**而bank冲突,是你在享受这份加速时必须绕开的坑。
## **四、修饰符:告诉编译器数据放哪**
### 4.1 存储修饰符
| **修饰符** | **变量放在** | **作用域** | **生命周期** |
| ---------------- | ------------------ | ---------------- | ------------------ |
| (无修饰符) | 寄存器 / 本地内存 | 线程 | 线程 |
| `__shared__` | 共享内存 | 线程块 | 线程块 |
| `__device__` | 全局内存 | 全局(所有线程) | 整个程序 |
对应的声明写法:
```cpp
float var; // 无修饰符 → 寄存器(或溢出到本地内存)
__shared__ float var; // 共享内存
__device__ float var; // 全局内存(静态声明)
```
三者的作用域和生命周期,恰好对应第一部分讲的三层结构:
* **寄存器 / 本地内存**的变量,仅作用于声明它的**线程**,与线程一起创建、一起消亡。
* **共享内存**的变量,作用于声明它的线程所在的**线程块**中的所有线程,与线程块一起创建、一起消亡。
* **全局内存**的变量,作用于当前程序中的**所有线程**,与整个应用程序一起创建、一起消亡。
**记住这个对应关系,你就能在写代码前就想清楚:这个数据该被谁看到、该活多久,从而选对修饰符。**
### 4.2 函数修饰符
| **限定符** | **执行位置** | **调用位置** | **备注** |
| ---------------- | ------------------ | -------------------- | ------------------------------------- |
| `__global__` | 设备端 | 主机端(也可设备端) | 核函数,返回类型必须为 `void`,异步 |
| `__device__` | 设备端 | 仅设备端 | 不能和 `__global__`同用 |
| `__host__` | 主机端 | 仅主机端 | 一般省略不写 |
几个要点:
* **`__global__`:**在设备上执行、从主机调用,返回类型**必须是 `void`**,不支持可变参数,不能是类成员函数。**注意它是异步的**(第一部分强调过)。
* **`__device__`:**在设备上执行、仅能从设备调用。常用来写“给核函数调用的辅助函数”。
* **`__host__`:**在主机上执行、仅能从主机调用,通常省略不写。
* **`__device__`和 `__host__`可以一齐使用**——这样函数会**同时**在主机端和设备端编译,一份代码两处可用。这在写既要给CPU、又要给DCU用的工具函数时很方便。
## **五、全局内存的管理**
### 5.1 查询、分配与释放
**查询**可用/总内存:
```cpp
hipError_t hipMemGetInfo(size_t *free, size_t *total);
// free: 当前可用内存的快照
// total: 设备上可分配的总内存
```
**分配**全局内存:
```cpp
hipError_t hipMalloc(void** ptr, size_t size);
// ptr: 返回该内存的地址
// size: 要分配的内存大小(设为0则不分配,ptr返回空地址)
```
**释放**全局内存:
```cpp
hipError_t hipFree(void *ptr);
```
### 5.2 Symbol:全局显存变量
除了动态分配,还有一种在**全局**声明显存变量的方式,叫**Symbol**,用 `__device__`修饰:
```cpp
__device__ float devdata;
```
它的初始化和读回,不能直接用 `hipMemcpy`(因为 `devdata`只是一个**标识物理位置的标识符**,不是普通的设备地址),而要用专门的接口:
```cpp
hipMemcpyToSymbol(devdata, &value, sizeof(float)); // 主机 → Symbol
hipMemcpyFromSymbol(&value, devdata, sizeof(float)); // Symbol → 主机
```
如果确实需要它的地址,可以显式获取:
```cpp
float *dptr = NULL;
hipGetSymbolAddress((void**)&dptr, devdata);
hipMemcpy(dptr, &value, sizeof(float), hipMemcpyHostToDevice);
```
Symbol适合那些**全局唯一、贯穿整个程序**的显存变量(比如某个常量表、某个全局计数器)。
## **六、页锁定内存:让传输更快的关键**
### 6.1 可分页内存 vs 页锁定内存
主机内存(被CPU访问的内存)分为两种:
* **可分页内存(pageable memory):**可能会被操作系统“页换出”(page out),即按系统要求把虚拟内存上的数据移到别处。**第一部分默认分配的 `malloc`内存就是这种。**
* **页锁定内存(page-locked / pinned memory):**被“固定”住,不会被页换出,地址是稳定的。
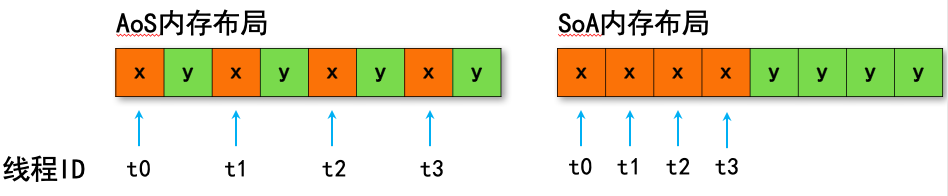
*图3-18 分页数据传输(左)和固定数据传输(右)*
**从可分页内存传输(图左):**因为可分页内存的地址随时可能变,DMA不敢直接用它。于是主机要先**分配一块临时的固定内存,把数据从可分页内存复制过去,再从这块固定内存传给设备**。多了一次主机内部的拷贝。**从页锁定内存传输(图右):**地址是固定的,DCU知道地址后可以用DMA**直接访问**,省去了中间那次拷贝。结论:
> **如果你需要频繁在主机端和设备端传输数据,使用页锁定内存对性能提升较大。**
### 6.2 页锁定内存的分配与释放
```cpp
hipError_t hipHostMalloc(void **ptr, size_t size, unsigned int flags); // 分配
hipError_t hipHostFree(void* ptr); // 释放
```
注意释放页锁定内存**必须**用 `hipHostFree`,不能用普通的 `free`。除了直接分配,你也可以把一块**已经分配好的可分页内存**注册成页锁定的:
```cpp
hipError_t hipHostRegister(void *hostPtr, size_t sizeBytes, unsigned int flags); // 注册
hipError_t hipHostUnregister(void *hostPtr); // 取消注册
```
### 6.3 三种特殊的锁页内存
| **flags** | **类型** | **用途** |
| ----------------------------- | -------------------------- | ---------------------------------------------------------------------------------------------------------------- |
| `hipHostAllocPortable` | 可共享锁页内存 | 允许被多个CPU线程访问,减少线程间的数据传输和通信(普通锁页内存只能由分配它的线程访问) |
| `hipHostAllocWriteCombined` | 写结合锁页内存 | CPU不再缓存这块内存、也不通过PCI-E监视它,从而**提高主机→设备的传输带宽**。适合“CPU只写、DCU来读”的数据 |
| `hipHostAllocMapped` | 映射锁页内存(零拷贝内存) | 主机和设备**共享**这块内存,核函数里可以**直接访问,不需要显式拷贝** |
这里解释一下**写结合内存**为什么能提速:一般情况下,CPU操作一块内存时,会把数据缓存到Cache并监视它是否被改动,以保证缓存一致性。但在异构计算中,要算的数据大多是给DCU用的,CPU根本不需要读它——那么这套缓存和监视就是纯开销。写结合内存告诉CPU“别缓存、别监视这块”,从而省下开销、提高传输带宽。
## **七、数据传输:同步与异步**
### 7.1 同步传输
```cpp
hipError_t hipMemcpy(void *dst, const void *src, size_t sizeBytes, hipMemcpyKind kind);
```
**同步**的含义:调用它时,**CPU端会被阻塞**,一直等到拷贝完成才执行下一步。`kind`指定方向,有四种:
| **kind** | **方向** |
| --------------------------- | -------------- |
| `hipMemcpyHostToHost` | 主机 → 主机 |
| `hipMemcpyHostToDevice` | 主机 → 设备 |
| `hipMemcpyDeviceToHost` | 设备 → 主机 |
| `hipMemcpyDeviceToDevice` | 设备 → 设备 |
两个坑要注意:
* **`dst`和 `src`不能重叠。**
* 如果指针方向和 `kind`指定的方向**不一致**,`hipMemcpy`的行为是**未定义的**——这是很隐蔽的bug来源。
### 7.2 异步传输
```cpp
hipError_t hipMemcpyAsync(void* dst, const void* src, size_t sizeBytes,
hipMemcpyKind kind, hipStream_t stream);
```
**异步**的含义:调用它时,**CPU端不受影响,控制权立即返回主机**;拷贝过程交给DMA管理。注意它多了第五个参数**`stream`(流)**。异步拷贝**需要配合流来使用**。要先创建一个非空流:
```cpp
hipError_t hipStreamCreate(hipStream_t* stream);
```
之后这个流就可以作为参数供 `hipMemcpyAsync`等异步API使用。**异步传输是实现“计算与传输重叠”的基础**——这正是第一部分那张流程图里“进阶路径”要走的路,完整机制会在下一部分《并发执行》里详细讲。这里先埋下一个引子:有了页锁定内存(第六节)+ 异步传输 + 流,你就能让“搬数据”和“算数据”同时进行,把PCI-E传输的时间藏掉。
### 7.3 一个测带宽的小例子
```cpp
hipEventRecord(start);
hipMemcpy(d_x, x, N * sizeof(float), hipMemcpyHostToDevice);
hipEventRecord(stop);
// ... 计算 start 到 stop 的耗时 milliseconds ...
printf("Effective Bandwidth (GB/s): %f\n", N * 4 / milliseconds / 1e6);
```
这个“有效带宽 = 传输字节数 ÷ 耗时”的思路,是性能分析的基本功——第五部分讲性能分析、第三篇讲decode优化时,我们都会反复用到它。
## **八、数据布局:AoS还是SoA**
最后讲一个和“合并访存”密切相关的话题——数据的组织方式。它决定了你的全局内存访问效率。
存储结构化数据时,有两种组织方式:
* **AoS(Array of Structure,结构体数组):**先定义结构体,再开一个结构体的数组。
* **SoA(Structure of Array,数组结构体):**每个字段各自成一个数组。
以“成对的整型数据(x, y)”为例:
```cpp
// AoS:结构体数组
struct inStruct { int x; int y; };
struct inStruct myAoS[N]; // 内存里:x y x y x y x y ...
// SoA:数组结构体
struct inArray { int x[N]; int y[N]; };
struct inArray mySoA; // 内存里:x x x x ... y y y y ...
```
*图3-21 AoS和SoA内存布局*
**为什么这对DCU很关键?**假设有一个应用只需要处理 `x`字段,让线程t0、t1、t2、t3分别去取自己的x:
* **AoS布局**(`x y x y ...`):线程们要取的x之间**隔着y**,不连续。DCU取数据时,会把夹在中间的y也**隐式地一起加载**进来——这既浪费了带宽,又浪费了缓存空间。
* **SoA布局**(`x x x x ...`):线程们要取的x**紧挨在一起**。DCU可以把这一串连续的x用一次合并访存全部取回,**带宽被充分利用**。
结论:
> **在DCU上,SoA内存布局提供了合并内存访问,可以对全局内存实现更高效的利用。**
这和CPU的直觉正好相反:AoS在CPU上通常有良好的缓存局部性(一个对象的x、y挨在一起,一次缓存行就都拿到了),所以CPU程序常用AoS。但到了DCU上,因为是“很多线程各取同一字段”,**SoA往往才是更优的选择**。这是从CPU迁移过来时一个需要重新校准的直觉。
## **小结**
本文把“数据放在哪、怎么放、怎么搬”讲了一遍,核心要点:
**第一,存储分可编程和不可编程。**寄存器、共享内存、全局内存是你能控制的;L1/L2缓存是硬件自动管的。多出来的这份控制权,是DCU高性能的来源,也是它难写的原因。
**第二,四种存储各有脾气。**寄存器最快但会溢出;全局内存最大最慢;共享内存是“可编程的缓存”,快且可控;本地内存名字骗人,物理上就是全局内存,是寄存器溢出的去处。
**第三,共享内存就是一个多体交叉存储器。**它按4字节交叉分布在32个bank上。访问落在不同bank上时并行(最快),多个访问撞进同一bank时串行(bank冲突,最坏1/32带宽)。`tile[y][x]`按行访问无冲突,`tile[x][y]`按列访问全冲突;用padding(多开一列)可以错开bank化解冲突。
**第四,传输性能藏在两个细节里。**用**页锁定内存**省掉中间拷贝、让DMA直接访问;用**异步传输 + 流**让计算与传输重叠。而**数据布局用SoA**能换来合并访存——这和CPU偏爱AoS的直觉相反。
## **参考文献**
* [DCU编程与优化基础系列——CSDN博客](https://blog.csdn.net/Sakurahello1/article/details/162946708?sharetype=blogdetail&sharerId=162946708&sharerefer=PC&sharesource=Sakurahello1&spm=1011.2480.3001.8118 "DCU编程与优化基础系列——CSDN博客")
* [海光DCU官方技术文档——SourceFind开发者平台](https://developer.sourcefind.cn/document/a2e964e8-a67d-11f0-909a-b6dd5499a79e?id=e309f137-ad86-11f0-846a-2e5fc4af73a0&title=3.1+%E7%BC%96%E5%86%99%E7%AC%AC%E4%B8%80%E4%B8%AADCU%E7%A8%8B%E5%BA%8F&version=a2e964e8-a67d-11f0-909a-b6dd5499a79e "海光DCU官方技术文档——SourceFind开发者平台")
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据