1
2
0
5
系列第二篇 · 第一部分:跑通第一个 DCU 程序,并彻底理解线程是如何被组织和执行的
2026-09-20 19:40:12
44
> *系列第二篇 · 第一部分*
> 本系列共三篇:①硬件架构 → **②编程与优化基础** → ③Qwen3.5 推理优化实战
>
> 第二篇篇幅较长,分为若干部分。本文是第一部分:**跑通第一个 DCU 程序,并彻底理解线程是如何被组织和执行的**。
>
> 阅读本文不需要 GPU 编程经验,但建议先读过第一篇《DCU 架构详解》——本文会多次用到其中的 CU、SIMD、线程束等概念。
---
## 引言
第一篇我们把 DCU 的硬件拆开看了一遍:数千个计算核心、CU 与 SIMD、寄存器与共享内存、以及"延迟靠并发来掩藏"的核心机制。
这一篇开始写代码。
本文要回答两个问题:
1. 一个 DCU 程序长什么样?**它和 CPU 程序的区别在哪里,怎么编译、怎么确认它真的跑在 DCU 上。
2. `threadIdx.x + blockIdx.x * blockDim.x` 到底是什么?**这行代码几乎出现在每一个 DCU 程序里。看懂它,就看懂了 DCU 的执行模型。
顺序上,我们先建立最关键的那个观念转变,再看代码。
---
## 一、思维方式的转变:从"一个人做一万次"到"一万个人各做一次"
这是学习 DCU 编程要跨过的**第一道、也是最高的一道坎**。它不是语法问题,是思考方式的问题。
先看一个最普通的需求:两个数组相加,`C[i] = A[i] + B[i]`,数组长度是 10000。
在 CPU 上,你会很自然地写一个循环:
```c
for (int i = 0; i < N; i++) {
C[i] = A[i] + B[i];
}
```
这段代码的含义是:**一个执行者,依次做一万次加法**。
而在 DCU 上,思路要反过来。你不再描述"整件事怎么做完",而是描述:
> **假设我是其中一个线程,我该做什么?**
答案是:*"我只负责一个位置。我先搞清楚自己是第几号线程,然后把 A、B 中对应位置的两个数加起来,写进 C 的对应位置。做完就结束。"*
然后,你一次性启动一万个这样的线程,让它们**同时**各做一次加法。
用官方的表述:
> "从 CPU 编程到 DCU 编程,你最需要转换的是你的思考方式。在设计核函数时,你需要站在一个线程的角度去思考你的问题如何被分解为一个个相似的小问题,而每一个小问题需要一个线程去做什么样的事情来解决它。"
这个转变可以概括成一句话:
| | CPU | DCU |
| ------------------ | -------------------------------- | ---------------------------------- |
| 你写的代码描述的是 | **整个任务**(循环一万次) | **一个线程的职责**(做一次) |
| 谁来重复 | 你写的循环 | **硬件启动一万个线程** |
| 形象比喻 | 一个人做一万次 | 一万个人各做一次 |
这个观念一旦建立,后面的一切——线程编号、线程块、线程束——都只是在回答同一个问题的细节:**"我是谁?我该处理哪个数据?"**
---
## 二、第一个 DCU 程序:数组相加
学习 CPU 平台上的编程语言,第一个程序一般是 "Hello world!"。但鉴于 DCU 多任务数据处理架构的特点,我们的第一个 DCU 程序换一个更贴合的例子——**两数组相加**:数组 A 与数组 B 相加,结果赋值给数组 C。
这个程序足够简单,但它能让你掌握 DCU 编程的基本方法、了解 DCU 编程和 CPU 编程之间的重要差别,以及编译运行的方法。
### 2.1 CPU 版本
先看 C 语言版本,就是一个 for 循环的简单程序:
```c
#include
#define N 10000
int main() {
// 申请数据空间
float *A = (float *) malloc(N * sizeof(float));
float *B = (float *) malloc(N * sizeof(float));
float *C = (float *) malloc(N * sizeof(float));
// 数据初始化
for (int i = 0; i < N; i++) {
A[i] = 1;
B[i] = 1;
C[i] = 0;
}
// 进行数组相加
for (int i = 0; i < N; i++) {
C[i] = A[i] + B[i];
}
free(A);
free(B);
free(C);
return 0;
```
CPU 程序采用 gcc 编译器编译。假设文件名为 `vector_add_cpu.cpp`,在 Linux 平台下用下面的命令编译:
```bash
gcc vector_add_cpu.cpp -o vector_add_cpu
```
运行后就可以看到 C 数组内的值都被置为了 2,数组相加完成。
### 2.2 DCU 版本
接下来看 DCU 版程序。**先不用急着看明白每一行的意思**,后面会详细拆解:
```cpp
#include
#include "hip/hip_runtime.h"
#include
#define N 10000
__global__ void add(float *d_A, float *d_B, float *d_C) {
int tid = threadIdx.x + blockIdx.x * blockDim.x;
if (tid < N) {
d_C[tid] = d_A[tid] + d_B[tid];
}
}
int main() {
// 申请数据空间
float *A = (float *) malloc(N * sizeof(float));
float *B = (float *) malloc(N * sizeof(float));
float *C = (float *) malloc(N * sizeof(float));
float *d_A = NULL;
float *d_B = NULL;
float *d_C = NULL;
hipMalloc((void **) &d_A, N * sizeof(float));
hipMalloc((void **) &d_B, N * sizeof(float));
hipMalloc((void **) &d_C, N * sizeof(float));
// 数据初始化
for (int i = 0; i < N; i++) {
A[i] = 1;
B[i] = 1;
C[i] = 0;
}
hipMemcpy(d_A, A, sizeof(float) * N, hipMemcpyHostToDevice);
hipMemcpy(d_B, B, sizeof(float) * N, hipMemcpyHostToDevice);
hipMemcpy(d_C, C, sizeof(float) * N, hipMemcpyHostToDevice);
dim3 blocksize(256, 1);
dim3 gridsize(N / 256 + 1, 1);
// 进行数组相加
add<<>>(d_A, d_B, d_C);
// 结果验证
hipMemcpy(C, d_C, sizeof(float) * N, hipMemcpyDeviceToHost);
for (int i = 0; i < N; i++) {
std::cout << C[i] << std::endl;
}
// 释放申请空间
free(A);
free(B);
free(C);
hipFree(d_A);
hipFree(d_B);
hipFree(d_C);
```
**注意那个 `for` 循环消失了。** 它被 `add<<>>(...)` 这一行取代——这正是第一节说的转变:循环不再由你写,而是由硬件启动的成千上万个线程"并行地"完成。
### 2.3 编译
DCU 程序需要采用专用的编译器 **hipcc** 进行编译,编译出的二进制代码可以被设备端加载运行。编译命令与 gcc 相似:
```bash
hipcc vector_add_dcu.cpp -o vector_add_dcu
```
编译后运行,如果成功,应该会在屏幕上看到 2 这个数字不断被打印。
**到这里你已经运行了第一个 DCU 程序。** 抛开代码来看,编译方法上二者似乎并没有什么区别,仅仅是更换了编译器。
### 2.4 怎么确认它真的跑在 DCU 上?
答案是使用 **`rocm-smi`** 命令。
它的作用与 Linux 上的 `top` 命令类似——`top` 看 CPU 负载,`rocm-smi` 看 DCU 负载(当然它还有更多用途)。在执行上面程序的同时使用 `rocm-smi`,可以实时监控 DCU 负载情况。
输出中:第一列是 DCU 的序号(如果你的机器里有不止一块 DCU 就会有多行),`%DCU` 列代表 DCU 的实时负载。运行程序时,可以看到第一块 DCU 处于满载状态——这就证明计算确实发生在 DCU 上。
---
## 三、拆解:一个 HIP 程序的四个部分
运行完程序,回头对比 CPU 端和 DCU 端的代码,会发现二者还有不小的区别。这些区别可以归纳为四个部分。
### 3.1 空间管理:显存是独立的
首先要明确一点:**数组相加最开始的输入数据和输出数据都是在 CPU 端初始化的**,这些数据一开始都在主机内存当中。
而 DCU 要参与计算,就必须拿到这些数据。要实现这一目的,需要:
1. 在 **DCU 的显存**上开辟一块空间(大小与 CPU 端内存相对应);
2. 经过 **PCI-E 总线**将数据传输到 DCU 当中。
这正对应第一篇讲过的硬件事实:**DCU 有独立于主机内存的全局内存**,两者通过 PCI-E 相连。CPU 的指针和 DCU 的指针指向的是**两个完全不同的地址空间**——这就是为什么代码里既有 `A`(主机)又有 `d_A`(设备),`d_` 前缀是一个约定俗成的命名习惯,用来提醒你"这是设备端的指针"。
与 CPU 内存管理类似,调用 **`hipMalloc`** 就可以完成 DCU 内存分配:
```cpp
hipMalloc((void **) &d_A, N * sizeof(float))
```
`hipMalloc` 是最基础的内存分配接口,此外还有一些其他的内存分配方式(例如页锁定内存),这部分将在后续部分介绍。
HIP 程序其实是 C 程序的一种扩展,所以同样需要注意管理空间的申请和释放以防止内存泄露。程序结束前要用 **`hipFree`** 释放显存:
```cpp
hipFree(d_A);
```
### 3.2 数据拷贝:注意方向
完成空间申请后,下一步就是把 CPU 端准备好的数据传输给 DCU 显存,使用 **`hipMemcpy`** 完成:
```cpp
hipMemcpy(d_A, A, sizeof(float) * N, hipMemcpyHostToDevice);
```
需要注意的是,**`hipMemcpy` 具有方向性**。最后一个参数指示了方向:
| 参数 | 含义 |
| ------------------------- | ---------------- |
| `hipMemcpyHostToDevice` | 主机端 → 设备端 |
| `hipMemcpyDeviceToHost` | 设备端 → 主机端 |
计算完成后,结果还在显存里,必须再拷回主机才能打印:
```cpp
hipMemcpy(C, d_C, sizeof(float) * N, hipMemcpyDeviceToHost);
```
### 3.3 函数定义:核函数
```cpp
__global__ void add(float *d_A, float *d_B, float *d_C)
```
**`__global__` 是一个函数标识符**,它代表:**这个函数在主机端被调用,但执行是在设备端**。这个标识符会被 hipcc 编译器识别到,然后按照 DCU 端的指令去翻译下面的代码段。
被 `__global__` 标识的函数又被称为**核函数**或 **"kernel"**。核函数代表了设备端的入口——**一旦进入核函数,函数的执行和控制就交给了设备端**。
除了 `__global__`,HIP 还有其他标识符提供给开发者使用,通过标识符可以管理设备端的存储,并让开发者有更灵活的程序设计方式。这些内容会在后续部分详细介绍。
进入核函数体中:
```cpp
int tid = threadIdx.x + blockIdx.x * blockDim.x; // ① 我是谁?
if (tid < N) { // ② 越界了吗?
d_C[tid] = d_A[tid] + d_B[tid]; // ③ 干活
```
三步:
1. 首先使用 `threadIdx.x`、`blockIdx.x`、`blockDim.x`**定位当前的线程编号**,根据线程编号算出当前线程读取数据的偏移地址;
2. 接着判断线程索引的数据**是否超越数据边界**;
3. 如果没有超过,运行核函数真正的计算逻辑,进行数据相加。
**第 ① 步具体是什么意思?这正是第四节要回答的问题。**
### 3.4 函数执行:三个尖括号
```cpp
dim3 blocksize(256, 1);
dim3 gridsize(N / 256 + 1, 1);
add<<>>(d_A, d_B, d_C);
```
核函数需要采用**三个尖括号**的方式调起。一旦调用起来,设备端就会自动创建 **`gridsize × blocksize`** 数量的线程。
这些线程如何被组织,第四节会讲。这里只需要知道:**一共有 `gridsize × blocksize` 个线程都会运行 `add` 函数的代码**,括号里的参数就是执行该函数时需要的数据。
这些启动的线程将会被**设备端的调度器分配到众多的计算核心中运行**,从而实现并行化。**这一点就是 DCU 能实现计算加速的关键。**
#### 一个必须知道的陷阱:核函数调用是异步的
这里有一个初学者极易踩的坑:
> **核函数被调用后,执行权限交给设备端,但主机端【不会】等待核函数执行完毕再执行下面的代码,而是立刻往下执行。**
也就是说,**主机端和设备端是异步的**。
这意味着:如果你想给核函数计时,在 `add<<<...>>>(...)` 这一行的前后各取一次时间,你会测出一个接近于 0 的数值——因为主机根本没等它算完就往下跑了,你测的只是"发出命令"的时间,不是"执行完成"的时间。
那为什么上面的程序还能打印出正确的结果?因为紧接着的那句 `hipMemcpy`**是隐式同步的**:一旦主机端遇到 `hipMemcpy`,就会等待设备端的所有操作(包括核函数执行、数据传输)执行完毕以后才会往下执行。
这样会效率低下吗?当然会。不过 HIP 也具有异步拷贝功能,这需要配合"**流**"来使用——通过这个技术可以同时启动多个核函数、多个拷贝,剩下的就交给设备端调度执行。这部分内容会在本篇的"并发执行"部分详细展开。
---
## 四、执行模型:`threadIdx.x` 到底是什么
现在回答那个悬而未决的问题。
### 4.1 三层组织:网格、线程块、线程
当核函数被调用起来后,会自动启动数千个线程来执行核函数的代码。这些线程不是平铺的一大堆,而是被组织成**三个层次**:
```
网格 Grid(一次核函数调用启动的全部线程)
└── 线程块 Block(线程的分组)
└── 线程 Thread(最小执行单位)
```
回到三个尖括号:
```cpp
add<<>>(d_A, d_B, d_C);
// ↑ 第一个参数 ↑ 第二个参数
// 启动多少个线程块 每个线程块里有多少线程
```
* **第二个参数 `blocksize`**:配置**线程块的大小**(每块多少线程);
* **第一个参数 `gridsize`**:配置**一共启动多少个线程块**。
例如 `gridsize` 为 1、`blocksize` 为 256,翻译过来就是一共启动 `1 × 256` 个线程来执行 `add` 的代码。
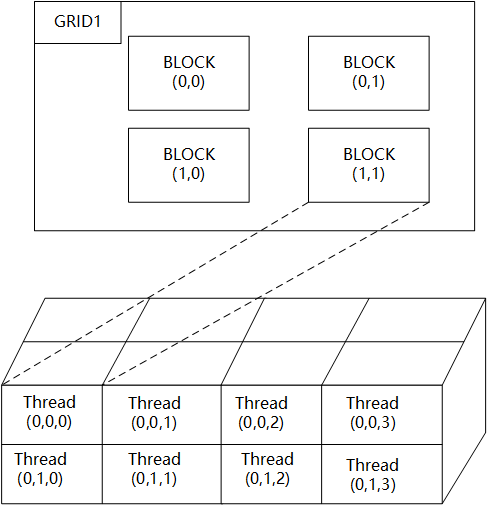
*图 3-3 多维线程组织模型*
图 3-3 展示了这种层次关系:一个 GRID 中包含多个 BLOCK,每个 BLOCK 中又包含多个 Thread。
#### 为什么要分成两层?
初学者常有的疑问是:既然最终就是一堆线程,为什么不直接说"启动 10000 个线程",非要分成"40 个块 × 256 个线程"?
原因在于:**线程块是硬件调度和资源分配的单位**。
回忆第一篇的内容:
* **一个线程块只能在一个 CU 上被调度**,一旦被调度到某个 CU 上,就会保存在该 CU 上直到执行完成;
* CU 上的**共享内存**被分配给该 CU 上的常驻线程块,**寄存器**被分配给线程;
* 同一个块里的线程,因为共处一个 CU,**可以通过共享内存相互合作和通信**。
所以"块"不是一个多余的抽象,它对应着实实在在的硬件边界:**块内的线程能协作,块之间基本各干各的。** 你把多少线程放进一个块,直接决定了这个块要吃掉 CU 上多少资源——这一点会在第六节(占用率)变得非常重要。
### 4.2 多维组织与 `dim3`
线程块在逻辑上可以被配置为**一维、二维或三维**。
如果需要使用多维线程组织模型,在设置 `gridsize` 和 `blocksize` 时就需要配置为 **`dim3`** 类型:
```cpp
dim3 dimGrid(90, 90); // 网格:x 轴 90 个块,y 轴 90 个块
dim3 dimBlock(64, 1); // 每个块:64 个线程
hipLaunchKernelGGL(myGpuMatrix, dimGrid, dimBlock, 0, 0, dev_A, dev_B, dev_C_t);
```
`dim3` 是基于 `uint3` 指定维度的整数向量类型,分别用 `x`、`y`、`z` 来表示网格三个维度上线程块的个数,或者线程块三个维度上线程的个数。**`x`、`y`、`z` 中未指定的任何部分默认初始化为 1**,结构体定义如下:
```cpp
typedef struct dim3 {
uint32_t x;
uint32_t y;
uint32_t z;
dim3(uint32_t _x = 1, uint32_t _y = 1, uint32_t _z = 1) : x(_x), y(_y), z(_z) {};
};
```
> **注意**:上面出现了两种启动核函数的写法——三尖括号 `add<<>>(...)` 和 `hipLaunchKernelGGL(kernel, grid, block, 0, 0, ...)`。两者等价,后者是 HIP 提供的宏形式,多出的两个参数分别是动态共享内存大小和流(stream),暂时填 0 即可,后续部分会讲。
#### 维度只是给你看的
这里有一个重要的观念:
> **所谓的维度,其实是人为的一种划分。在执行时,线程都被组织成一维形式。**
这个概念就好像我们用 C 语言申请了一个二维数组 `a[N][M]`:虽然使用时有"维度"这个概念,但在物理空间中这些数据其实是**连续存储**的。我们当然可以用一维数组去替代二维的,只要计算好偏移就可以。
线程也是一样。**多维只是为了让你的代码更贴合问题的形状**(比如处理图像时用二维更自然),硬件并不在乎。
在一个块中每个线程都有唯一 ID。如果将 **x 作为第一个维度(最内层)、y 作为第二个维度、z 作为第三个维度(最外层)**,那么不管是二维还是三维线程块,都可以转化为一维线程布局。
**线程的增长方向是沿着 x、y、z 依次递增**——这个规则就像在访问一个二维或三维数组一样。记住这一点,后面讲共享内存的 bank 冲突时还会用到。
### 4.3 索引计算:回答"我是谁"
现在可以看懂那行代码了:
```cpp
int tid = threadIdx.x + blockIdx.x * blockDim.x
```
三个内置变量的含义:
| 变量 | 含义 |
| --------------- | ---------------------------------------- |
| `threadIdx.x` | 当前线程**在它所属的块内**的编号 |
| `blockIdx.x` | 当前**块**在网格内的编号 |
| `blockDim.x` | **每个块的大小**(块里有多少线程) |
所以这个公式的逻辑是:
```
全局编号 = 我前面有多少个完整的块 × 每块的线程数 + 我在本块内排第几
= blockIdx.x × blockDim.x + threadIdx.x
```
举个具体的例子:`blockDim.x = 256`,当前线程在 **2 号块**的 **5 号位**上,那么它的全局编号就是 `5 + 2 × 256 = 517`。它负责处理 `A[517] + B[517]`。
由于 GRID 和 BLOCK 的大小和维度可以自由组合,就会形成不同的线程索引方式:
| 组合 | 线程全局 ID 计算式 |
| ----------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 1D grid, 1D block | `blockIdx.x * blockDim.x + threadIdx.x` |
| 1D grid, 2D block | `blockIdx.x * (blockDim.x * blockDim.y) + blockDim.x * threadIdx.y + threadIdx.x` |
| 3D grid, 1D block | `(gridDim.x * gridDim.y * blockIdx.z + gridDim.x * blockIdx.y + blockIdx.x) * blockDim.x + threadIdx.x` |
| 3D grid, 3D block | `(gridDim.x * gridDim.y * blockIdx.z + gridDim.x * blockIdx.y + blockIdx.x) * (blockDim.x * blockDim.y * blockDim.z) + blockDim.x * blockDim.y * threadIdx.z + blockDim.x * threadIdx.y + threadIdx.x` |
公式看着吓人,但本质都一样:**先算出"我所在的块前面有多少个线程",再加上"我在块内的位置"**。而块内位置的计算,又遵循 x 最内、z 最外的规则。
### 4.4 为什么必须有边界检查
```cpp
if (tid < N) { ... }
```
这句看似多余的判断,其实是必需的。原因藏在启动配置里:
```cpp
dim3 gridsize(N / 256 + 1, 1); // N = 10000
```
`10000 / 256 = 39.06`,C 语言的整数除法会截断为 **39**,加 1 得到 **40** 个块。于是实际启动的线程数是:
```
40 × 256 = 10240 个线程
```
比 N = 10000 **多出了 240 个**。
这多出来的 240 个线程,它们的 `tid` 从 10000 一直排到 10239。如果不加边界检查,它们就会去读写 `d_A[10000]` 这种**根本不存在的位置**——轻则算出垃圾数据,重则程序崩溃。
这是 DCU 编程的一个常规操作:**因为线程数通常要凑成块的整数倍,几乎总会启动比实际需要更多的线程,所以核函数里几乎总要写一句边界检查。**
---
## 五、硬件的真相:线程束(wavefront)
到这里,你已经能写出正确的 DCU 程序了。但要写出**快**的程序,还得再往下看一层——**硬件其实并不按"线程块"来执行**。
### 5.1 逻辑视图 vs 硬件视图
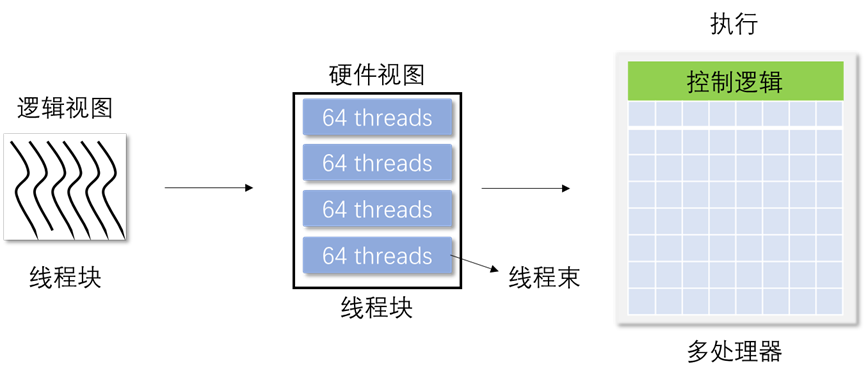
*图 3-5 线程块逻辑视图与硬件视图关系图*
图 3-5 展示了这层关系:
* **逻辑视图**(你写代码时的视角):线程块是一堆线程的集合,可以是一维、二维或三维;
* **硬件视图**(硬件执行时的视角):**线程块是一维线程束的集合**——每 64 个连续的线程组成一个**线程束**;
* **执行**:线程束被送到多处理器(CU)上执行。
用一句话概括:
> **从逻辑角度看,线程块是线程集合,可以被组织为一维、二维或三维布局;但从硬件角度看,线程块是一维线程束的集合,在线程块中线程被组织成一维布局,每 64 个连续线程组成一个线程束。**
这就是第一篇讲过的 **wavefront**:一个线程束中的所有线程按**单指令多线程(SIMT)**方式执行——**它们步调一致,同一时刻执行同一条指令**。
**核函数启动后的完整链条是这样的:**
```
核函数启动
→ 产生大量线程,按你的配置分成若干线程块
→ 线程块被分发到各个 CU 上(一个块只去一个 CU)
→ 到了 CU 上,块内线程被切成一个个 64 线程的线程束
→ 线程束被 SIMD 调度执行
```
### 5.2 凑不满 64 会浪费
既然硬件按 64 个线程一束来切,那么如果**线程块大小不是线程束大小的整数倍**,会发生什么?
答案是:**那些除以 64 余下的线程,依然会组成一个线程束。**
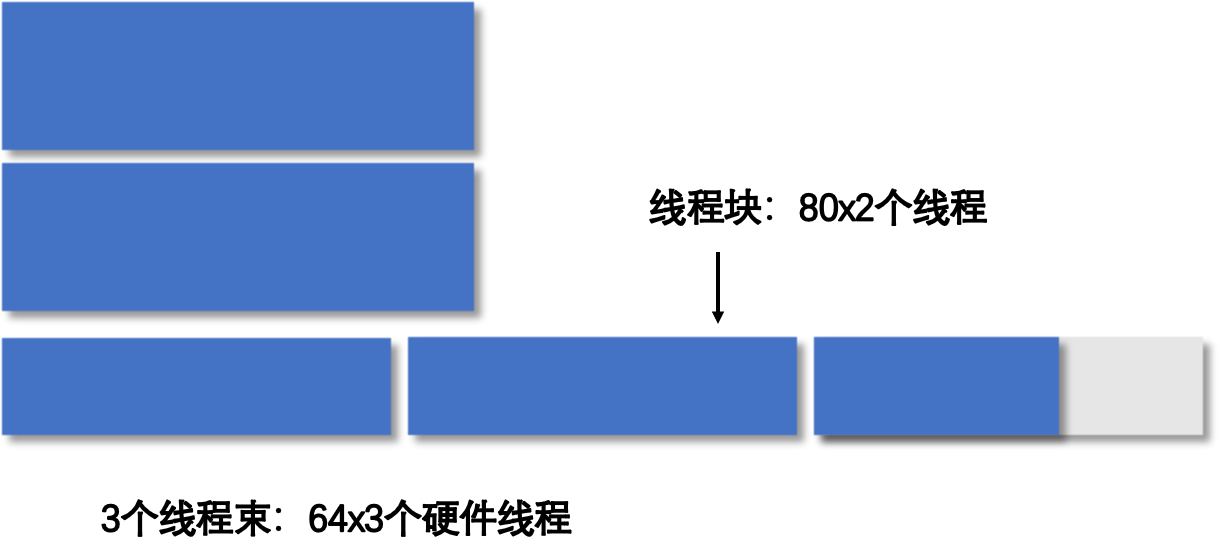
*图 3-4 线程束分配示意图*
图 3-4 给了一个具体例子:一个 x 轴为 80、y 轴为 2 的二维线程块,整个块中有 **160 个线程**。
```
160 ÷ 64 = 2 余 32
```
所以它会被切成 **3 个线程束**:前两个各装满 64 个线程,最后 32 个线程单独组成第三个线程束。
问题在于:**这最后一个只装了 32 个线程的线程束,却要占用 64 个线程的调度资源和存储资源。** 图中灰色的那半截就是被白白占掉、却什么也不干的部分。
```
你以为启动了:160 个线程
硬件实际占用:64 × 3 = 192 个线程的资源
浪费:32 个槽位(约 17%)
```
**所以这种现象的发生会降低性能。** 这也就直接推出了那条最基本的配置原则:
> **保持每个块中的线程数量是 64 的倍数。**
### 5.3 线程束分化:if / else 的代价
线程束"步调一致"的特性带来了另一个后果。
**在同一线程束中的线程执行不同的指令,被称为线程束分化(divergence)**,这种情况最常见于程序中的 `if` 和 `else`。
因为 **DCU 没有类似 CPU 那样复杂的分支预测机制**,所以在一个指令周期中,**只有满足条件的线程才会执行,不满足条件的线程什么都不做、等待其他线程执行完毕**,然后同一个线程束内的线程继续同步往下执行。
看这段代码:
```c
A;
if (threadIdx.x < 4)
{ B; }
else
{ C; }
A;
```
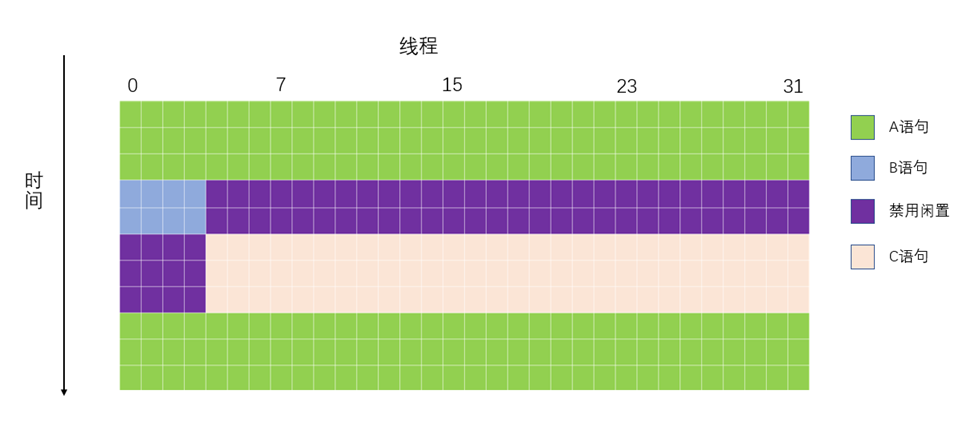
*图 3-6 线程束分化*
图 3-6 以 32 个线程为例展示了执行过程(时间自上而下):
1. **A 语句**:线程束中所有线程都执行,没有分歧。
2. **分支 B 和 C**:条件 `threadIdx.x < 4` 将线程束分成了两派。前 4 个线程走 `B`,后 28 个线程走 `C`。硬件先执行 `B`(前 4 个线程干活,后 28 个等待),再执行 `C`(后 28 个线程干活,前 4 个等待)。**两条路径串行执行**,总耗时翻倍。
3. **A 语句**:分歧结束,所有线程再次同步执行。
这就是线程束分化的代价:**本该并行执行的线程,因为分支而被迫串行化**。如果分支条件在同一个线程束内差异很大,性能会显著下降。
避免线程束分化的常见策略包括:
* **让分支条件与线程束边界对齐**:例如用 `threadIdx.x / 64` 代替 `threadIdx.x < 4`,使整个线程束走同一条路径;
* **用数据预处理代替分支**:将条件判断提前到数据准备阶段,核函数内只做统一计算;
* **减少分支深度**:尽量用三元运算符或简单算术代替深层 `if/else` 嵌套。
线程束分化是 DCU 编程中一个重要的性能考量因素。理解它,就能写出既正确又高效的核函数。
---
## 六、总结
本文从零开始,带你跑通了第一个 DCU 程序,并深入理解了线程的组织和执行模型。回顾一下关键点:
1. **思维转变**:从 CPU 的“一个人做一万次”到 DCU 的“一万个人各做一次”,是学习 DCU 编程的第一道坎。
2. **HIP 程序的四个部分**:空间管理(`hipMalloc`)、数据拷贝(`hipMemcpy`)、核函数定义(`__global__`)、核函数执行(`<<>>`)。
3. **执行模型**:线程被组织为网格→线程块→线程三层结构。`threadIdx.x + blockIdx.x * blockDim.x` 是计算全局线程编号的核心公式。
4. **边界检查**:因为线程数要凑成块的整数倍,几乎总会启动多余线程,所以核函数里必须写边界检查。
5. **线程束**:硬件按 64 个线程为一束执行。块大小要是 64 的倍数,避免浪费;分支要尽量对齐线程束边界,避免分化。
掌握了这些基础,下一篇我们将进入更深入的优化话题:**共享内存、同步原语、以及如何通过调整线程块大小来提升占用率**。敬请期待。
---
## 参考文献
1. [DCU 架构详解 - CSDN博客](https://blog.csdn.net/Sakurahello1/article/details/162946770?spm=1011.2124.3001.6209 "DCU 架构详解 - CSDN博客")
2. [编写第一个 DCU 程序 - 开发者源文档](https://developer.sourcefind.cn/document/a2e964e8-a67d-11f0-909a-b6dd5499a79e?id=e309f137-ad86-11f0-846a-2e5fc4af73a0&title=3.1+%E7%BC%96%E5%86%99%E7%AC%AC%E4%B8%80%E4%B8%AADCU%E7%A8%8B%E5%BA%8F&version=a2e964e8-a67d-11f0-909a-b6dd5499a79e "编写第一个 DCU 程序 - 开发者源文档")
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据