glmos-code-explain
在大模型预训练精度遇到Scaling Laws撞墙之后,最近人们发现让模型step-by-step进行思考能明显提高大模型的推理能力,通过提示的方式实现该目标的策略称为chain-of-thought prompt,然而,问题也随之而来,多步思考的方式导致模型回答问题的时间显著增长,而且提问者也不想去看模型那冗长的“思考”过程。要不要换个“思考”方式?干脆不思考了吧,直接show答案不就行了!
一、思考方式
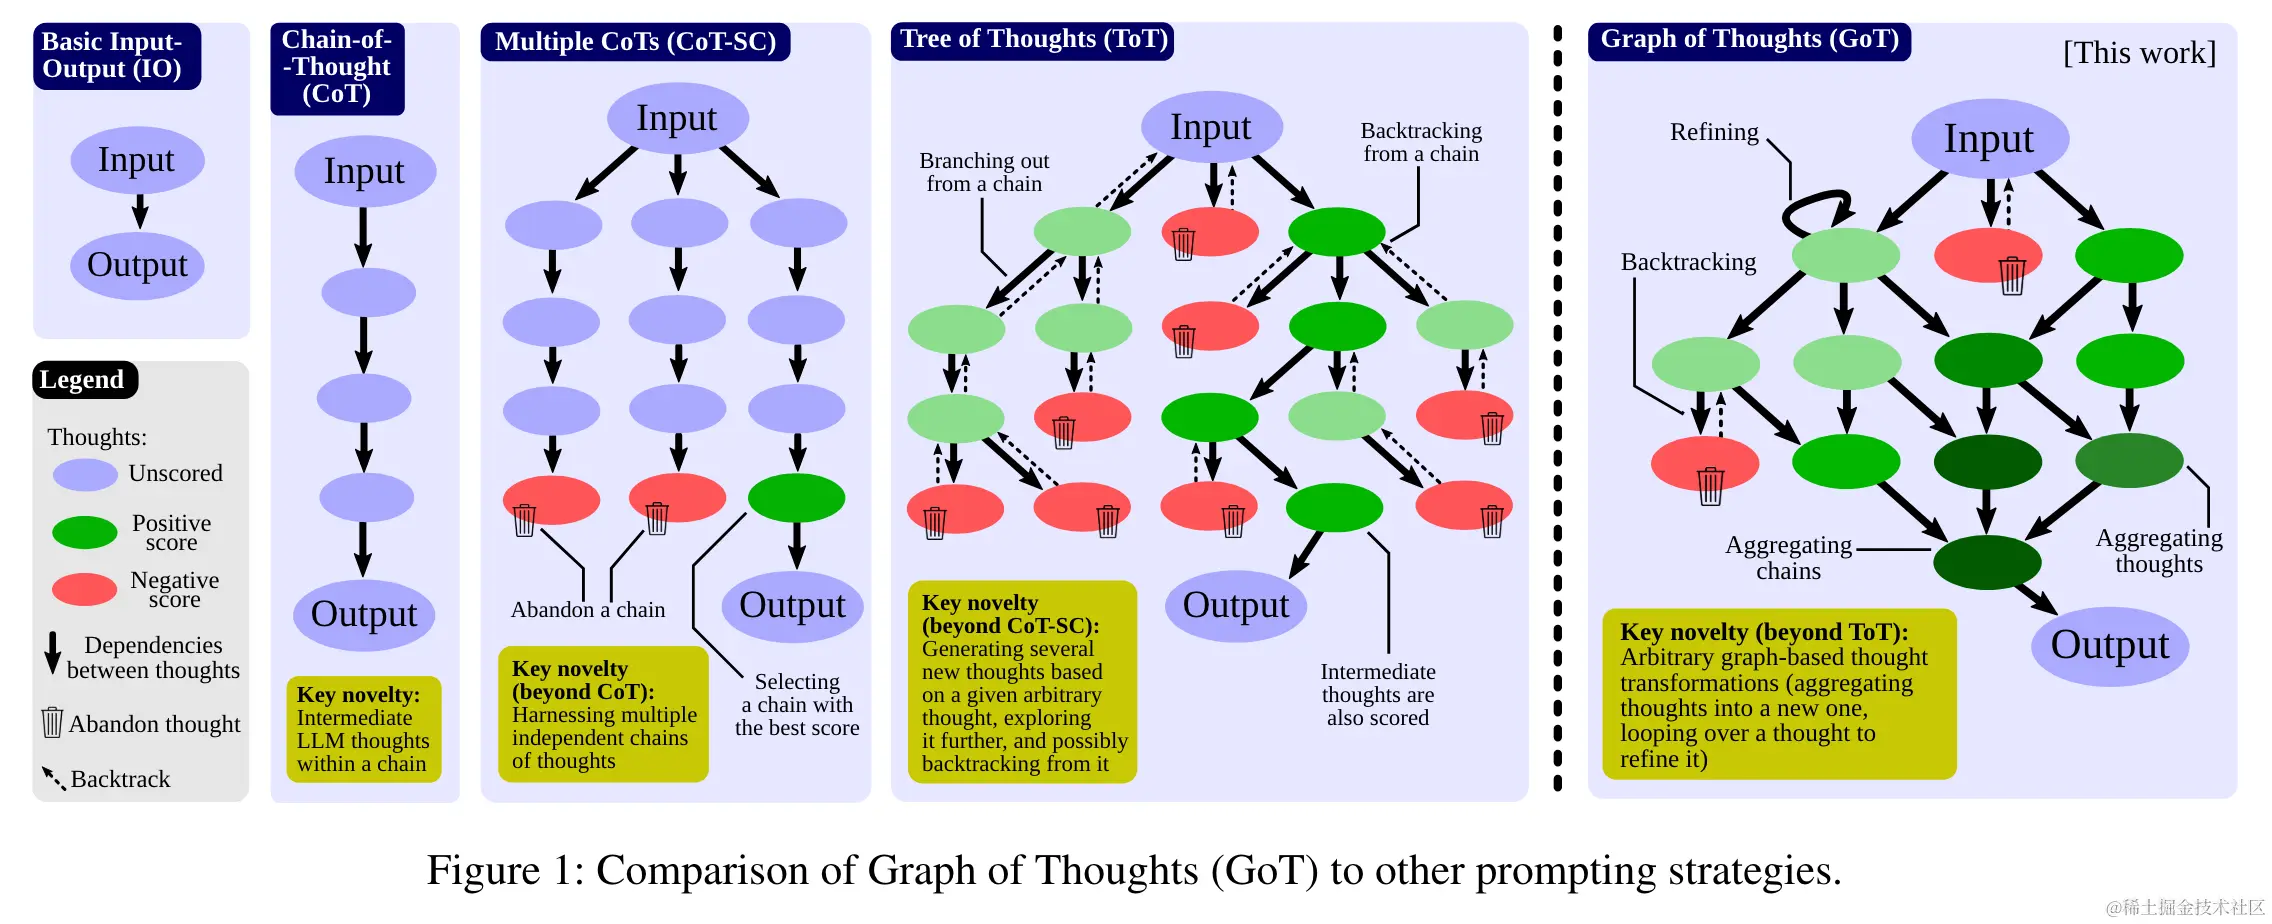
目前大模型“思考”的主要方式是CoT,即引导模型一步一步思考最终得到答案。CoT迫使模型将推理过程划分为中间步骤,这种方法类似于人类的认知过程,将复杂的挑战分解为更小、更易于管理的部分,每个步骤可以是短语、算式或写作计划,取决于问题的性质。CoT还可以细分为多个方法,如:zero-shot CoT、Few-shot CoT、Self-Consistency、 Least-to-Most、Tree-of-Thoughts、 Graph-of-Thoughts、Algorithm-of-Thoughts、Skeleton-of-Thought、Program-of-Thoughts等
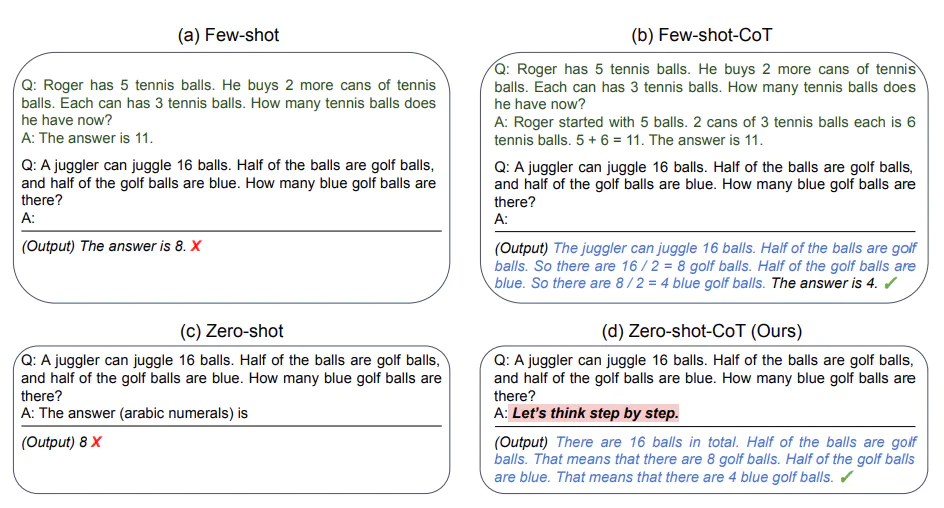
其中,最简单的 CoT 方法为zero-shot CoT,只在问题后加上“Let's think step by step"即可轻松实现零样本 CoT prompt,并且此方法无需额外样本,为模型明确了思考的方向(即一步步解决问题),从而增强其问题解决的能力,故以此示例CoT的核心思想:
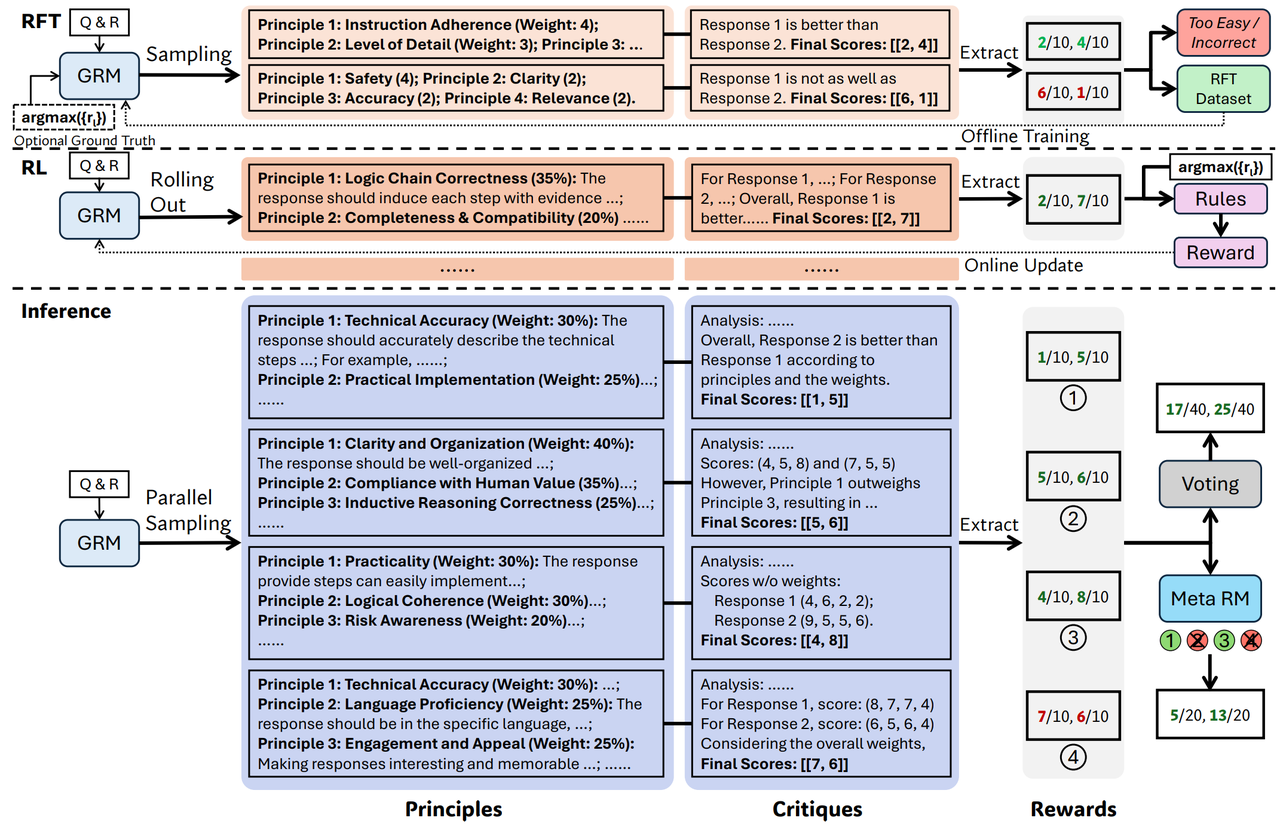
最近deepseek又提出了另一种“思考”方式,即用模型自身生成评价原则并自己分析自己生成的结果中的最佳答案。这个方法不像step-by-step那样有很多个中间思考步骤,相当于只思考了一步,思考时间有所减少,但它生成原则和自评的时间相对费时,推理时间仍然很长,且本算法提升精度更重要的部分是推理中的并行采样,并行采样通过多次采样从而增加获得正确答案的可能性,多次采样耗时较大,问题很明显。
二、NoThinking
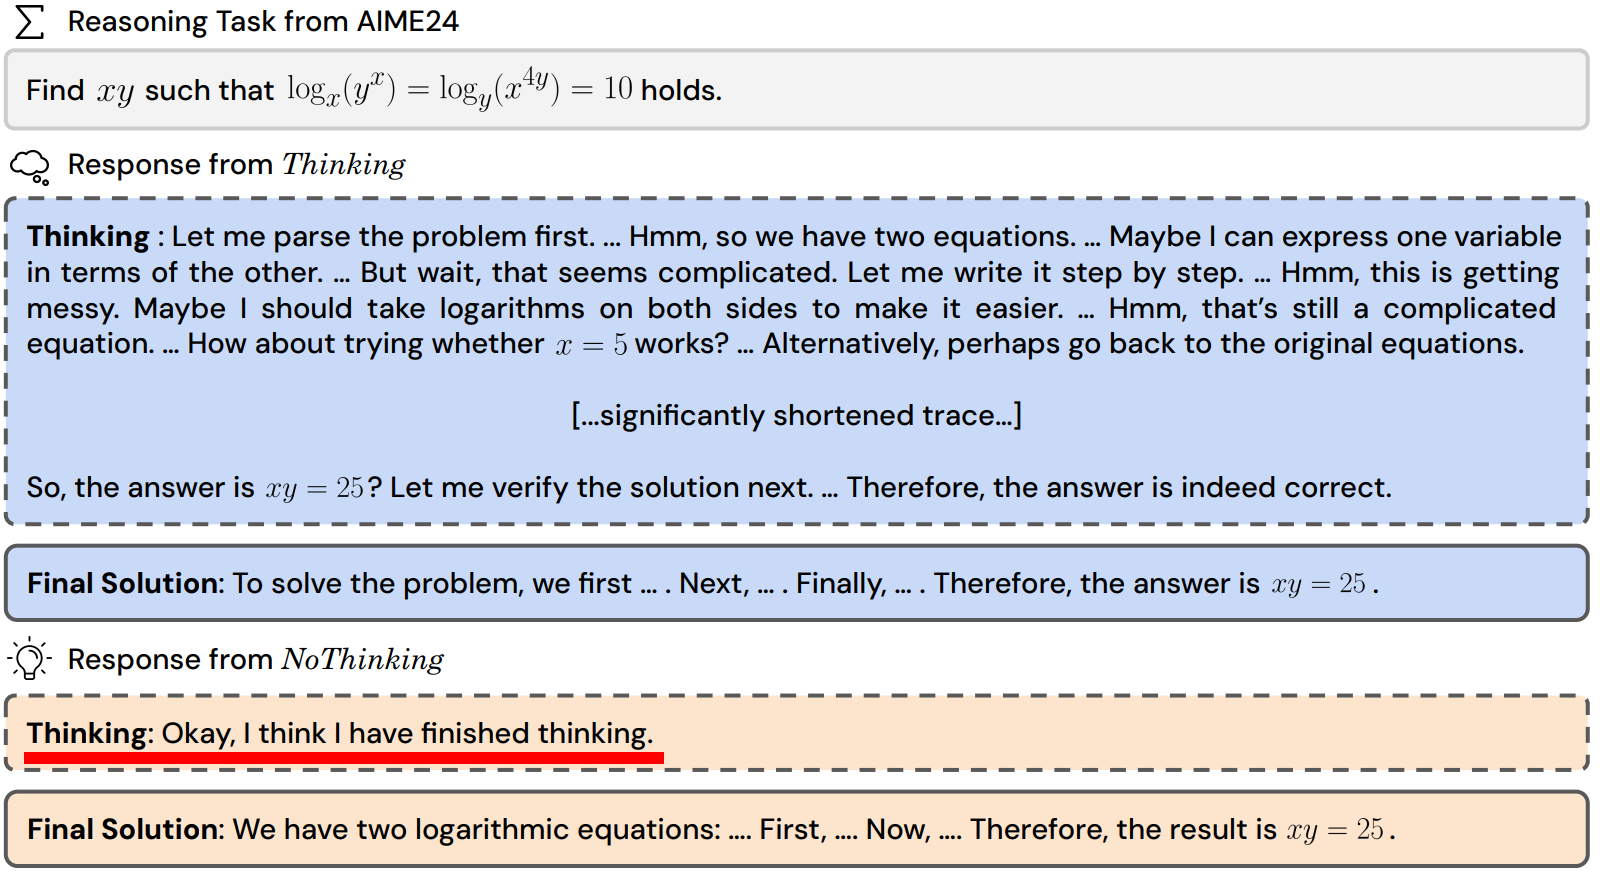
论文《Reasoning Models Can Be Effective Without Thinking》指出:在 token 预算相当的情况下,对于大多数 k 值,NoThinking 方法的表现始终优于传统的 Thinking 结果,随着 pass@k 中 k 值的增加,趋势越明显。此外,研究还发现,NoThinking 方法可以与 「从 N 个中选最佳」的选择方法相结合,从而在准确率和延迟的权衡方面,取得比标准 Thinking 方法更好的效果。本论文作者只是在推理过程中强行加入:“好吧,我已经思考完了”来欺骗模型,就能获得之前CoT显式思考类似精度的答案,作者说甚至只需要在推理过程中加入这句话就行。不过,作者在实验此法时也有点不足之处,不思考的token损耗少些,为了让思考与不思考这两种方案的tokens消耗一致,他设置max_tokens强行阶段模型的后续“思考”,这势必会因“思考”不完善而导致答案精度下降,但作者的这个NoThinking方向是一个正确的研究方向。
三、应试机器
RL 只是让模型更会“猜答案”,并未突破原有潜力。
一个基本的事实是模型是没有真正思考能力的,它只是概率统计学的产品,人们只能用各种算法去让模型模拟人类的“思考”能力,于是就有人怀疑,模型的思考是不是一种作弊行为。论文《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》发现用强化学习训练的大模型,可能只是“应试机器”,而不是真正变聪明了!就像学生只背标准答案,不再思考其他解法。 因为经测试:小样本测试(如只考1次)时,RLVR模型得分更高(比如数学题正确率提升30%),如果允许“无限次重考”(比如尝试256次),基础模型反而能解决更多难题!
实验揭秘:“开卷考试”

为了验证这一点,研究者设计了一场特殊的“考试”——pass@k测试:
规则:让模型对同一问题生成k个答案,只要有一个正确就算通过。
结果:当k=1时,RLVR模型胜出;但当k=256时,基础模型反超!

基础模型通过“穷举”找到了RLVR模型从未触达的正确解法。这说明:所有RLVR的“高级推理”,其实早已藏在基础模型的可能性中。
数学解释:RLVR通过奖励机制(如答案正确得1分)让模型输出分布偏向高奖励路径,导致输出熵降低(多样性减少),就像学生只背标准答案,不再思考其他解法。
论文用“搜索树”形象比喻模型思维:
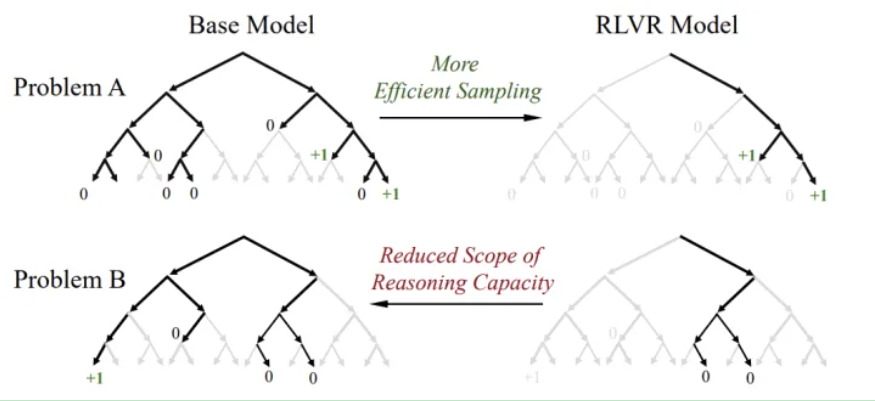
因此,作者得出结论:RLVR只是让模型更擅长“快速找到已知解法”,但牺牲了探索新方法的能力,像培训班教出的“应试机器”。
四、解决方案
既然RL 训练获得的模型“思考”能力并非真思考,基础模型本身其实就包含通过“思考”所能获得的正确答案 ,为了降低推理耗时且去掉那些大段输出的恼人显示思考,同时节约tokens也就是节约算力花费和电费,是否有方法解决这个看着恼人的问题?本文提出的以下方法改变训练方式即可实现。
NoThinking与“应试机器”的发现其实本身都不是批判RL算法的错误,而是逐步揭开了RL提升大模型精度的真相,同时,还揭开了推理过程中多次采样能提升大模型精度的真相:大模型不是不知道正确答案,而是不能快速触达正确答案。那么就可以这样解决:训练时在原有的思考输出头的基础上增加一个应试输出头,一个用于探索一个用于答案:探索头+答案头,答案头的label设置为思维链推理中的Final Solution,两个输出头的损失函数比重可设置为1:1,或在训练时根据实验效果调整,训练时探索头仍用RL(GRPO、DAPO等)算法训练,推理时丢掉探索头,只用答案头就可去掉思考过程,且保障了RL思考所带来的高精度,因为训练时探索头已经指导模型知道了解决问题的捷径在哪里 ,对于训练数据,COT的think数据、GRM的自动原则评价数据都可以使用,在标注文件中定制一个标记进行识别即可,比如:think或principle。那么,以前推理RL训练过的模型,在推理阶段仍需要并行采样才能获得更高精度怎么解决呢?经上面分析,基础预训练模型其实具备回答正确的可能性,问题是部分场景下没有学会如何一次找到正确答案的方法,此问题之前是在推理过程中加入一个预训练好的分类模型剔除不好的答案来解决,那么现在可以把这个分类模型放到训练过程中对探索头的回答结果进行监督训练即可,从而去掉推理过程中导致重度计算量和延迟的并行采样,直接在训练时让模型学会解决问题的捷径方法, 这样模型推理也不再需要区分推理型问题还是聊天型问题,也不用加“我已经思考完了”之类的欺骗性话语,自然简单地就完成了推理格式的统一,不过,对于那种疑难稀缺的问题还是不能完全靠模型,必须得给一些类似的训练数据模型才可能学会如何找方法解决,这个才符合深度学习算法的原理。
参考:
《Inference-Time Scaling for Generalist Reward Modeling》
《Reasoning Models Can Be Effective Without Thinking》
《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》
 暂无数据
 暂无数据 暂无数据