k100 AI VLLM多卡部署的启动命令是什么,我多卡部署报错,单卡可以
0
1
0
0
千问 VL 模型,多卡比少卡慢,vllm 靠谱
2025-05-29 16:22:51
301
采用 https://sourcefind.cn/#/model-zoo/1896814890439540737 官方的 qwen2.5_vl 镜像,在8卡 k100 AI 上跑 32B 模型,CUDA_VISIBLE_DEVICES=0,1 python inference.py 不指定显卡,8卡跑下来要 36秒多,2个卡大概 6秒。是缺少什么配置吗,求解惑啊
换成 vllm 那个镜像 image.sourcefind.cn:5000/dcu/admin/base/custom:vllm0.7.2-ubuntu22.04-dtk25.04-rc7-das1.5-py3.10-20250510-fixpy
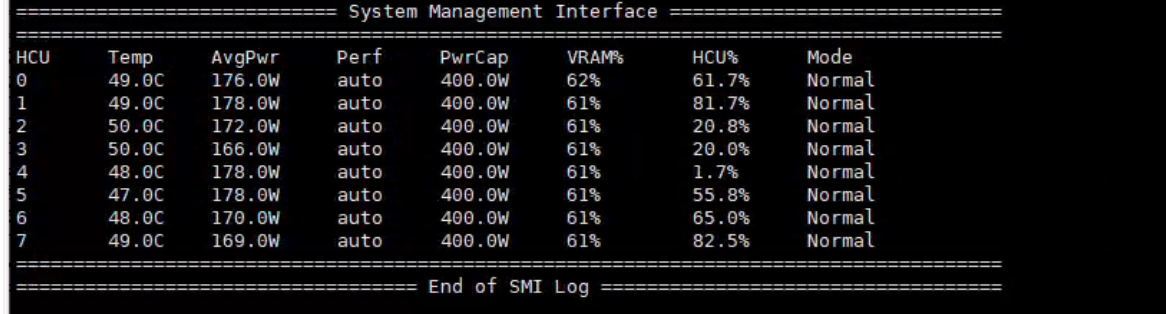
8卡 python inference.py 耗时1分半钟,显存均匀,hcu 消耗不均
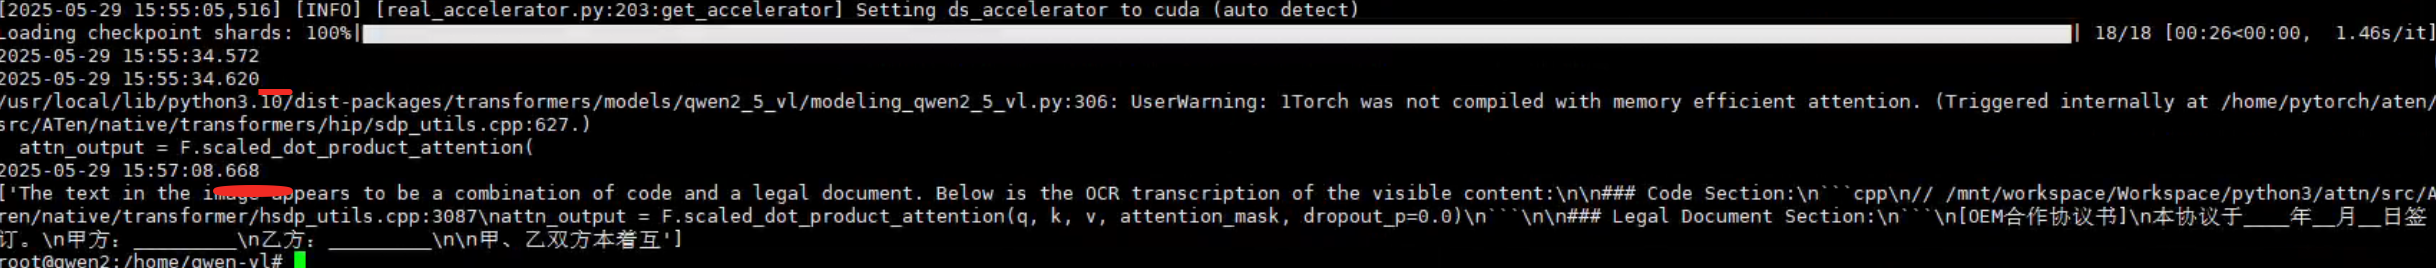
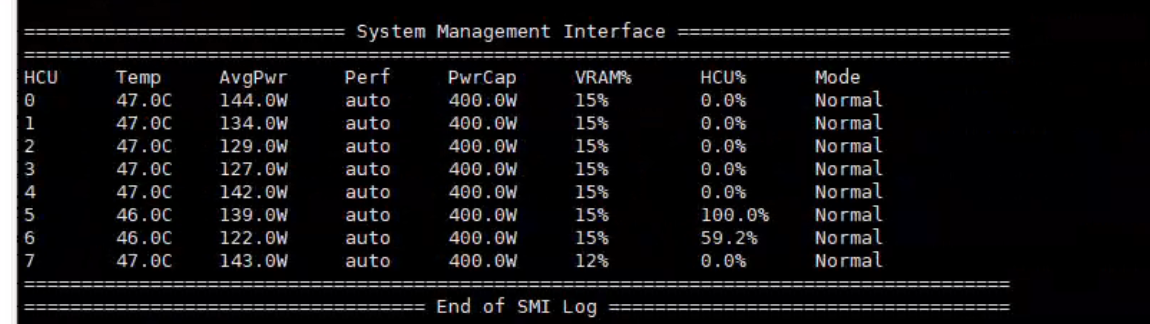
2卡,耗时 45秒,显存两卡,hcu 不是很均匀
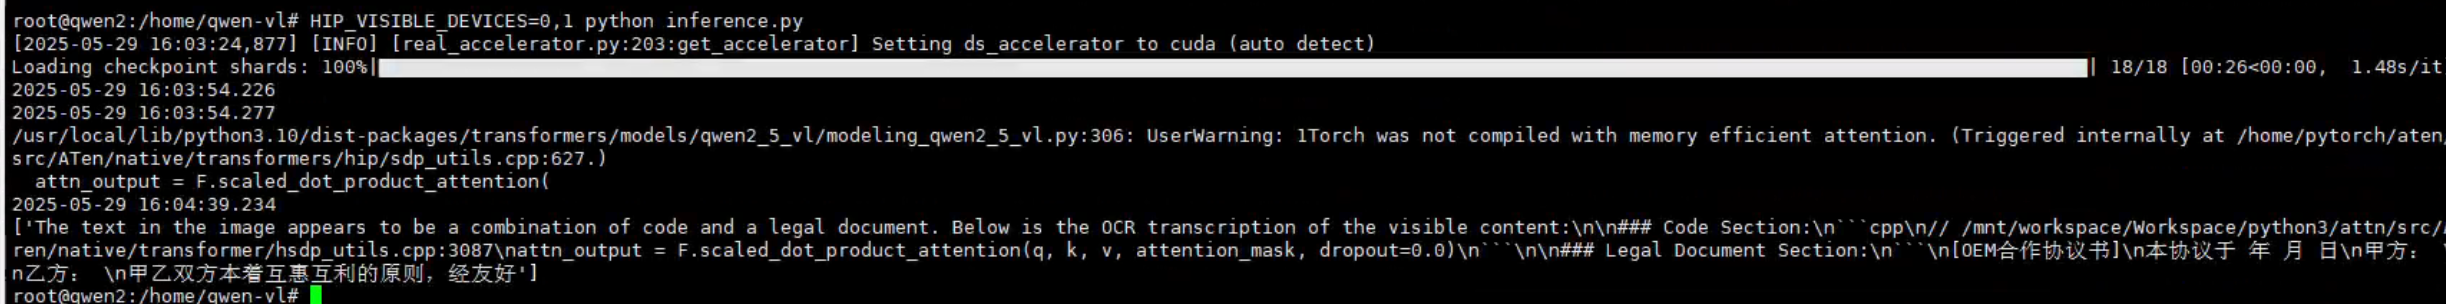
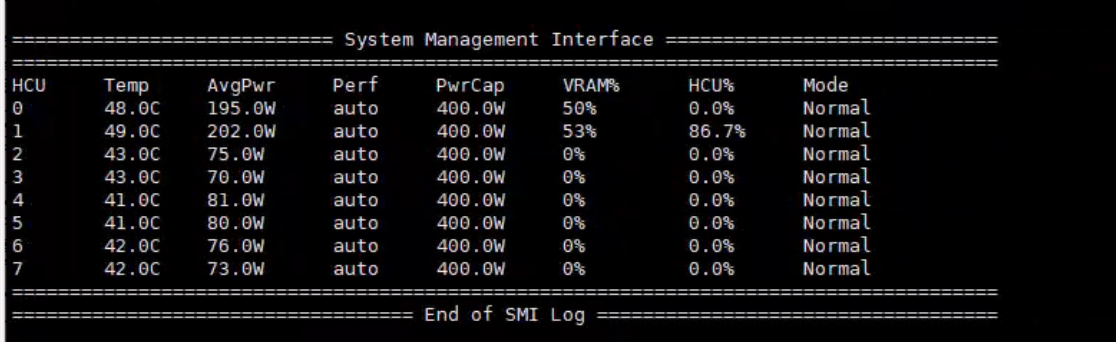
换成 vllm 8卡 ,耗时 18秒,hcu 并行效果比较好
time curl http://localhost:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
    "model": "Qwen2.5-VL-32B-Instruct",
    "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": [
        {"type": "image_url", "image_url": {"url": "https://sourcefind.cn/model-zoo/file/Qwen2.5-vl_pytorch/images/result.png"}},
        {"type": "text", "text": "OCR this image"}
    ]}
    ]
    }'

全部评论(7)
只看楼主
网
2025/7/16
R
一般多卡性能不如少卡,是因为卡越多卡间通信瓶颈越大。但是32B模型8卡比2卡理应不会差,可以监控下8卡推理期间卡的利用率是否偏低,以及32B模型可能4卡比较合适。
2025/5/29
T
2卡跑32B模型,会OOM程序终止吧。K100-AI上应该识别不到环境变量CUDA_VISIBLE_DEVICES,可以用HIP_VISIBLE_DEVICES。请确认2卡时,程序能正常运行,可以贴一下输出信息截图,watch rocm-smi监控卡的调用状态。
2025/5/29
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据