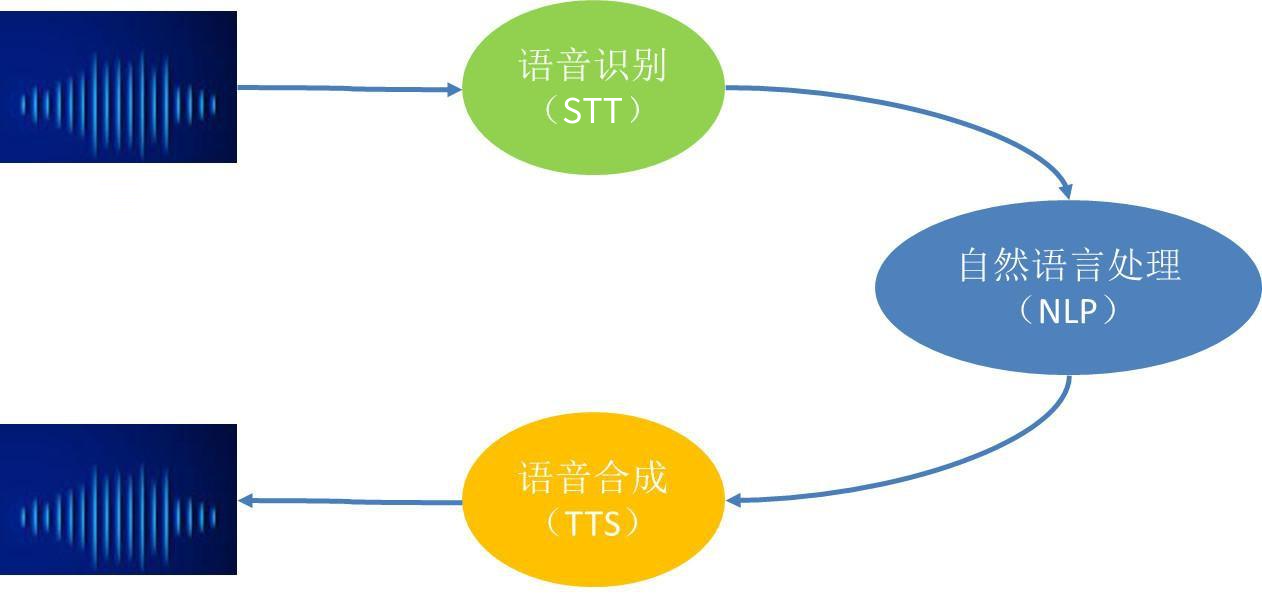
语音交互搞了那么多年,不是看起来怪怪的就是听起来怪怪的,缥缈得很!咋就那么难呐!
- 语音识别(Speech-To-Text, ):简称STT,是将声音转化成文字,相当于耳朵;
- 自然语言处理(Natural Language Processing):简称NLP,是理解和处理文本,相当于大脑;
- 语音合成(Text-To-Speech):简称TTS,是把文本转化成语音,相当于嘴巴;
- 音频转换:G2P是原始文本数据需要被转换成模型可处理的音素格式,STT是将音频转换为对数梅尔频谱图或其他类型的频谱特征,TTS是模型的计算结果从上述频谱特征转换为音频;
一般我们看到语音交互这个名词,就会被各种高大上的算法所迷糊,比如:隐马尔可夫模型(HMM)等,门槛太高接不住!但那已经是过去,现在基本都用基于深度学习的端到端方法了,不再先将语义特征和声学特征 解耦 然后做字素到音素的对齐,比如, 语音合成 将文本特征和频谱特征放进 大模型 就行,直接只用 LLM 提取、计算和生成频谱特征,统一的序列到序列生成稳定性更好, 复杂的东西都变成了模型自动处理,理解起来轻松多了,只是做好效果不容易!
一、STT
1.1 Wenet
曾经的语音识别对于非语音专家来讲非常困难,不只是传统算法kaldi、espnet等的晦涩难懂,还有训练数据不知道怎么制作、“专家”经验涉及太多,还有训练、部署方法极其纷繁复杂,普通人根本难以入门,Wenet的出现一举打破这一行业壁垒,Wenet的核心目标就是简化工业界的语音识别落地,不止简化算法,还简化全套工程落地,作者直接做成了一键部署,对行业产生了深远的影响,至此,语音识别的工业界落地彻底破防,以后的语音算法都默认包含工业级落地的实现。Wenet在训练时同时使用了帧级别deocder的 CTC ** loss** 和label级别decoder的loss。
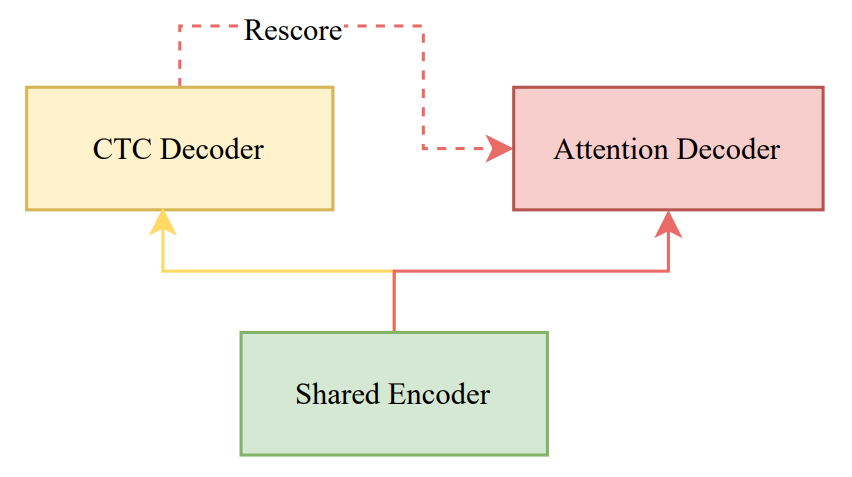
CTC + attention rescoring方案可以利用CTC decoder的输出作为流式结果,保证了实时性,而在非流式识别阶段,Attention 解码器 利用全局上下文的Attention信息,对识别结果进行二次对齐优化 ,提高了识别的准确率,最终利用rescoring改进结果,得到一个识别率更高的最终结果,Wenet的解码过程:
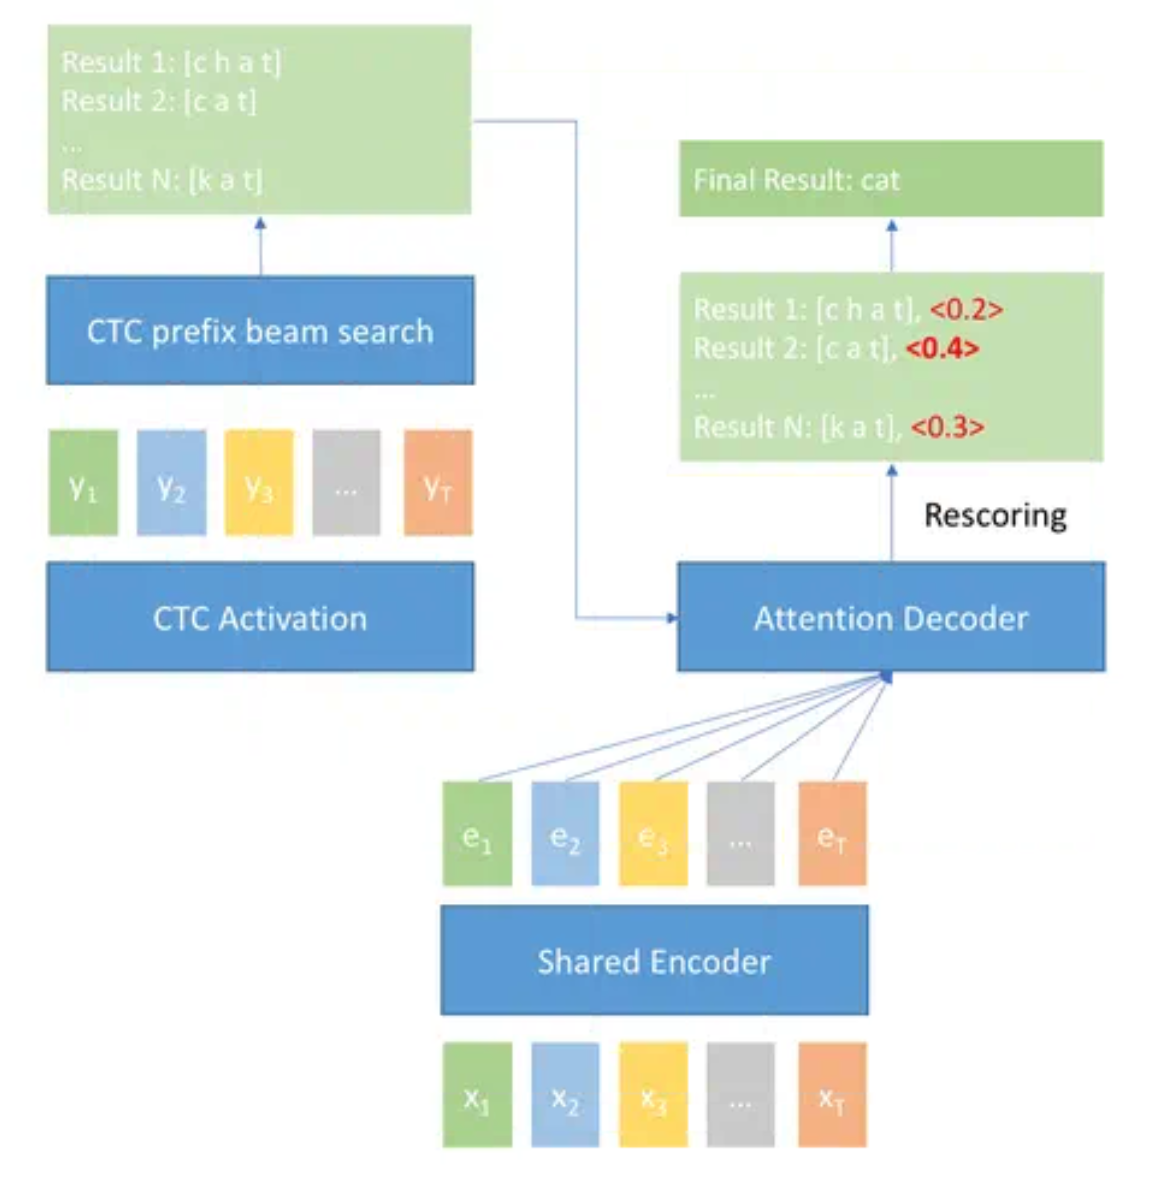
CTC 尝试解决在语音序列中寻找一条最优的对齐路径,使得声学特征与输出文本的对齐概率最大化,让网络自动学习到“在时间步t上对应的音素/文字是什么”,但自回归(AR)模型本身也包含有对齐功能,之后的少量模型并不采用CTC,而是更简单方便地使用语音编码器输出对齐的文本logits,然后端到端地训练整个模型,最终也能实现声学特征与输出文本的对齐。
Wenet既支持流式语音输入,也支持流式的文本输出。
1.2 Whisper
Whisper系列用到了680,000小时的音频标注数据 ,采用Transformer编码器-解码器架构,直接采用序列到序列的生成方式 ,利用模型自动化处理时序信息,由OpenAI发布,精度比Wenet高,但其大规模模型的速度仍然较慢,难以满足实时性要求,于是其它研究人员就做了各种奇思淫巧的加速版本:Whisper Turbo**、** LightWhisper等,还有一些增加标点符号的版本,一时场面较为热闹而混乱。
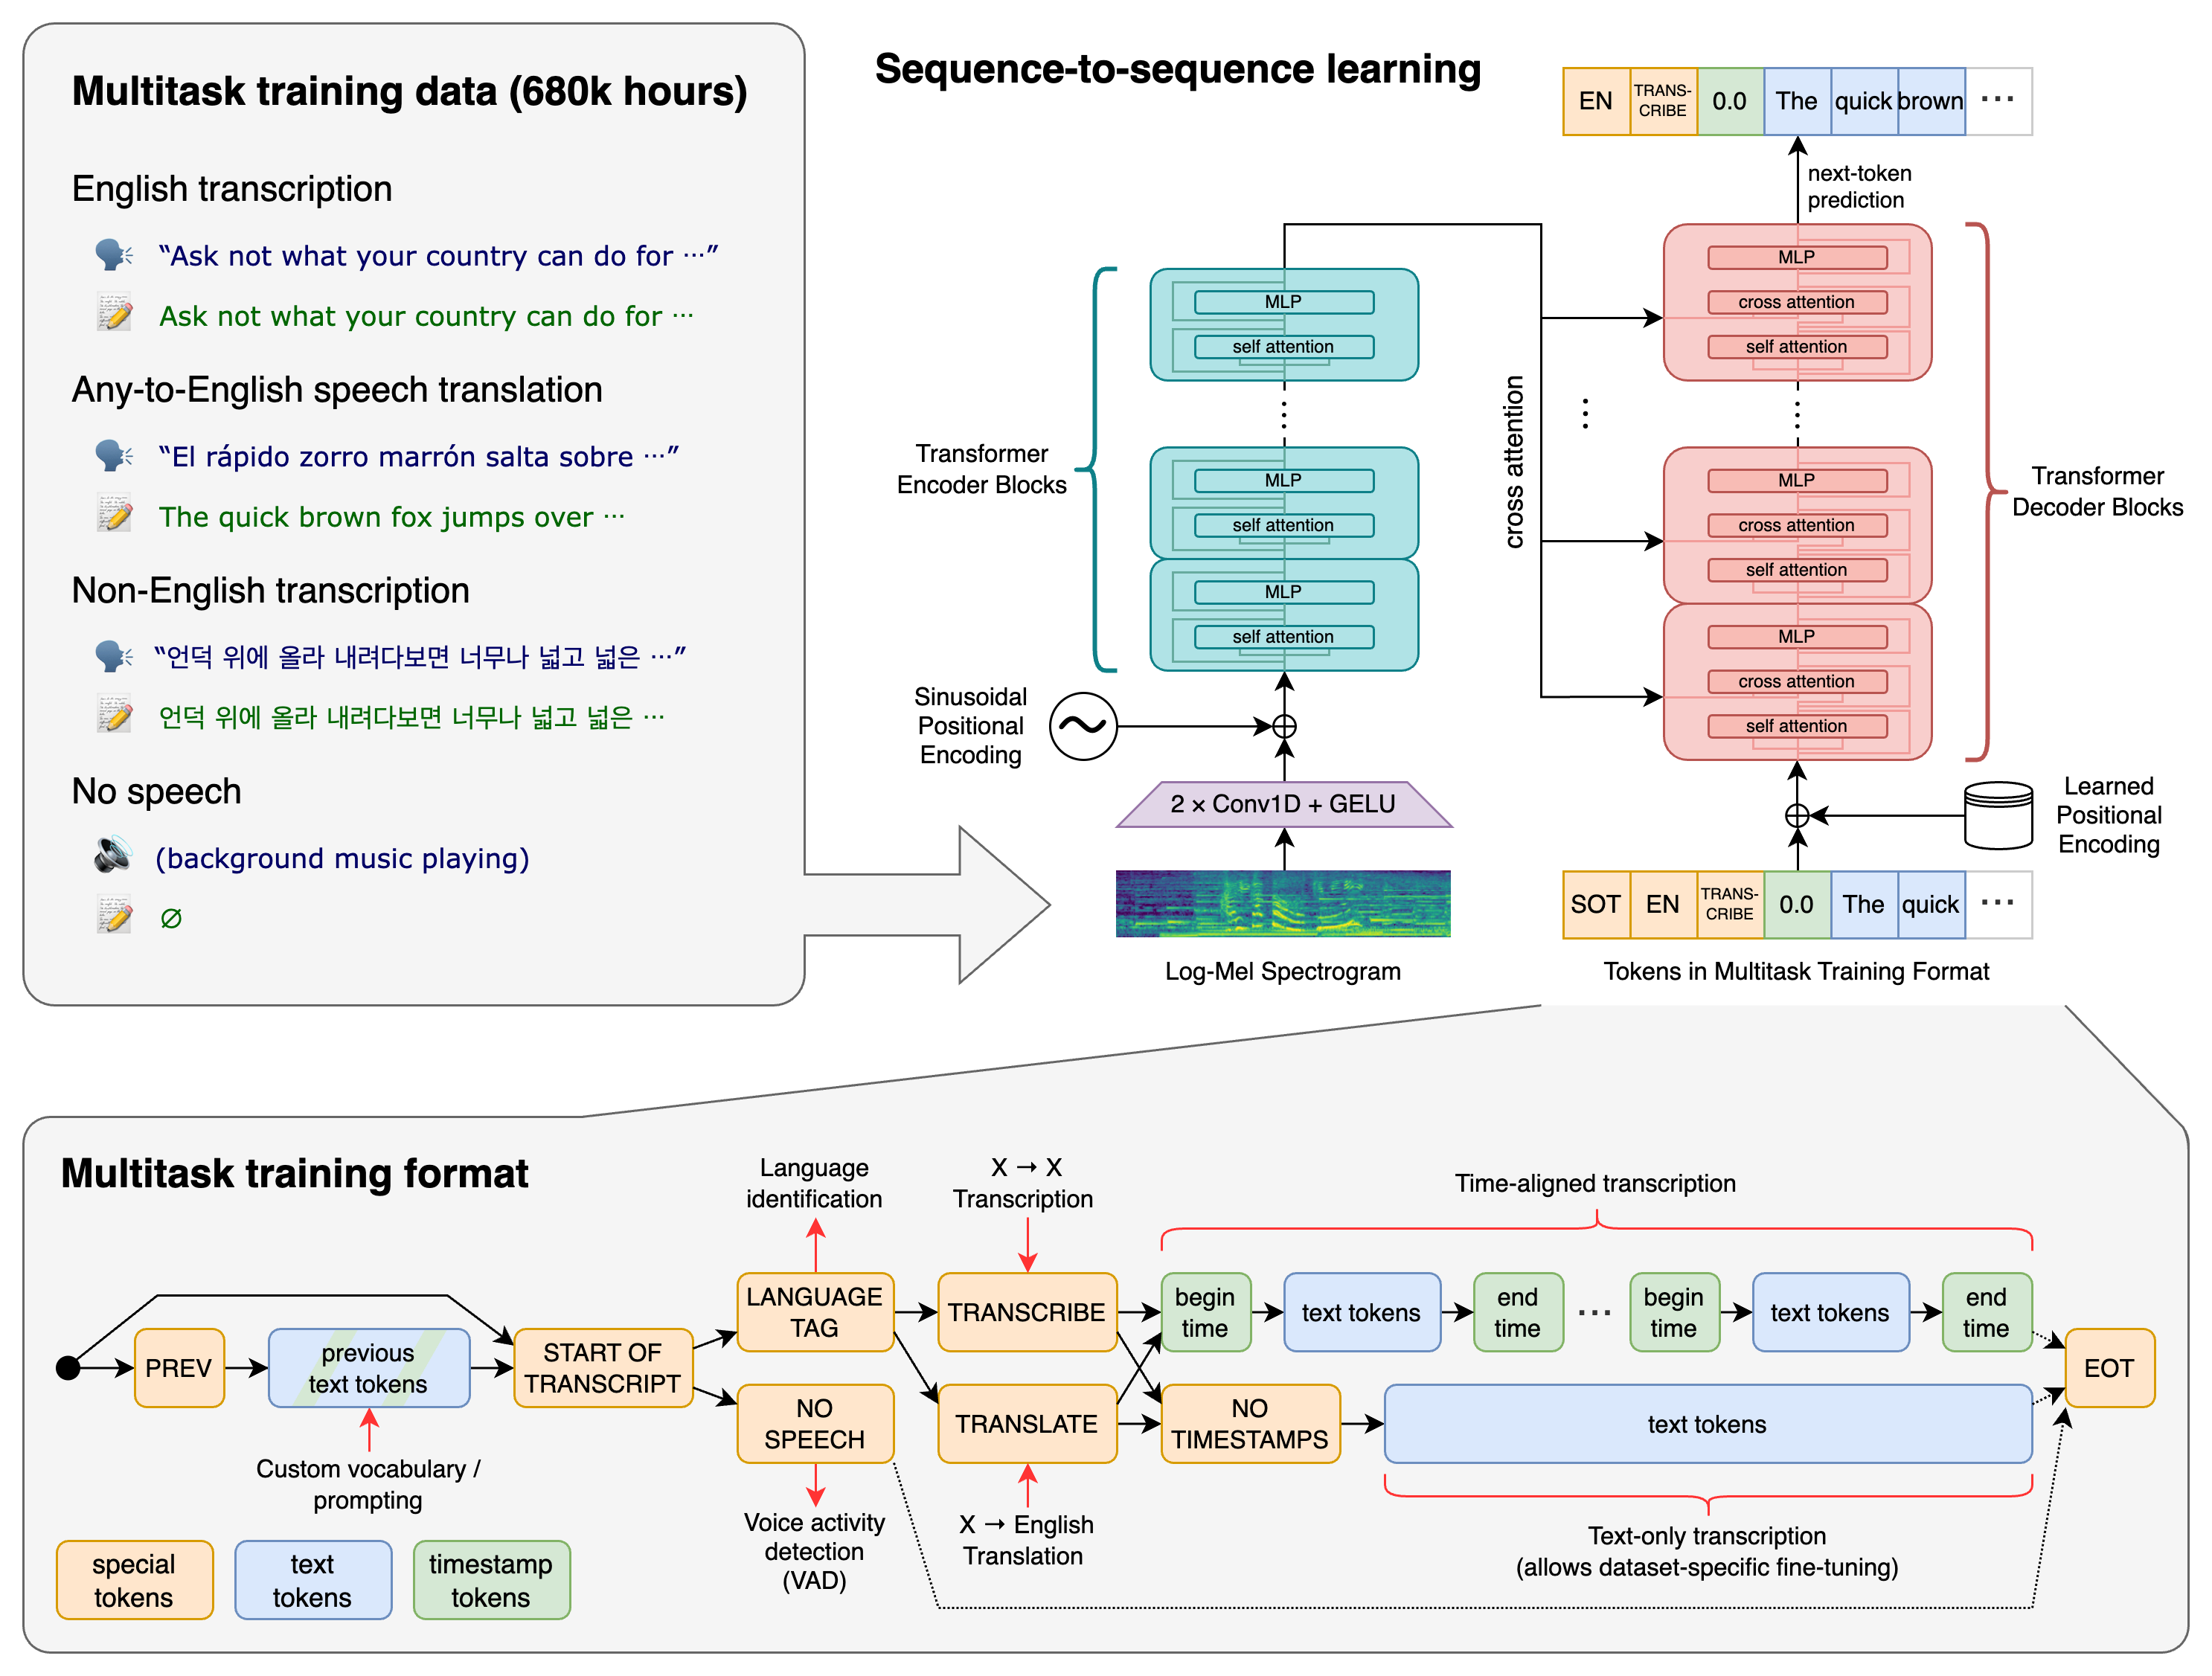
OpenAI的Whisper说明,不用想得太复杂,高质量的标注数据多了,即使通用的 编码器 - 解码器 结构也一样可以获得效果非常好的语音识别 。
Whisper支持流式语音输入,不支持流式的文本输出,需要等待整个音频处理完成后才能获得完整的转录结果。
1.3 SenseVoice
Whisper的有些版本是针对特殊设备进行的优化,其它设备效果不好,例如:中文标点符号生成很不好,于是阿里就开始出手了,FunASR发布的SenseVoice-Small一举解决Whisper遗留的问题,实测比Whisper快比Whisper精度高,10秒音频推理仅耗时70毫秒,比Whisper-Large模型快15倍,中英文自动化随意切换。
SenseVoice-Small是一种非自回归端到端语音识别模型,非自回归一次性预测整句语音 token 的分布,不依赖前面已经生成的 token,速度快,但是准确性或自然度可能稍低,相比于目前主流的 自回归模型 ,可以 并行 的对整条句子输出目标文字,特别适合利用 GPU 进行并行推理。 SenseVoice-Small是首个在工业大数据上可以获得和自回归端到端模型相同性能的非自回归模型,配合GPU推理,可以将推理效率提升10倍,从而将语音识别云服务的机器成本降低接近10倍,且部署方法极其简单,为目前开源语音识别模型的最佳选择。
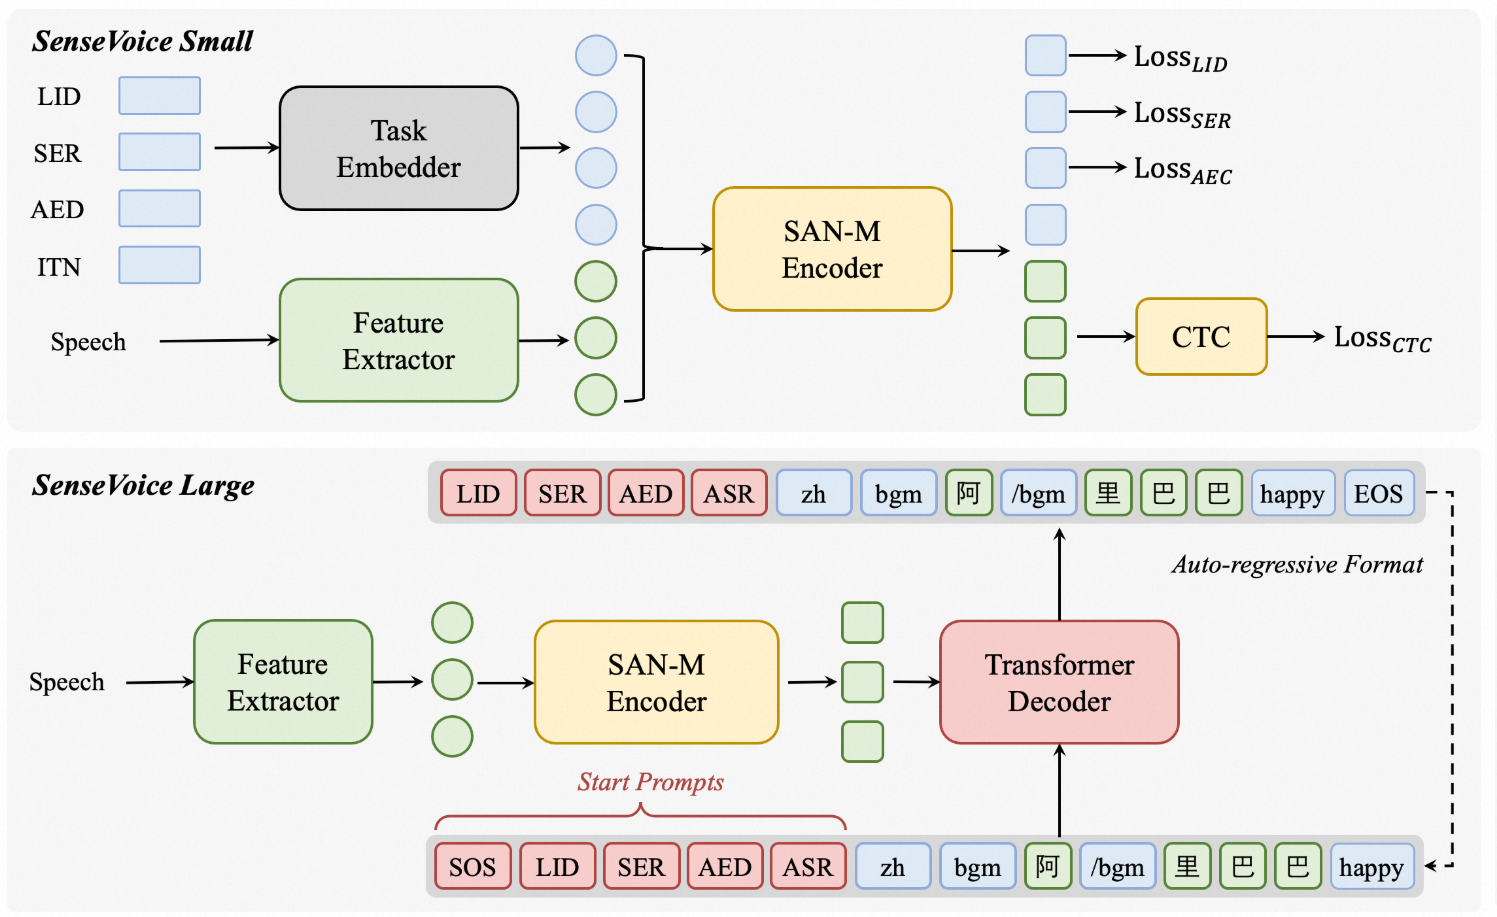
SenseVoice既支持流式语音输入,也支持流式的文本输出。
期间,OpenAI发布过gpt-4o-transcribe,支持双向流式,中文识别精度与SenseVoiceSmall略有差距,目前是世界上精度最高的模型但是闭源,虽然便宜,终归还是不如免费的SenseVoice香,后续的VITA-Audio语音识别也是一个不错的选择。
二、TTS
2.1 Fish-Speech
Fish-Speech号称最自然的AI语音,一直在更新一直在变强,基于VQ-GAN、Llama和VITS等技术开发,采用了Transformer架构。Fish-Speech利用大型语言模型( LLMs )和双 自回归 (Dual-AR)架构来取代传统的字素到音素(G2P)转换 ,仅需15秒的音频样本,Fish-Speech便能迅速实现声音克隆,生成与目标声音高度相似的语音,支持包括中文在内的多种主流语言,支持生成具有各种情感色彩的语音,如快乐、悲伤、愤怒等,此外,还支持用户可以根据自己的喜好精细调节语速、音调和重音。Fish-Speech开源时间较早,成功地吸引了一大批后来的挑战者,听感优秀,据实际场景的大量测试,就生成声音与源声音的相似度而言,其它模型从未赢过,导致Fish-Speech获得了一大批忠实的粉丝。
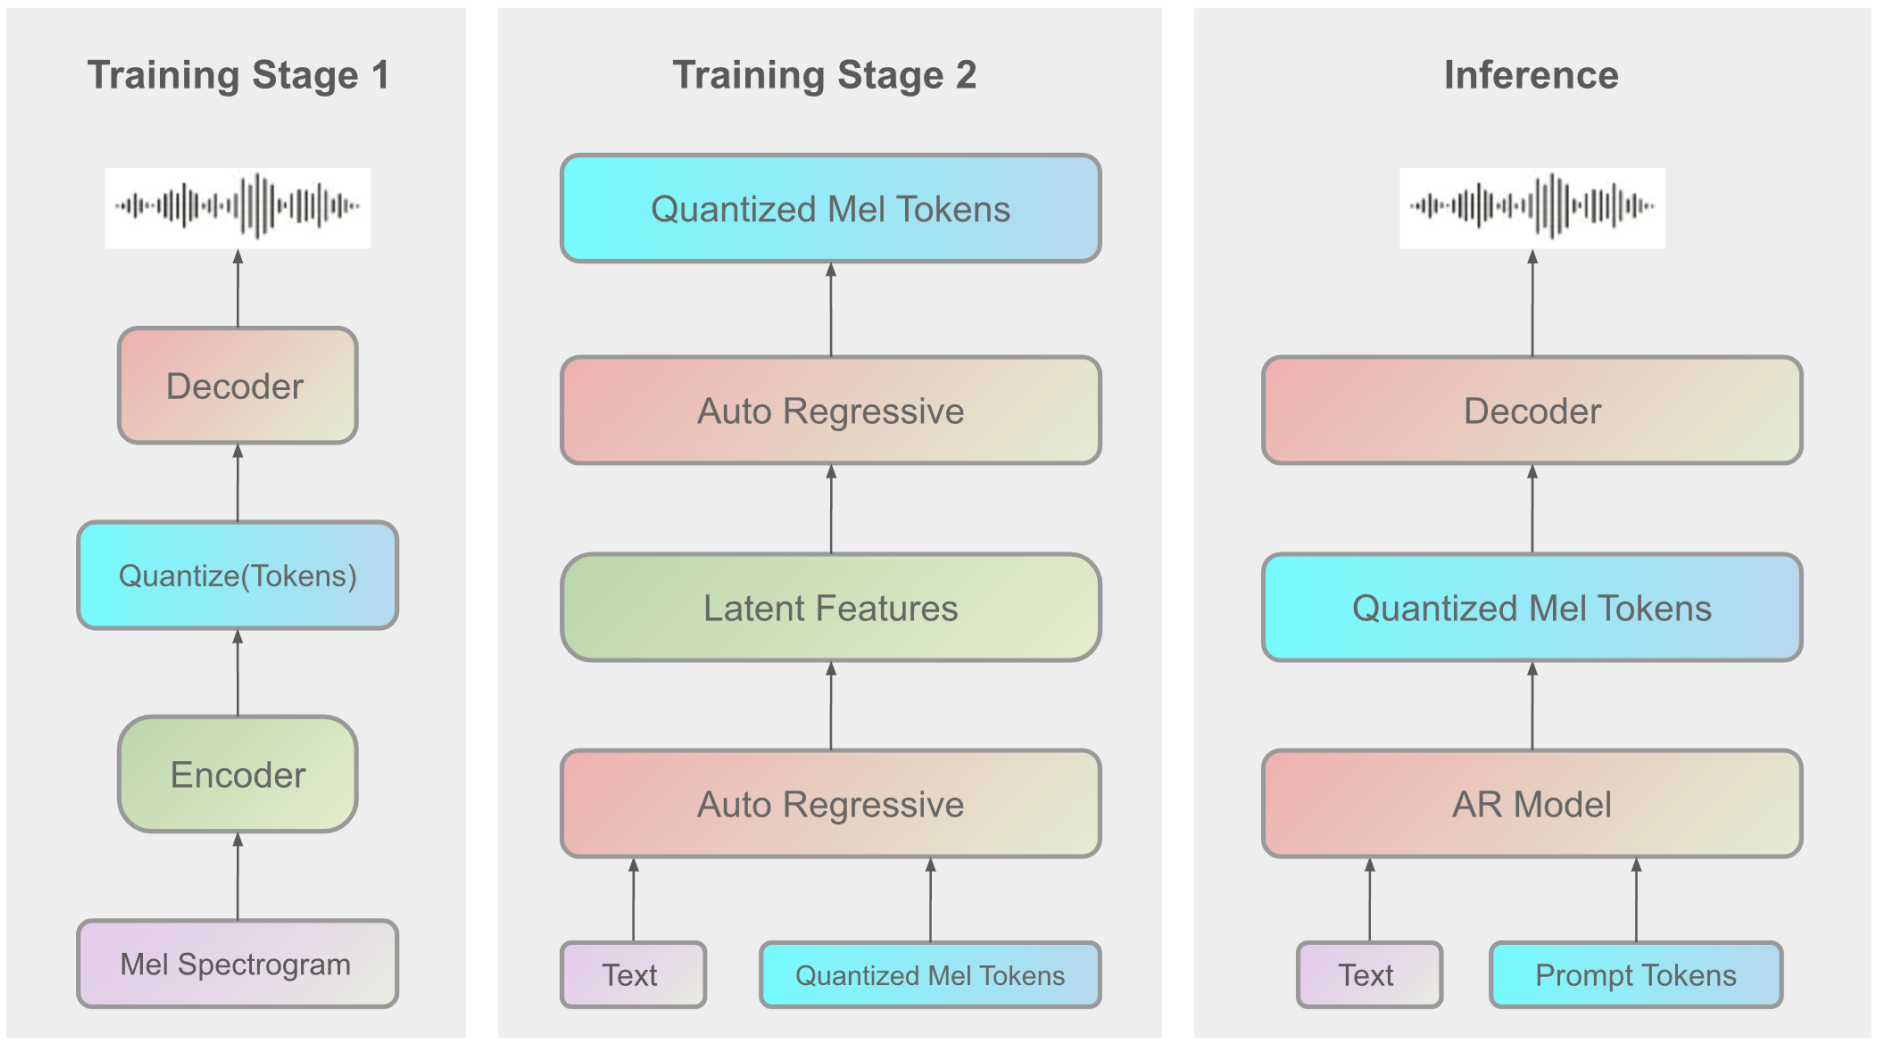
创新点:
a、引入了一种分组有限标量矢量量化(GFSQ)技术,这种方法能有效地对潜在条件进行编码,从而能够更好地捕捉和重现细微的语音变化,引入快速前馈 生成对抗网络 (FF-GAN)实现了100%的码本利用率 ,最大限度地发挥了量化空间的效能,实现了更好的序列生成稳定性;
b、双自回归(dual-AR)架构,与扩散变换器(DiT)相比,它能提供更高的生成效率,使其更适合实时应用场景;
Fish Speech采用了一种三阶段的训练方法:首先使用大量标准数据进行初始预训练,接着使用小批量高质量数据进行监督微调(SFT),最后使用人工标注的正负样本对进行直接偏好优化(DPO)训练, 通过Dual-AR架构和Firefly-GAN解码器的结合,成功解决了传统TTS系统的多语言处理和语音自然度问题,但首个音频片段的生成延迟仍达到150ms。
2.2 CosyVoice
阿里巴巴宣称其CosyVoice合成语音能够像真人一样自然流畅、富有表现力,并且能够轻松实现零样本 (Zero-Shot) 语音克隆,即用极少(甚至3s)目标说话人的音频就能合成其声音。Fish-Speech最常被对比的挑战者就是CosyVoice,支持五种语言:中文、英语、日语、粤语和韩语,新发布的CosyVoice2甚至只有0.5B,升级换代过程中参数指标上比Fish-Speech没输过,实际听感没赢过,CosyVoice的人声相似度只有75%左右。
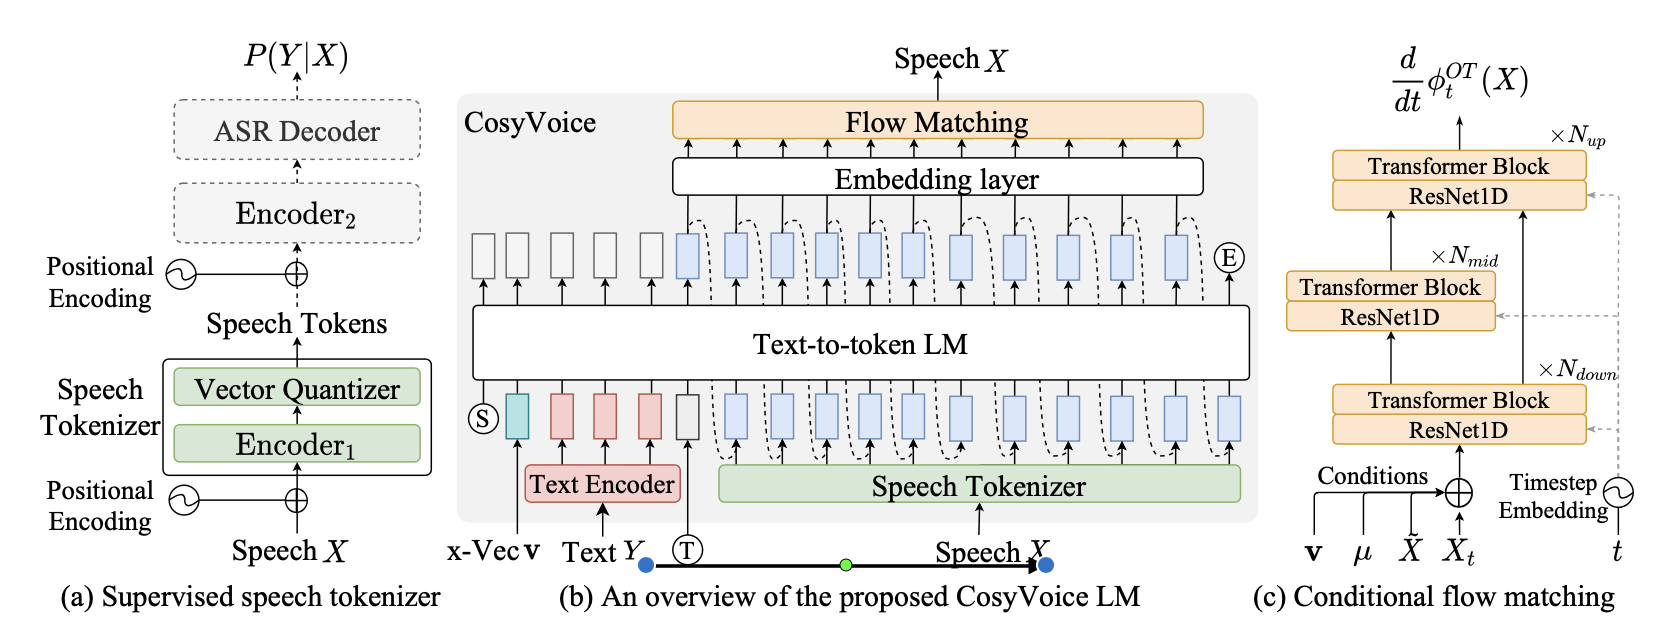
创新点:
a、监督语义语音Token(Supervised Semantic Speech Tokens, S³ Tokens):利用预训练的多语言语音识别ASR模型提取与文本内容高度对齐的、富含语义信息的语音token;
b、LLM文本到Token生成:使用LLM将输入文本转换为S³ token序列;
c、条件流匹配(Conditional Flow Matching):使用高效的流匹配模型将S³ token序列转换为高质量的梅尔频谱图 ;
d、丰富的指令控制能力(CosyVoice-instruct):支持通过指令控制合成语音的说话人身份、风格、情感、语速、性别、甚至细粒度的副语言特征(如笑声、呼吸);
2.3 F5-TTS
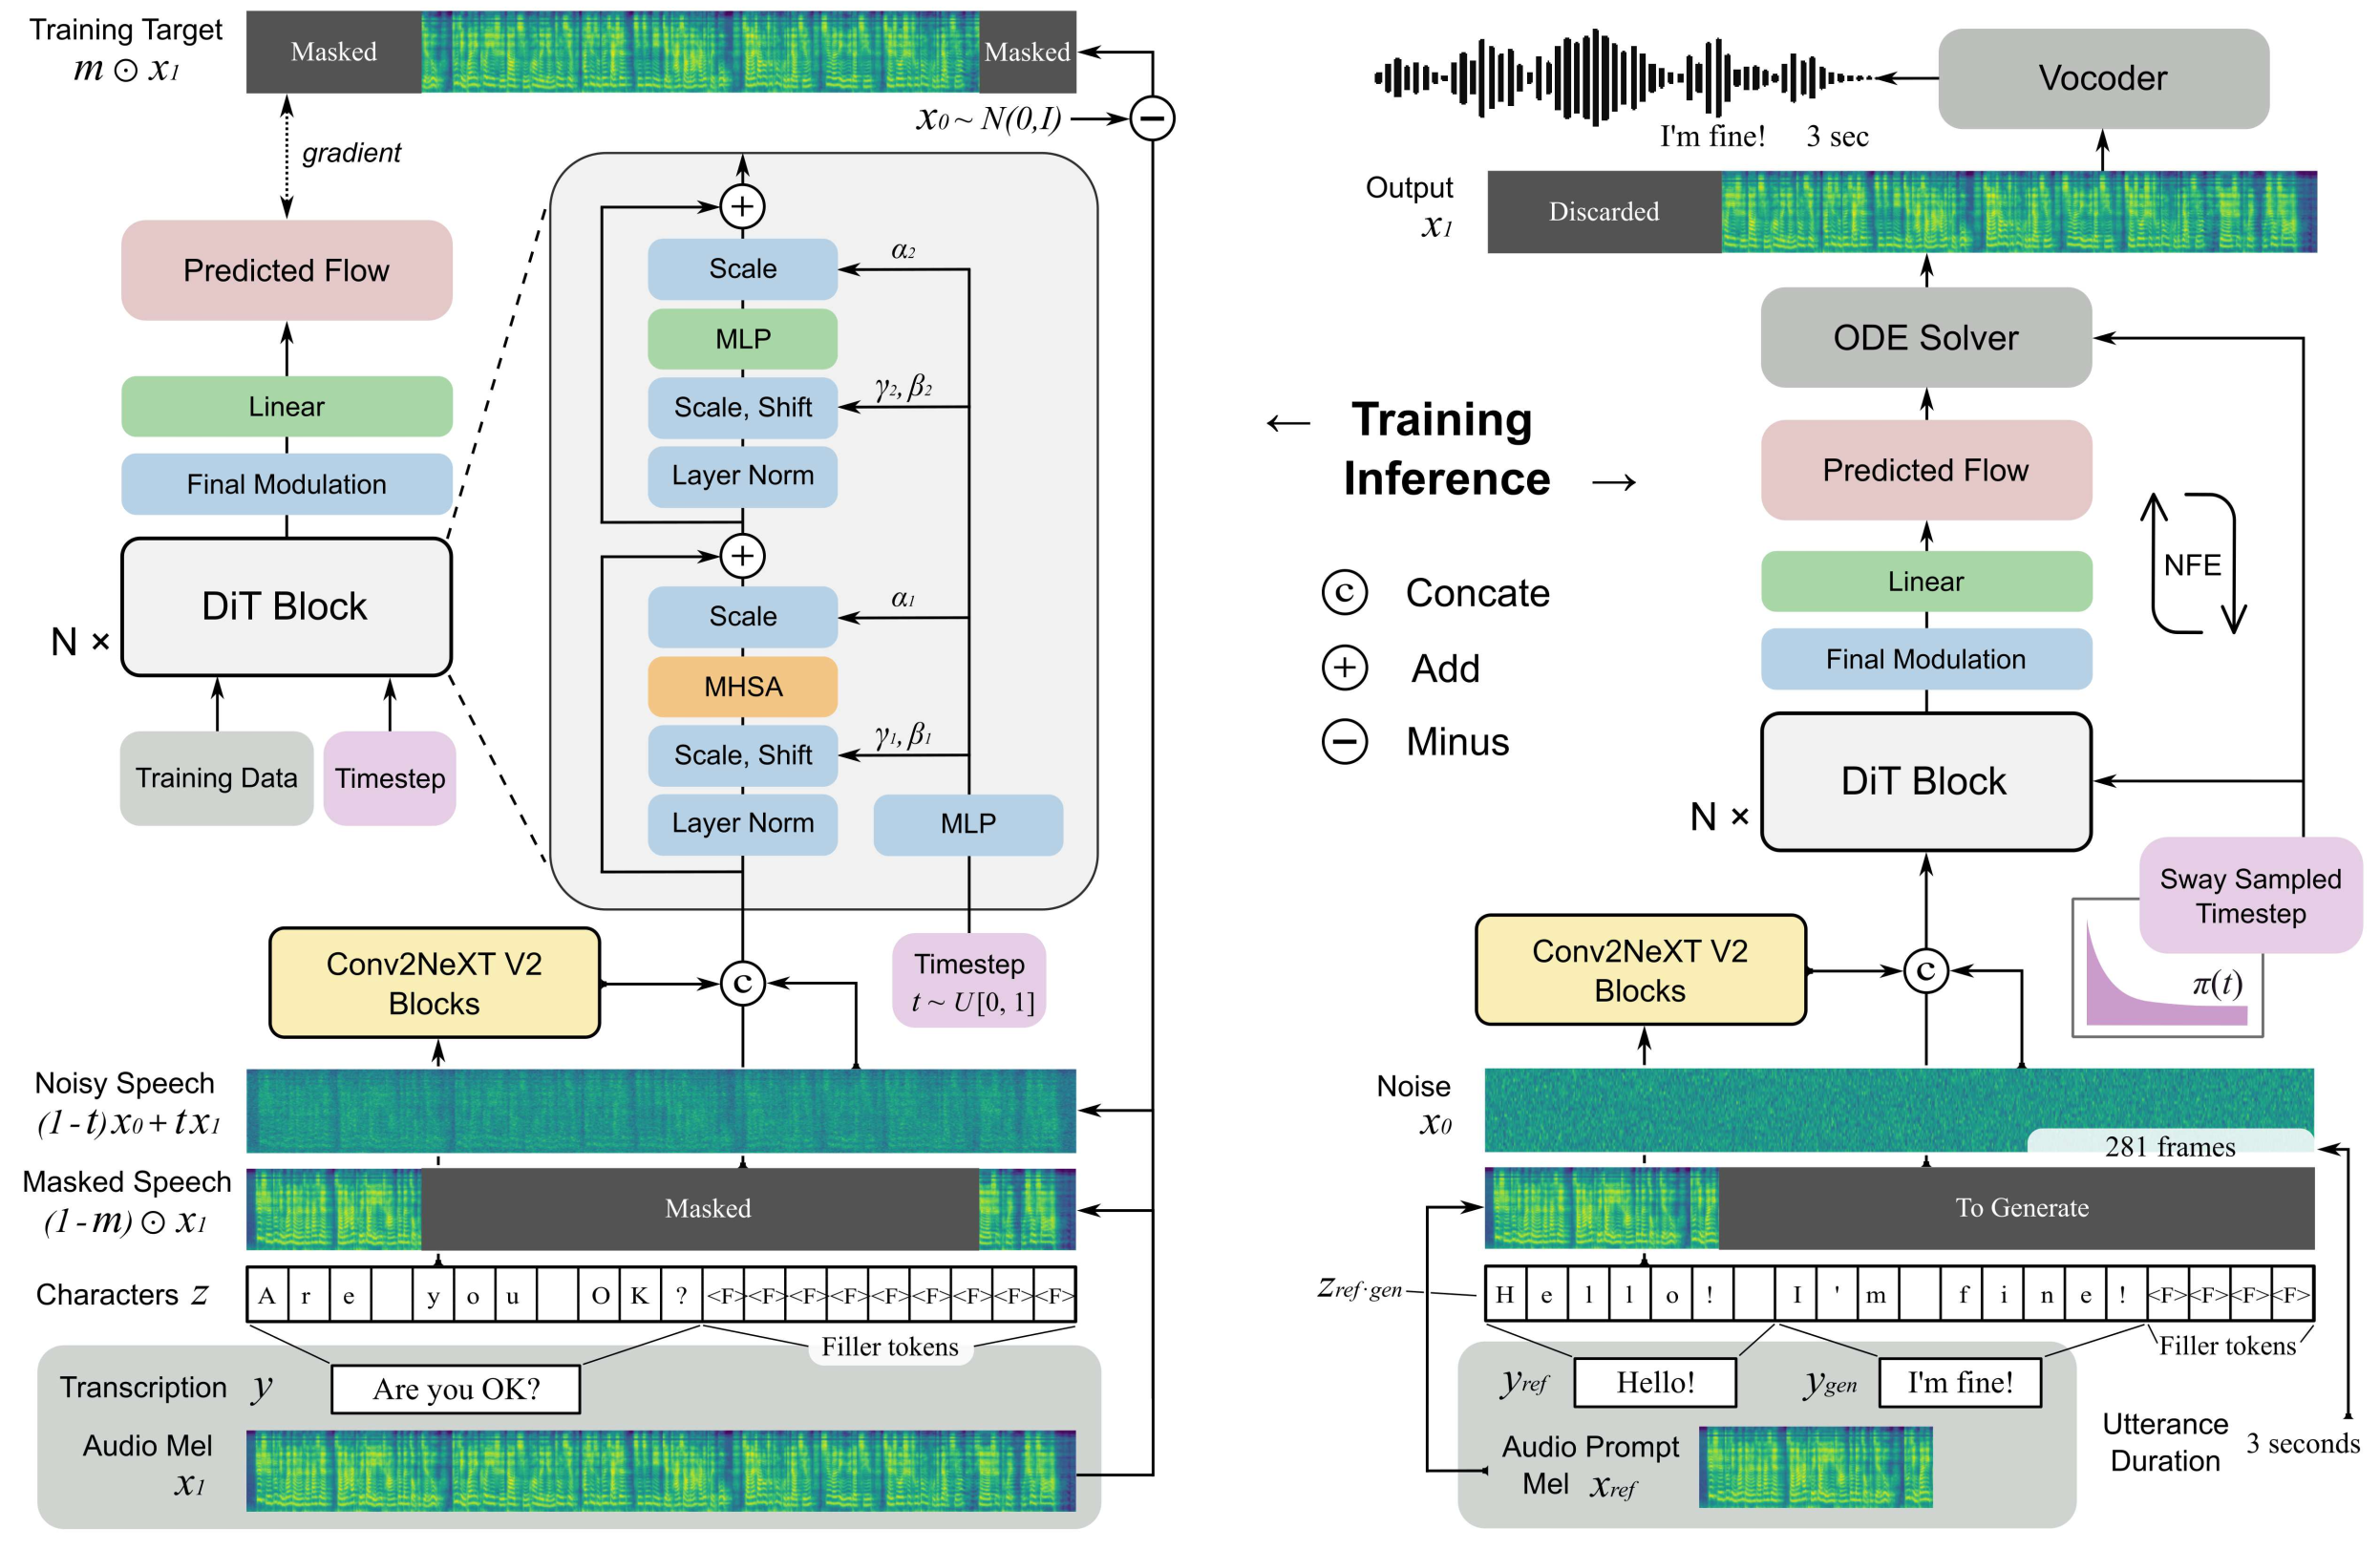
F5-TTS是一款基于流匹配和Diffusion Transformer(DiT)的非自回归语音合成系统。F5-TTS在E2-TTS的基础上进行改进,特别是在文本表示的细化和推理时采样策略上,这些改进使得F5-TTS在保持简单架构的同时,提供了更好的性能和更快的推理速度。论文中的指标上来看,F5-TTS模型的整体效果是超过CosySense效果的,只需要2秒音频就能合成超逼真的语音。它不像传统的系统那样一步一步生成语音,而是能够同时处理多个步骤,这让它的速度更快,实际测试并不能真正实时。非自回归(NAR)模型凭借 并行计算 优势在推理速度上表现优异,但人声相似度有待提升 ,后来F5R-TTS引入GRPO 强化学习 ,以 WER (语音识别词错误率)和SIM(说话人相似度)为双奖励指标,显著提升人声相似度。 F5-TTS利用ConvNeXt V2提取文本特征、DiT(核心骨干网络)计算特征**、Flow Matching生成完整的梅尔频谱** ,利用预训练好的解码器把梅尔频谱解码成声音。
2.4 MegaTTS3
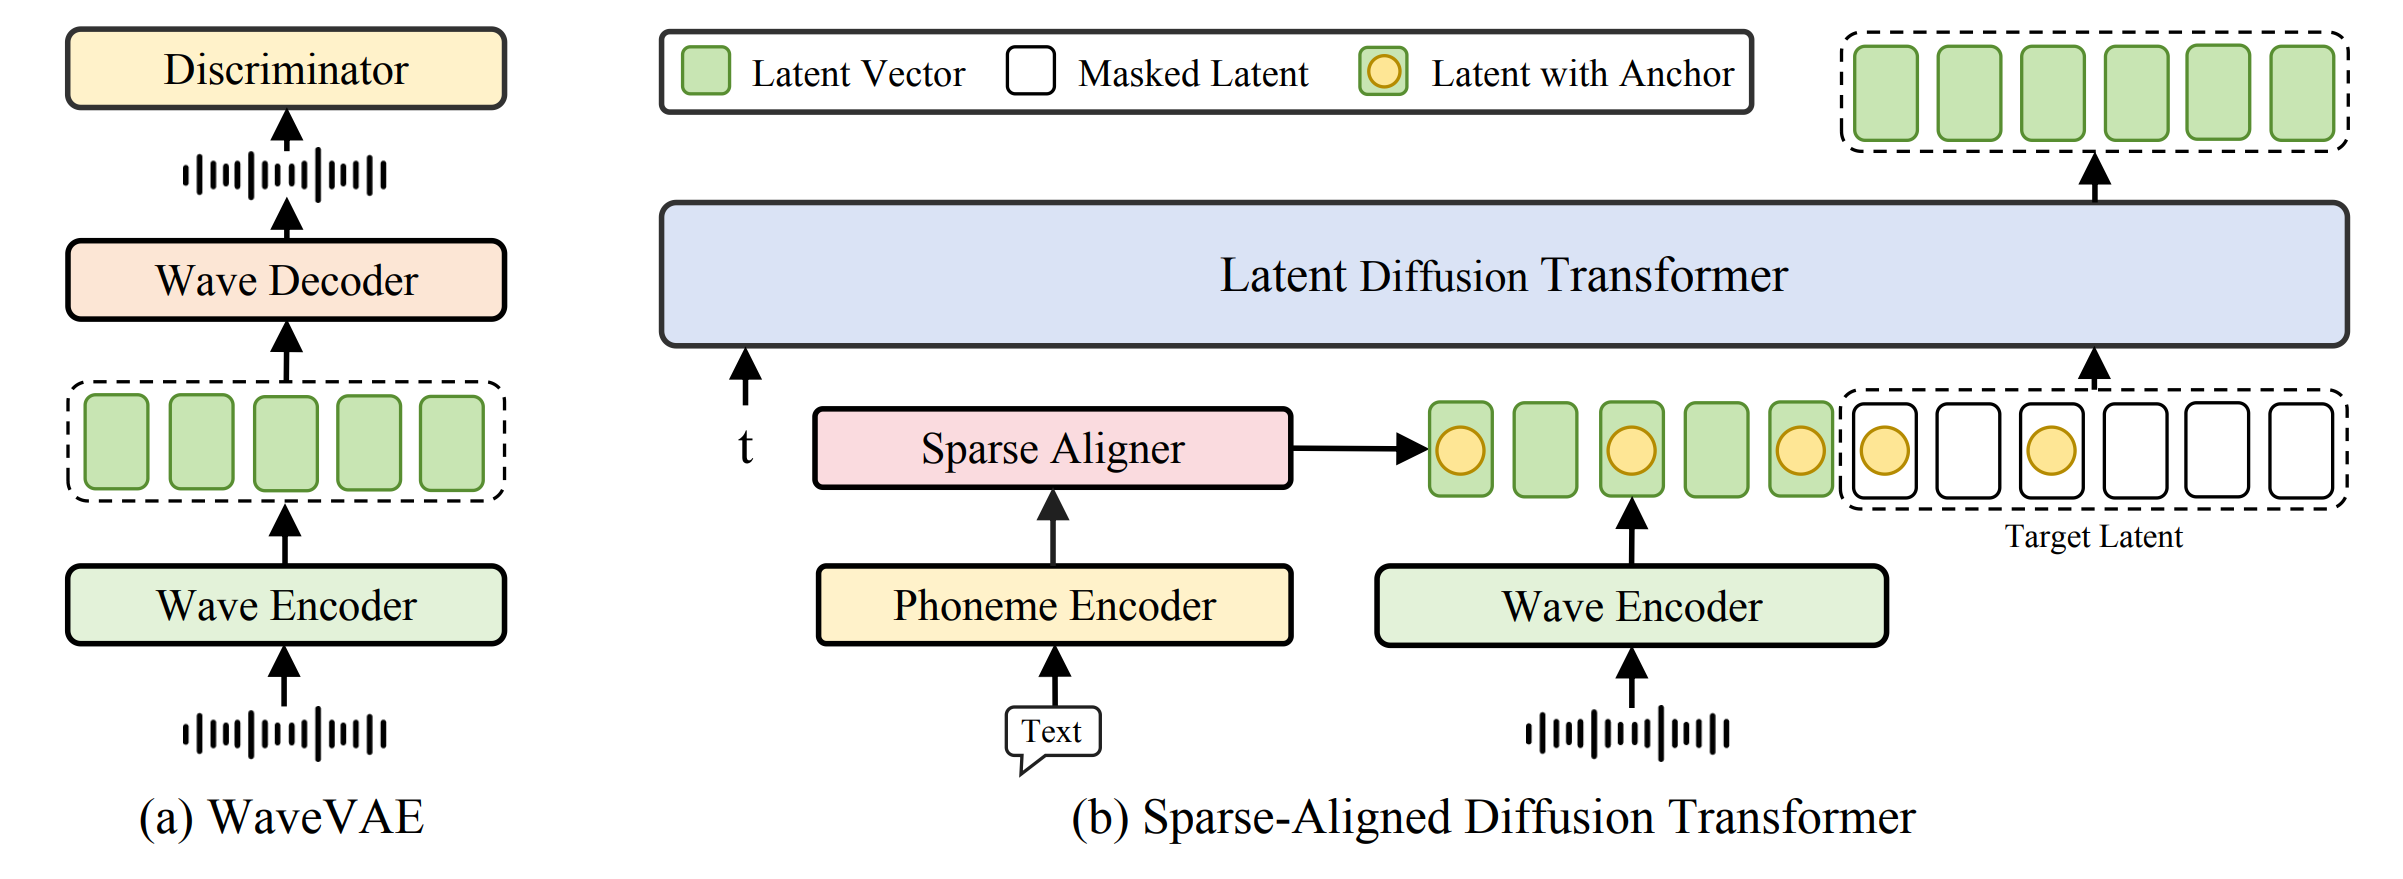
MegaTTS3参数只有0.45B,目前只支持中英两种语言,适于实时语音交互,MegaTTS3 采用WaveVAE+Latent Diffusion Transformer双模块协同合作,创造出超高质量的语音合成效果。
创新点:
a、WaveVAE:负责将原始语音信号压缩成潜在向量,并通过解码器进行还原,确保语音合成的高保真度;
b、DiT:通过自注意力机制对潜在向量序列进行建模,将文本和语音信号之间进行细致的对齐;
c、CFG:调整文本引导参数(αtxt)和说话人引导参数(αspk),用户能够控制语音的发音特征、口音强度等,进而定制更加个性化的语音输出;
d、PeRFlow:将生成过程分割成多个时间段,在每个时间段内进行快速计算 ,从而显著降低了采样步骤的数量。
实测声音不自然,速度离实时生成也有一定距离;
2.5 VITA-Audio
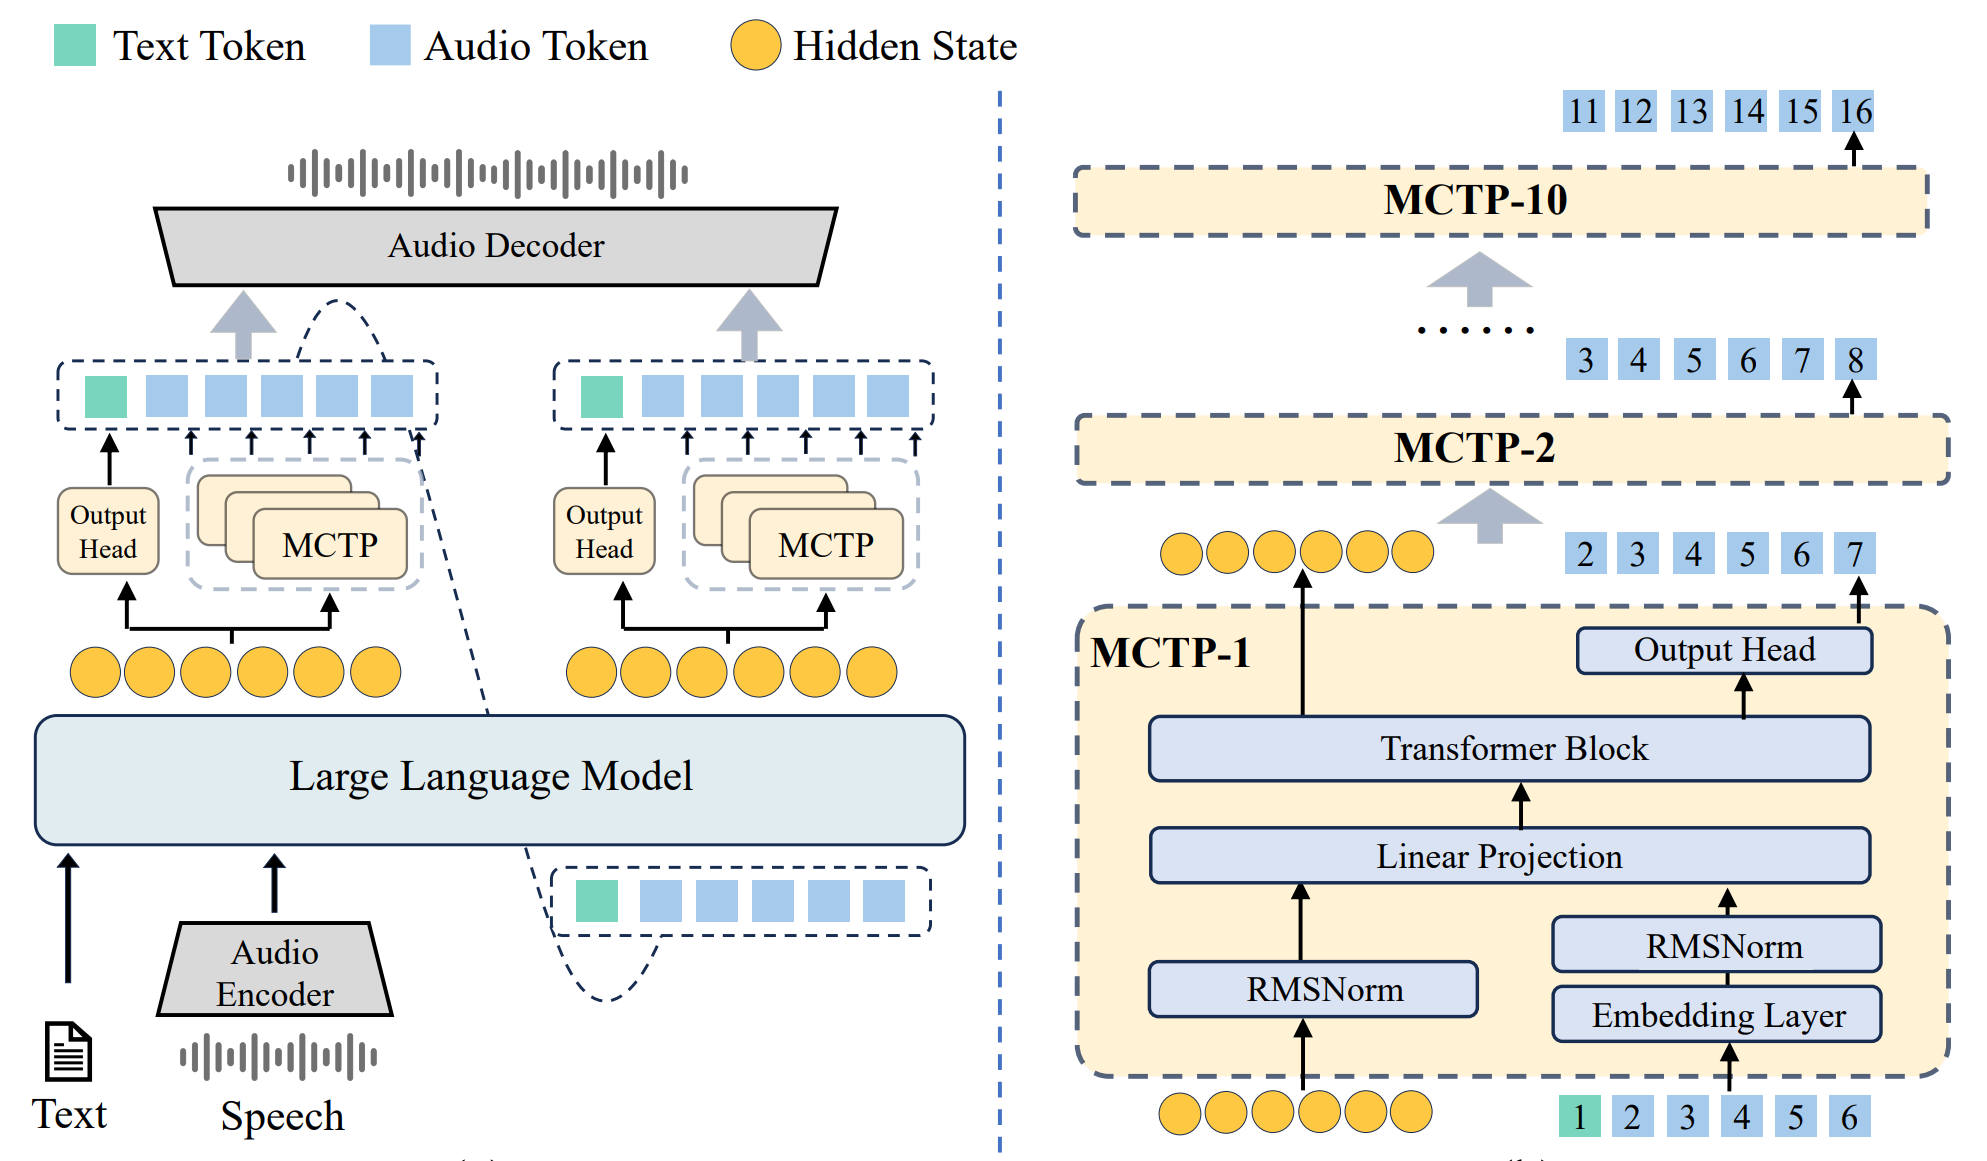
虽然已有多款语音模型,但它们在生成首个音频片段时仍存在较高的延迟,成为制约实时部署的关键瓶颈,VITA-Audio的核心组件包括音频编码器、音频解码器、LLM、十个轻量级 MCTP 模块。VITA-Audio同时配备了频谱编码器和解码器,借用的GLM-4-Voice等的编解码器,既支持语言识别又支持 语音合成 ,功能完善、速度明显提升。
创新点:
a、语音模型在预测某个音频Token时,对应的文本Token Hidden States所承载的注意力权重显著高于其他位置 ,语音生成并不需要对整个文本—音频序列的全局语义空间进行复杂建模,对需要的局部解码 就能生成正确的语音,MCTP小模块即可实现解码;
b、多个MCTP小模块直接在单次前向传播中预测到首个文本token就 并行 预测多个音频Tokens ,大幅减少主模型LLM的自回归循环次数,不仅加速了整体推理流程,更显著降低了流式场景下首个音频片段的生成延迟 ;
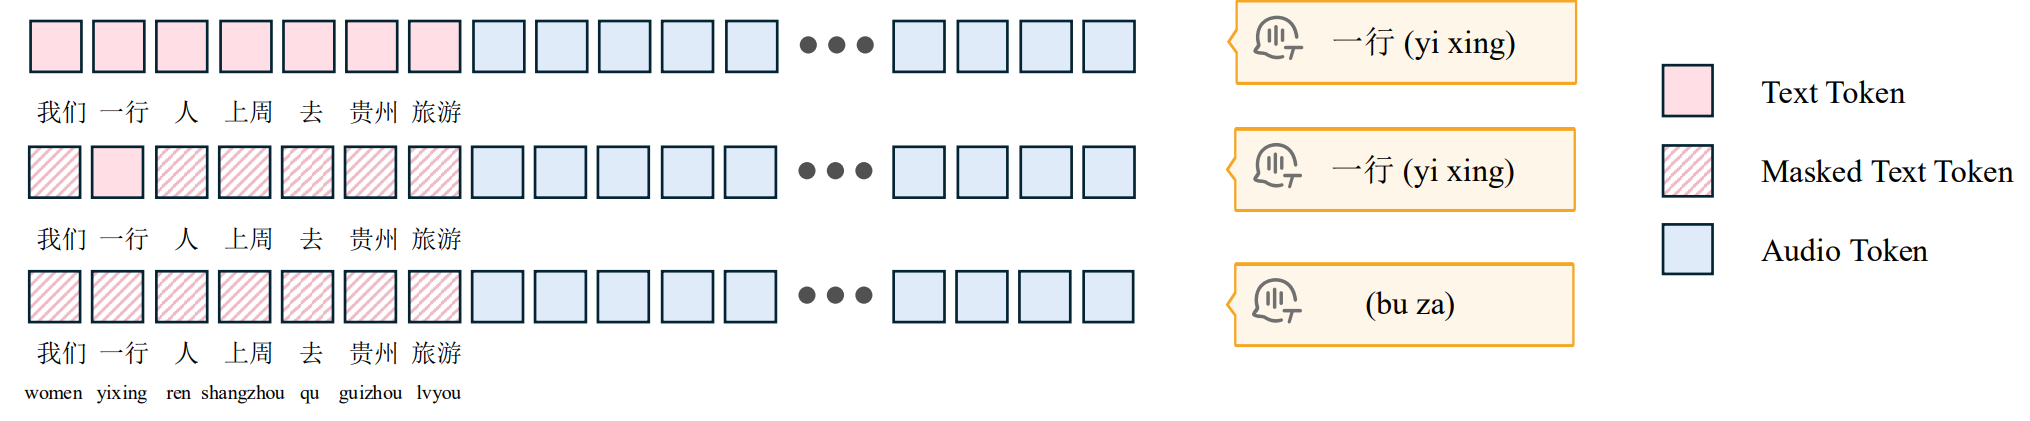
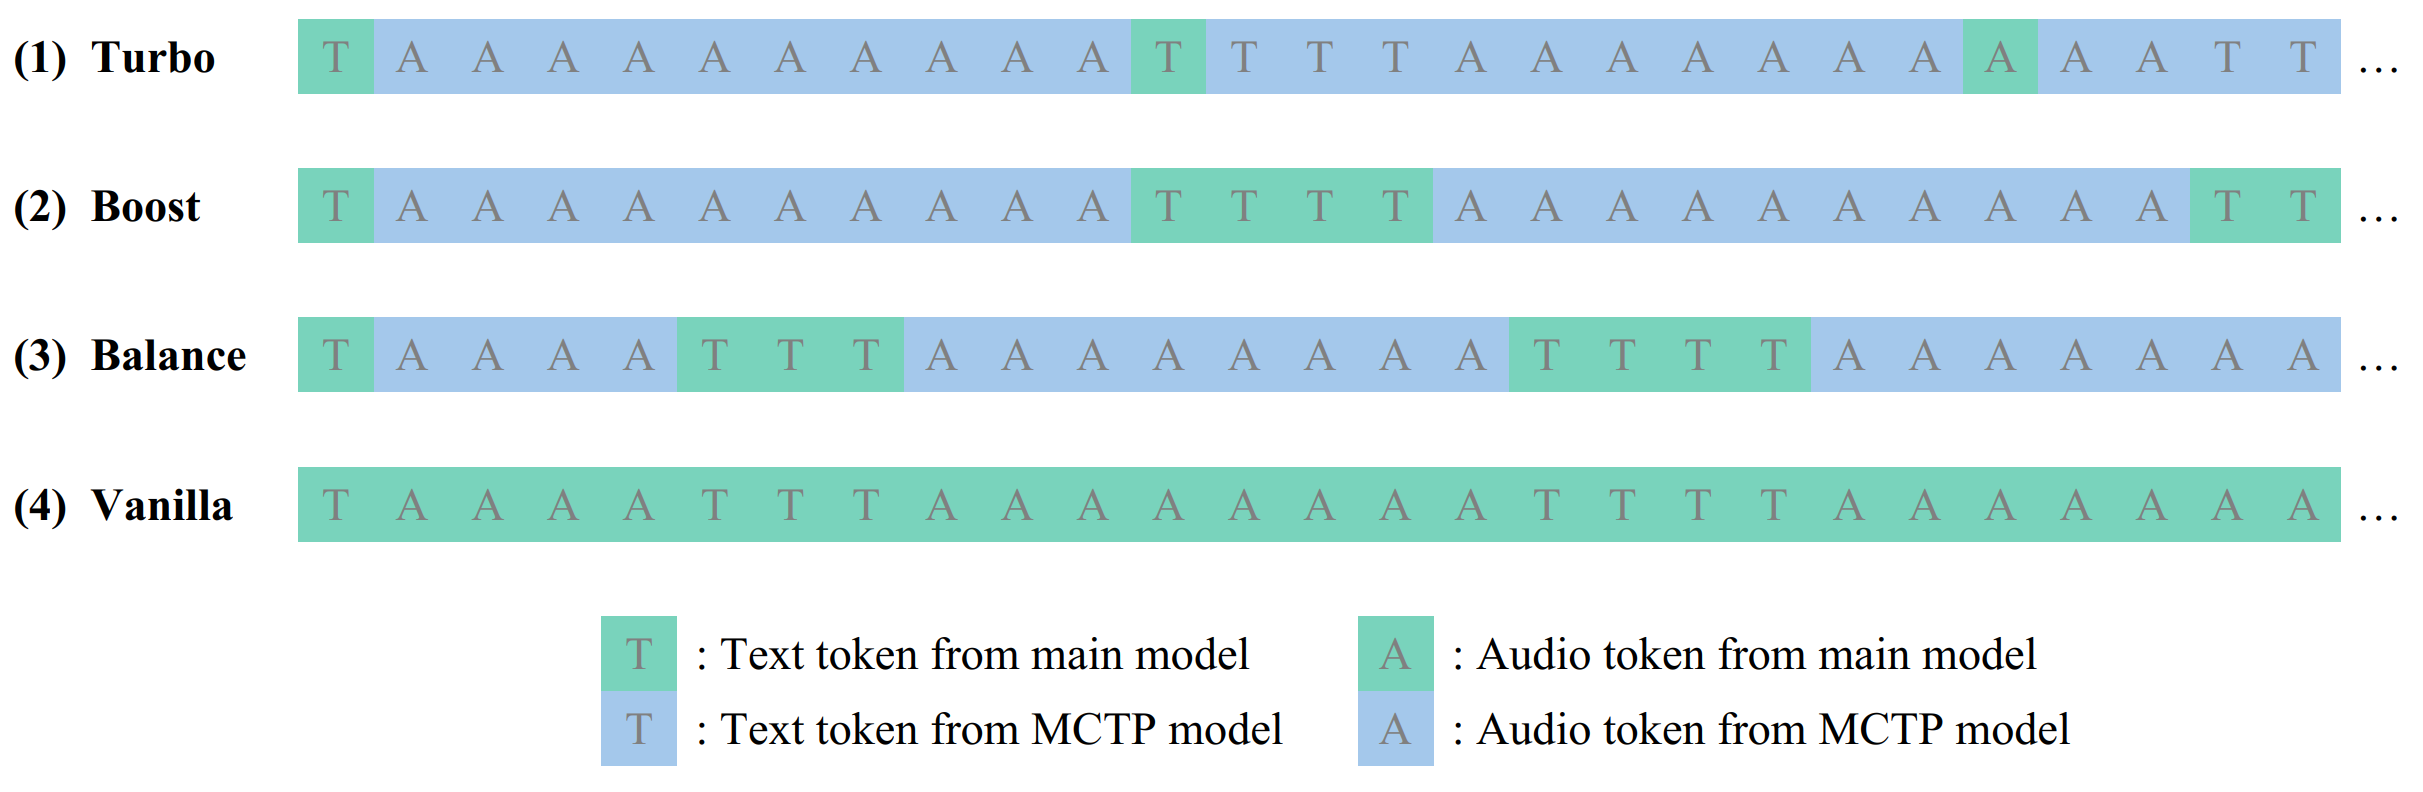
借鉴自DeepSeek V3的MCTP 并行 解码算法 ,将 LLM 最后一层的隐藏态和输出先输入第一个 MCTP 模块,其输出再依次传递给后续的 9 个 MCTP 模块,每个模块各自预测一个频谱Token,累计得到10个Token,并由音频解码器合成为音频片段, 小模块MCTP 生成频谱即可解码,而无需等待主模型LLM生成完整的一句文本tokens和一句频谱tokens之后才能解码(VITA-Audio的主LLM模型采用文本和频谱交错生成的方式)。由于每个 MCTP 子模块的参数量远小于 LLM,单次预测耗时仅需约 2.4 ** ms (约为 LLM 推理时间的 11%),显著降低了首个音频片段的生成延迟,并大幅提升整体推理速度。上图中,Vanilla为全由主模型生成文本和频谱tokens进行解码的普通解码方式,Turbo为增加MCTP模块至10个时并行解码方式,turbo可以将首个频谱token生成的延迟从236ms降到53ms,在 7B 参数规模下,VITA-Audio-7B 从接收文本到输出首个包含8个Audio Token的可解码片段仅需92ms;若不计入Audio Encoder时间,延迟进一步缩短至53ms ,** 整体推理速度相比同规模模型提升3–5倍,充分满足实时交互对低延迟的严格要求。
期间,OpenAI发布过gpt-4o-mini-tts支持用prompt来控制说话的语气、语调,对于讲故事、绘本、配音等场景会比较有用,但对于中文声音相似度来讲,OpenAI与国内声音合成模型相比明显比较古怪。另外,也存在一些效果优秀的G2P语音合成模型,如GPT-SoVITS,从VITS2 开始减少对音素转换的强烈依赖,GPT-SoVITS-v3采用GPT+Diffusion,VITS模块通过变分自编码器(VAE)将文本输入映射到隐变量空间,再通过对抗生成网络( GAN )生成梅尔频谱 ,最后转换为波形,能生成高度自然、接近真人发音的语音,但未来非G2P语音合成可能才是更有希望的方向。
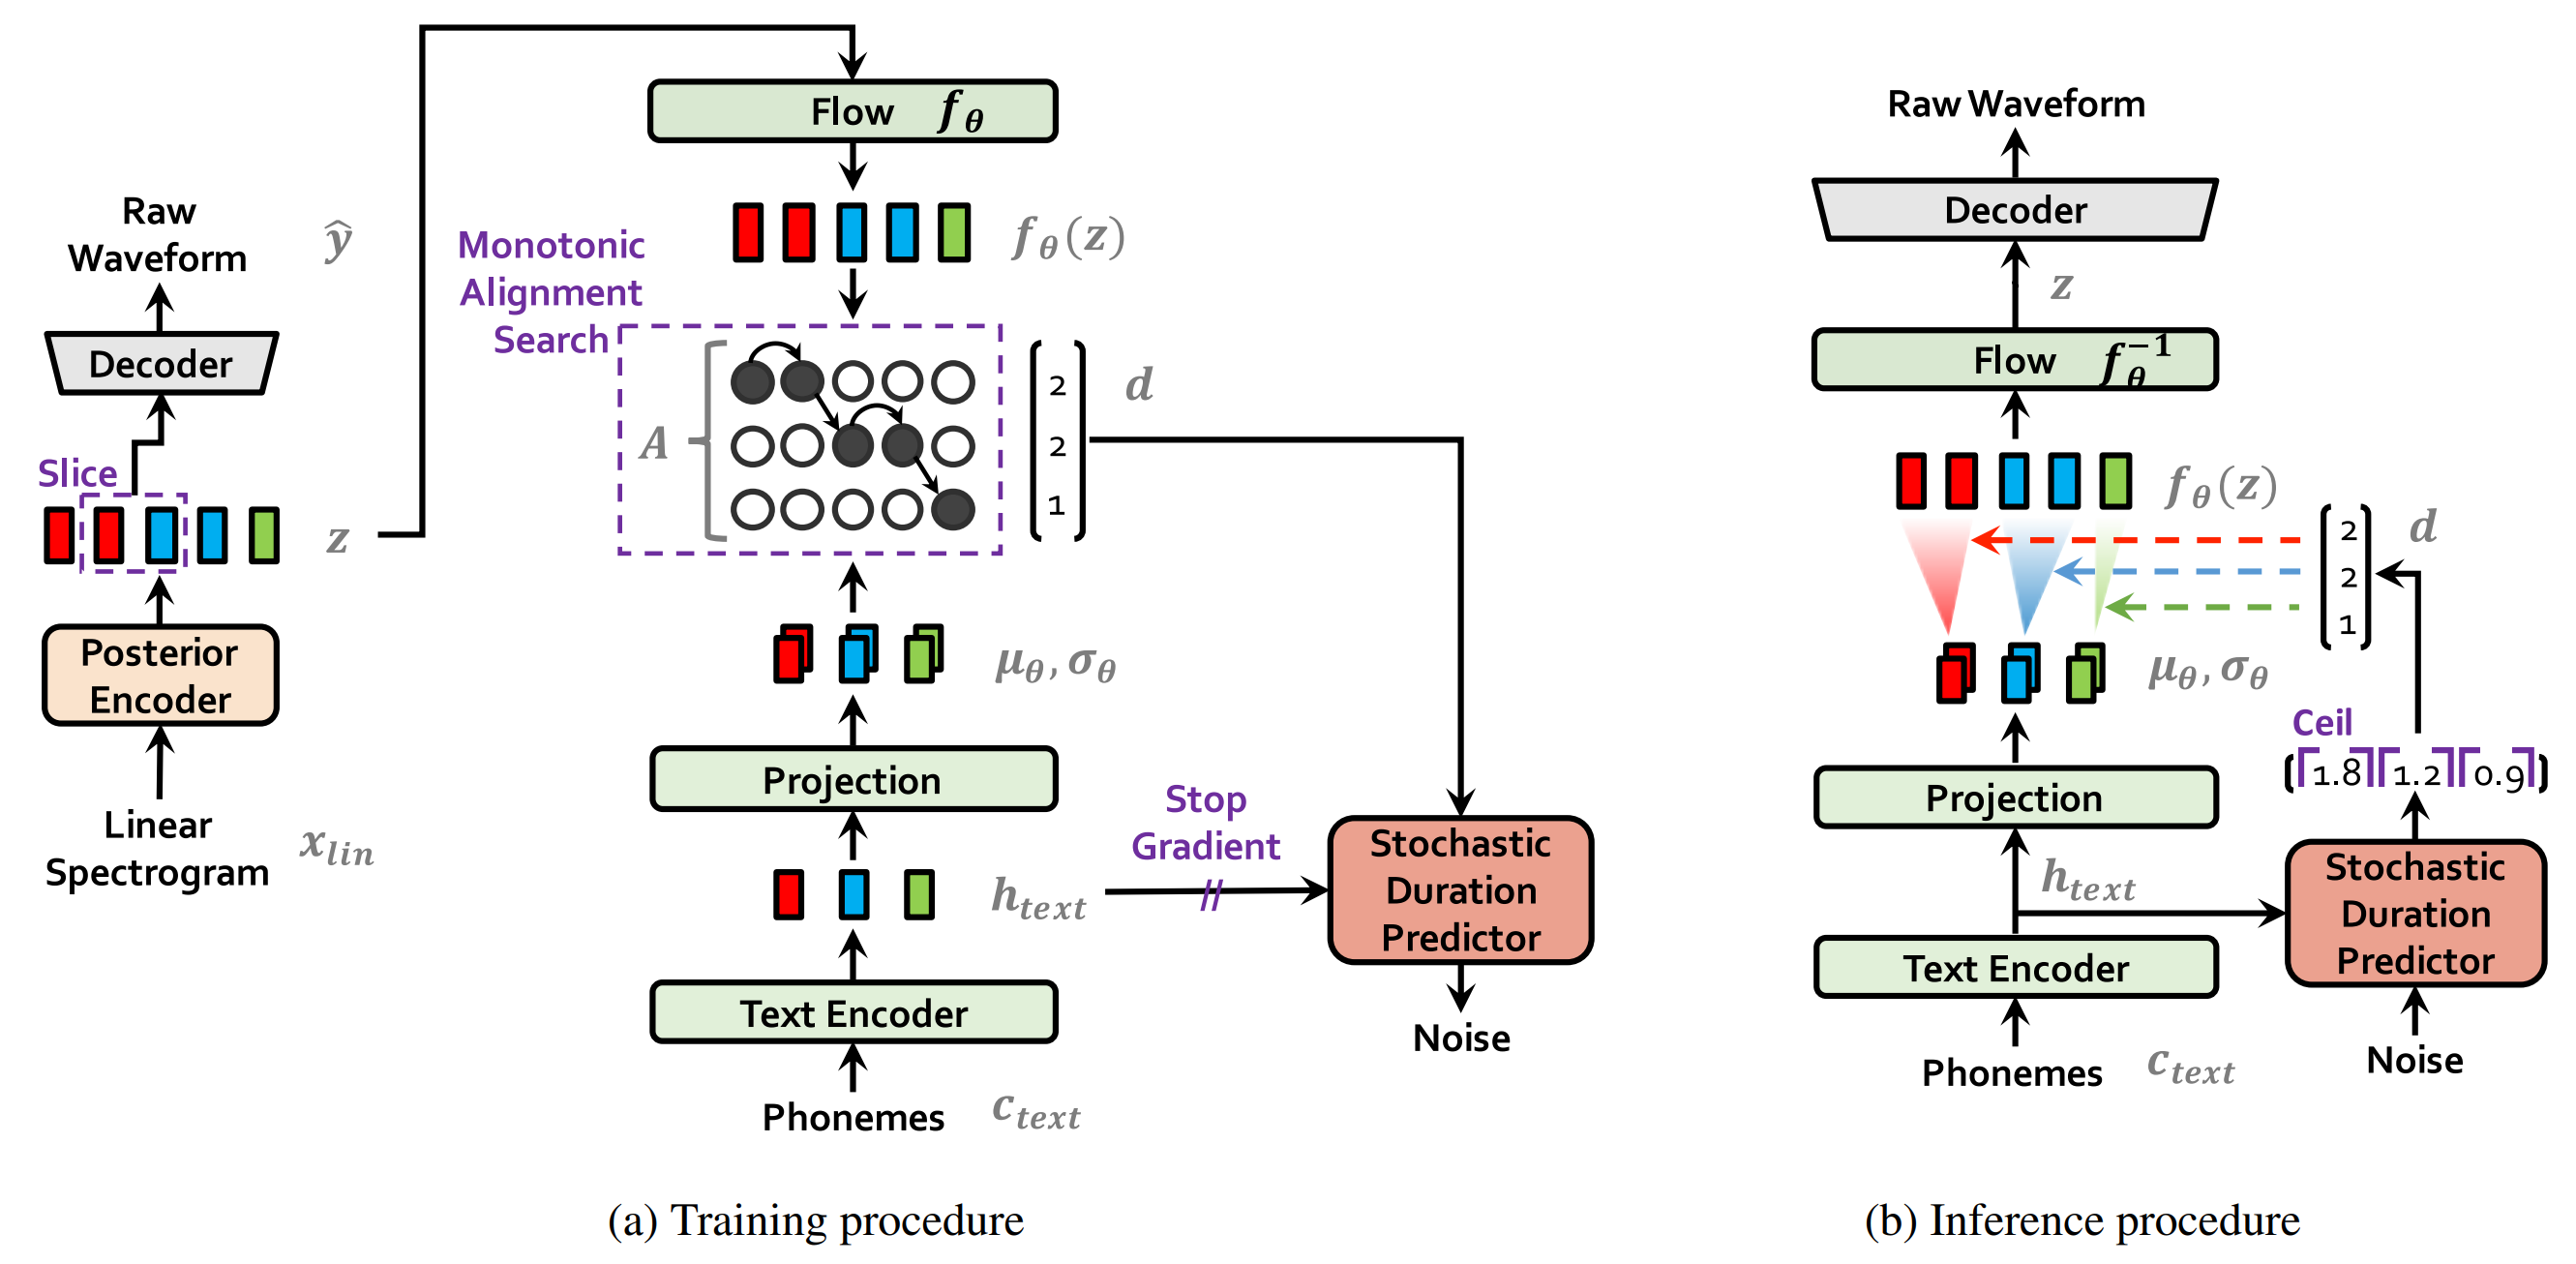
声音合成方面的研究人员比声音识别多,发布的模型也更多,以上为有一定影响力的主流声音合成模型。
三 、NLP
把音频当做一门语言,靠LLM搞定!
对于音频,效果好的主流语音交互模型的输入、输出现今都是梅尔频谱图或其他类型的频谱特征,一般用对数梅尔频谱,频谱与音频之间的转换不再像传统语音交互算法那么复杂,现在都是有专门的库进行调用,所以,语音交互的效果好坏就取决于频谱特征处理的模型 ,笼统一点来讲就是NLP模型决定成败,这就引发出两个问题:其一,当前NLP大语言预训练模型本身的效果并不完美;其二,NLP大语言预训练模型加入音频tokens后只是做了微调或强化学习。并未进行从头预训练,音频tokens和文本tokens之间对齐程度并不完美。因此,当前语音交互模型虽多,却找不到一个特别好用的,大部分责任不在于纯音频算法那个方面,从以上的语音识别和语音合成算法来看,关键还得提升NLP模型的精度和速度,它决定了现代音频算法的效果上限,但显然NLP的作用目前被忽视了,传统的语音交互是拼语音和文本之间的转换,因为那时候搞不定基本的音素和文字对齐,但现在拼的就是NLP,即语音交互算法中难的并不是语音部分,而是非语音部分(tokens计算模块),LLM 的问题才是语音交互的根本问题! 除了数据问题,对于精度和速度,算法方面可能比较好的优化方向:
a、提升音频编解码器和大语言模型精度可以提升隐式音素和字素的对齐程度和泛化能力;
b、强化学习可以提高人声相似度和对齐能力,预训练就引入RL可能进一步提升精度和人声相似度;
c、对抗网络GAN做频谱解码器可以提升人声相似度,若算力要求高可以视特殊场景的情况使用;
d、将语音识别进入大语言模型的频谱特征Encoder和语音合成大语言模型输出之后的频谱特征Decoder拆分成多个MCTP小模块可以提升语音交互计算速度,并行计算是必备元素;
e、将语音交互LLM的attention换成线性注意力机制提升速度;
f、引入MOE到语音交互降低计算量;
g、研究无裁剪(token、权重)版的强化学习算法较低特征提取损失提升人声相似度;
参考文献:
《Unified Streaming and Non-streaming Two-pass End-to-end Model for Speech Recognition》
《Robust Speech Recognition via Large-Scale Weak Supervision》
《FISH-SPEECH: LEVERAGING LARGE LANGUAGE MODELS FOR ADVANCED MULTILINGUAL TEXT-TO-SPEECH SYNTHESIS》
《FunAudioLLM: Voice Understanding and Generation Foundation Models for Natural Interaction Between Humans and LLMs》
《F5-TTS_ A Fairytaler that Fakes Fluentand Faithful Speech with Flow Matching》
《MegaTTS 3: Sparse Alignment Enhanced Latent Diffusion Transformer Zero-Shot》
《VITA-Audio: Fast Interleaved Cross-Modal Token Generation for Efficient Large Speech-Language Model》

 暂无数据 暂无数据
nb 顶!