Transformer大模型打开了人工智能的大门之后,人们对智能的渴望早已不止于和模型对话,带有错误结果的回答就更烦躁了,然而,互联网数据不够用了!基于统计学的算法体系,数据成了通往AGI最大的绊脚石 ,Meta公司为了突破AGI都已经迫不得已下血本向全世界挖顶尖人才了,下面咱们探讨两个目前大家争论比较火热的算法解决问题的方向:
一、RL对数据困境的作用
强化学习 ( RL )到底是让语言模型突破了 预训练模型 的知识边界,还是仅仅学会了更高效地走捷径?
为了回答以上问题,近期,人工智能领域的学者可谓是讨论得热火朝天,尤其是清华研究团队和英伟达研究团队不断争执,结论是反转再反转,不断反转中!
清华论文:《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》
英伟达论文:《ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models》
清华方:
过去人们认为,强化学习(RLVR)能让大模型(如GPT、DeepSeek-R1)在数学、编程等复杂任务中“自我进化”,解锁基础模型没有的能力。但清华论文进行了“学术打假”,通过大量实验证明:RLVR只是让模型更会“猜答案”,并未突破原有潜力 。论文提出,RLVR虽然让模型更擅长“快速找到已知解法”,但牺牲了探索新方法的能力,像培训班教出的“应试机器”。
# 研究者设计了一场特殊的开卷“考试”——pass@k测试:
短期提分快:小样本测试(如只考1次)时,RLVR模型得分更高(比如数学题正确率提升30%)。
长期潜力低:如果允许“无限次重考”(比如尝试256次),基础模型反而能解决更多难题!
论文主要创新点:
揭示了当前RLVR的根本局限性:论文通过大量实验证明,当前主流的RLVR方法并没有为LLM带来根本性的新推理模式,经过RL训练的模型,其推理能力的边界(上限)实际上是被其对应的基础模型(Base Model)所限制的,甚至在训练后这个边界还会收缩。
提出并系统应用了一种更准确的评估范式:论文指出,传统的评估指标(如pass@1,即单次尝试的成功率)只能反映模型的“平均表现”,无法衡量其“能力上限”,作者系统性地使用 pass@k(在k次尝试中至少有一次成功的概率)作为核心评估指标,特别是当k值很大时,它能更准确地探测模型的推理能力“天花板”。
证明了RLVR的核心作用是提升采样效率:论文发现,RL训练后的模型之所以在常规测试中表现更好,不是因为它学会了解决新问题,而是因为它能更大概率地、更快速地(在更少的尝试次数内)生成那些基础模型本来就能生成的正确答案,这本质上是一种分布上的“提纯”或“聚焦”,而非能力的“扩张”。
区分了RLVR与蒸馏(Distillation)的本质不同:通过对比实验,论文发现知识蒸馏(从一个更强的教师模型学习)可以真正地为学生模型引入新的推理模式,从而扩展其能力边界,这反过来凸显了当前RLVR方法的局限性。
论文用“搜索树”比喻模型思维:
- 基础模型:树枝分散,可能覆盖更多路径(包括正确答案)。
- RLVR模型:修剪枝叶,只保留“得分高”的路径,效率提升但探索受限。
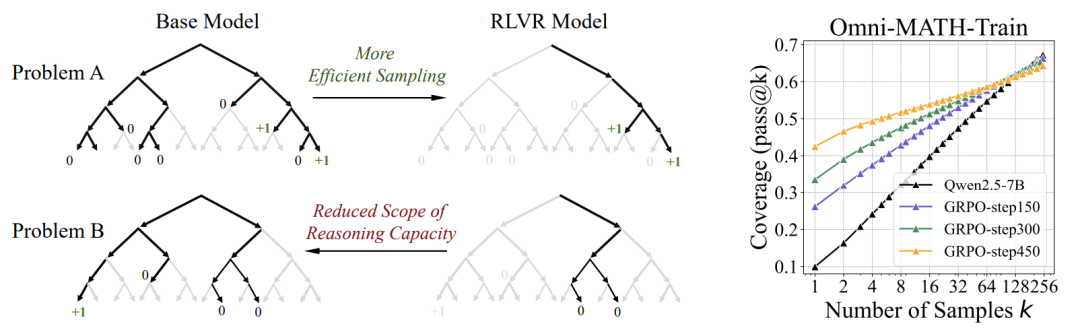
数学解释:RLVR通过奖励机制(如答案正确得1分)让模型输出分布偏向高奖励路径,导致输出 熵 降低 (多样性减少),就像学生只背标准答案,不再思考其他解法。
设计生活化比喻:图书馆寻书奇遇
想象一下,有一位非常博学的学者(我们的Base模型),他毕生所学都储存在一个巨大无比的私人图书馆里,这个图书馆藏书极其丰富,从主流的教科书到偏门的古籍手稿应有尽有,几乎涵盖了所有问题的解法。
然而,这位学者有个小毛病:他有点不拘小节,图书馆里的书摆放得有些杂乱。当你向他请教一个复杂问题时(比如一个奥数题),他会走进图书馆,随机从书架上抽一本书给你。
- 他第一次 就抽到正确解法的概率可能不高(这对应模型的**
pass@1**)。 - 但是,如果你给他足够多的尝试机会 (比如让他抽1000次,即**
pass@1024),只要图书馆里确实存在解法,他总能把那本正确的书找出来,这个图书馆的藏书量,就代表了这位学者的 知识边界或 能力上限**。
现在,来了一位应试教育专家,要对这位学者进行“强化学习特训”(即RLVR训练 ),目标是让他能更快地回答问题。专家的做法是:
- 拿出大量标准考题让学者练习。
- 学者每次从图书馆找一本书作答。
- 如果答案正确(获得奖励 ),专家就让学者在这本书上贴一个大大的“重点 ”标签,并把它放到最显眼的书架上。
- 如果答案错误,专家就让学者把这本书塞到角落里。
经过一番特训,学者(现在是RL 训练后的模型 )发生了变化。当你再问他问题时,他会优先从贴满“重点”标签的书架上找书。论文《OMEGA: Can LLMs Reason Outside the Box in Math? Evaluating Exploratory, Compositional, and Transformative Generalization》也提到类似观点:RL过度拟合特定模式,缺乏灵活组合的元能力。
清华方雄辩地证明了:RLVR提升了模型的“平均表现”,却牺牲了其“潜力上限”。
英伟达方:
基座模型原来搞不定的事!基座模型表现越差的任务,RL提升越大,基座模型表现越差的任务,RL提升越大。问题出在训练时间太短(通常仅几百步)!提出:延长训练=解锁“隐藏技能”。
基座模型死活解不开的题(如逻辑谜题),ProRL模型竟能100%通关!
创造力暴涨:模型生成全新解题路径(通过Creativity Index量化)。
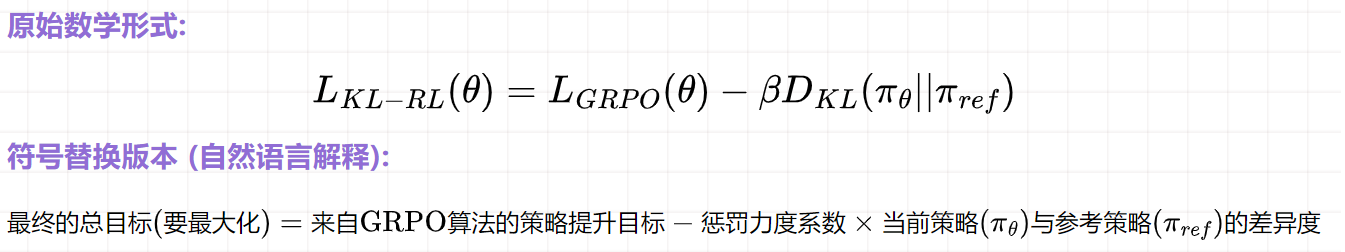
ProRL的核心是改进了传统的RL目标函数:
论文主要创新点:
提出ProRL (Prolonged RL) 训练方法:这不单指“训练更长时间”,而是一套完整的、能确保RL训练在数千步上保持稳定并持续进步的技术配方(recipe)。
证明RL能拓展推理边界:通过实验证明,经过ProRL训练的模型能够解决其基座模型(base model)在任何采样次数下都无法解决的问题,这为“开拓者”观点提供了强有力的证据。
发现RL增益的规律:论文发现了一个有趣的现象——RL带来的能力提升与基座模型的初始能力负相关。也就是说,基座模型越“笨”的任务,通过RL学习后提升的空间越大。
发布了一个强大的1.5B参数通用推理模型:他们训练并开源了Nemotron-Research-Reasoning-Qwen-1.5B模型,该模型在1.5B的参数量级上,在多个推理基准上达到了世界顶尖水平,甚至超过了一些更强的专有模型或尺寸更大的模型。
延长 RL 训练会遭遇模型摆烂( 熵 坍塌)和性能倒退 ,团队用了以下方法稳住长期训练:
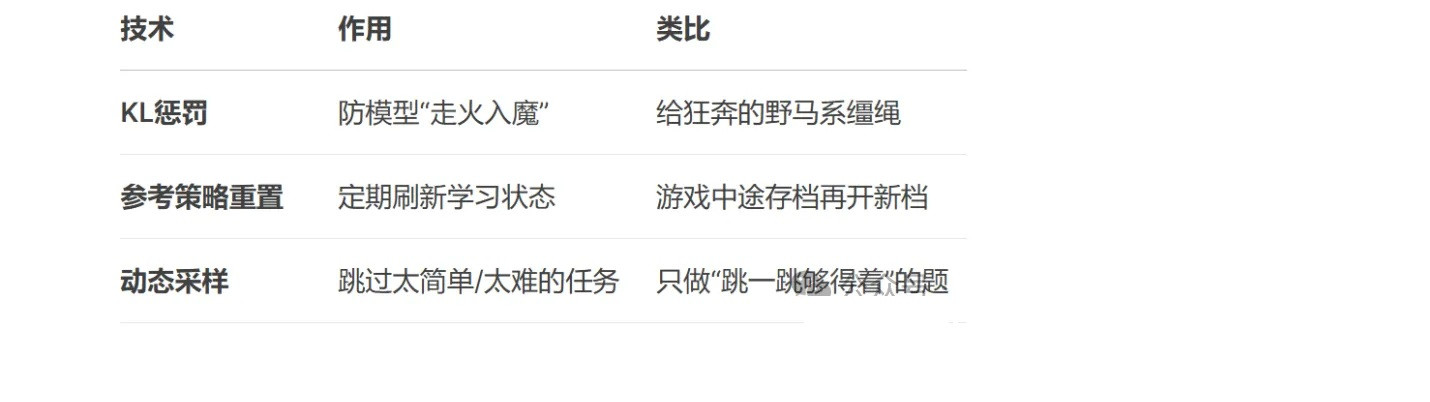
NVIDIA用钞能力证明:面对模型推理能力的瓶颈,没有什么问题是再来一千次强化学习迭代解决不了的,如果有,那就再来一千次。参考策略重置 (Reference Policy Reset)本文的核心技巧,理解为什么需要重置,以及重置如何解决KL散度带来的训练瓶颈 ,是理解ProRL精髓的关键。
结果:
从0到1的突破:最引人注目的结果是,在多个任务上,基座模型无论采样多少次,成功率都是0,而经过ProRL训练后的模型,成功率可以达到接近100%,这直观地展示了模型学会了“无中生有”的能力。
持续学习的证据:有模型即使在进行了2000多次训练步后,模型的性能(和)仍在持续提升,打破了“RL训练很快就会饱和”的传统印象。
新颖性的量化:通过引入“创造力指数”(Creativity Index),论文从量化角度证明了模型生成的解题路径与预训练语料库中的常见模式重叠度更低,说明模型确实在创造“新”的解法。
最具挑战性的部分在于理解这三个概念**(** 熵 坍塌、KL散度、策略重置)之间动态的、相互制约的关系 。它们共同构成了一个精妙的平衡系统:
- 熵坍塌是我们要避免的问题。
- KL散度是解决这个问题的初步方案,但它本身会引入新的问题——限制探索。
- 参考策略重置是解决“限制探索”这个新问题的最终方案,它使得长期训练成为可能。
设计生活化比喻:一位新手厨师的成长之路
想象一下,有一位名叫“小模”的新手厨师 (他就是我们的LLM **模型 ** ** π_θ ** )。他的目标是学习制作各种复杂的创意菜肴(解决推理任务 )。
- 初学阶段与“熵 坍塌” 小模刚开始学习,手上只有一本《家常菜谱大全》(**初始的参考模型 ****
π_ref**)。他偶然发现,做任何菜都撒上一把万能调料(比如十三香),顾客(奖励函数 )的评分都还不错。于是,他开始偷懒,不管做什么菜——法式焗蜗牛、日式寿司、中式佛跳墙——他都狂撒十三香。- 这就是“熵 坍塌” :小模的做菜风格变得极其单一(输出熵 降低),他不再尝试其他烹饪方法(探索 停止),虽然短期内评分稳定,但他的厨艺再也无法进步了。
- 引入导师与“KL散度正则化 ” 一位严格的导师(RL****算法 )发现了这个问题。导师对小模说:“你可以创新,但你的做法不能离《家常菜谱大全》太远。每次做菜,我不仅会根据顾客评分给你打分,还会看你的做法和菜谱的‘偏离度’。偏离得越远,扣分越多!”
- 这就是“KL散度正则化 ” :导师引入了一个惩罚项 。它像一根无形的缰绳 ,将小模的烹饪手法(当前策略
π_θ)拴在了《家常菜谱大全》(参考策略π_ref)上。这迫使小模不能只依赖“十三香”大法,而是要在菜谱的基础上进行微小的、安全的创新。
- 这就是“KL散度正则化 ” :导师引入了一个惩罚项 。它像一根无形的缰绳 ,将小模的烹饪手法(当前策略
- 成长的瓶颈 在导师的指导下,小模的厨艺大有长进,他已经是一位出色的厨师了。但他感到了瓶颈。他想尝试一些分子料理或低温慢煮等非常前卫的技巧,但这些技巧在《家常菜谱大全》里根本没有!只要他一尝试,导师就会因为他的做法“偏离菜谱太远”而给他很低的惩罚分,导致他最终的综合评分很低。
- 这就是KL散度带来的停滞 :那本《家常菜谱大全》已经束缚 了小模的成长。缰绳的锚点太靠后了,让他无法迈向真正的大师殿堂。
- 更新教材与“参考策略重置” 聪明的导师看出了问题所在。他做了一个决定:他把小模过去一段时间所有成功的、广受好评的菜品做法整理成一本新的、更高级的菜谱,称之为《米其林星厨进阶指南》。然后,他把旧的《家常菜谱大全》收走,对小模说:“从今天起,这本《进阶指南》就是你的新参考标准了!你可以在它的基础上继续创新!”
- 这就是“参考策略重置” (Reference Policy Reset):导师将参考策略 从最初的基座模型 更新为了当前已经训练得很好的模型 。这相当于把缰绳的锚点向前移动到了新的位置 。小模现在可以自由地在更高的起点上探索,而不会因为背离最初的“家常菜”做法而受到惩罚。
通过这样周期性地更新参考菜谱 ,小模的厨艺得以螺旋式上升,不断突破自我,最终成为一代宗师。
英伟达方雄辩地证明了:经过长时间、稳定 RL 训练(ProRL)的模型,其推理能力超越了基座模型,甚至可以解决基座模型完全无法解决的问题。
英伟达与清华的意见刚好相反,不过英伟达的更为高明之处在于把 大模型 的知识库都更新了来提升上界 ,在他们对战的同时,其它学术研究者也没闲着,有提出支持清华方的学者,有提出支持英伟达方的学者,也有提出其它意见的作者,比如,论文《Spurious Rewards: Rethinking Training Signals in RLVR》提出RL训练中故意用错奖励数学基准也显著提升,RL都要被质疑是否有意义了,引爆了AI界引爆了 AI 界,他们发现:使用虚假奖励训练 Qwen2.5-Math-7B 模型也可以提高 MATH-500 的成绩,如果是随机奖励,成绩能提高 21%,如果是错误奖励,成绩能提升 25%(真实奖励能提升 28.8%),并且得出结论:RLVR 的有效性更多地取决于预先存在的模型能力,而不是监督信号的质量,在预训练期间学到的推理模式会严重影响下游的 RLVR 训练行为。
格式奖励:仅因答案包含 \boxed { } 而给予奖励 —— 因答案包含 \boxed {} 表达式而给予奖励。此格式也是系统提供给模型的提示中指定的格式,从而提供了一种「提示遵循」的概念。
随机奖励:完全任意的反馈 —— 字面意思:1 if (random.random () < rate) else 0
错误奖励:故意设置错误的监督信号 —— 获取错误但可信的标签的步骤。
论文《Sample, Don’t Search: Rethinking Test-Time Alignment for Language Models》提出不搜索只MCMC采样 效果就能超越DPO,论文观点:
# 论文主要创新点
提出QALIGN方法:这是一种全新的测试时对齐(test-time alignment)方法,它能够随着测试时计算量的增加,稳定地提升模型性能,而不会像BoN那样出现性能下降。
理论上解释了BoN的缺陷:论文首次从理论上揭示了为什么Best-of-N方法会“过优化”,它指出,增加BoN的样本数量,相当于用一个越来越“苛刻”和“极端”的标准去筛选答案,这放大了裁判模型自身的缺陷。
实现了无需访问模型内部(logits)的对齐:QALIGN方法非常灵活,它只需要模型具备“生成文本”和“补全文本”的能力即可,不需要获取模型内部复杂的概率分布(logits),这使得它可以应用于那些通过API提供服务的闭源模型。
# 支撑创新的关键技术或方法
马尔可夫链蒙特卡洛(MCMC):这是QALIGN的核心技术。传统方法是生成一堆独立的答案然后筛选,而QALIGN则是生成一个答案,然后在这个答案的基础上进行“修改”和“演化”,形成一个答案链条,这个过程被设计成能够逐步逼近一个“理想的答案分布”。
最优对齐分布(Optimal Aligned Distribution):论文定义了一个理论上的目标——这个分布既包含了原始模型的知识,又融入了裁判模型的偏好,QALIGN的目标不是找到这个分布中概率最高的单个点,而是从这个分布中进行“采样”,得到一组高质量且有代表性的答案。
最小贝叶斯风险(MBR):在通过MCMC得到一系列高质量的候选答案后,需要一种方法来选出最终的那个,对于开放式问题,MBR通过选择那个与“候选答案集里其他所有答案最相似”的答案,来确保最终结果的鲁棒性和代表性。
论文《A Minimalist Approach to LLM Reasoning: from Rejection Sampling to Reinforce》提出GRPO=高级版拒绝采样 ,有一些非常简单的方法,比如 RAFT(拒绝采样),就是只用模型答对了的样本进行微调,似乎效果也不错,相比之下,GRPO 中使用的那种根据同一题目下不同回答的好坏来做奖励 归一化 的技术,影响并不大 ,GRPO 强大的核心在于“样本剔除”:
通过详细的消融实验对比  Reinforce  的各种变体,发现GRPO性能优越的关键在于剔除了那些所有生成答案都错误的样本(“Remove all wrong”)。这些全是错误的样本对训练的干扰最大。
相比之下,奖励归一化(如减去均值或除以标准差)对性能提升作用不大,甚至简单的均值归一化还会导致训练不稳定。
剔除所有答案都正确的样本(“Remove all correct”)帮助也不大。
同时剔除“全对”和“全错”样本的策略(称为  Reinforce-Rej  )在性能、稳定性和保持探索性之间取得了不错的平衡。
综上,对于强化学习的看法,画风比较奇怪,有人说奖励好坏不重要有奖励 就起作用,有人说奖不励奖励都不重要高质量数据采样 就行,比清华方和英伟达方的脑洞开得还大,但是他们都有一个共同点,就是结论中都存在合理的部分和不合理的部分以及夸大其词的部分,我们必须要辩证地看待正确与错误的部分,强化学习这种方法的效果在实践中已经验证,的确有效,因此强化学习训练之后模型能力比预训练模型更差很可能是有些地方搞错了,但是目前的强化学习算法显然还有待优化,有人发现的问题可能却是目前强化学习的某个具体算法的缺陷导致的,并不是强化学习这个方向有问题,不过,RL虽然有效,但效果也并不是想象的那么神奇,对于大模型,越大的模型参数量越多,从统计学上来讲,维度越多能够学到的 范式 可能越多,范式越多之后能够把预训练模型记忆的知识用得更好 ,甚至能偶然碰巧解答一些人类没有解决的问题,同时,它存在幻觉,歪打正着不是不可能,但通常的情况,强化学习原则上会受到预训练模型知识上限的限制,它的推理和人类的推理有着本质的区别,而且,至少目前大模型与人类主动学习、探索知识的能力远远不在一个级别,当前的强化学习算法还最多只是皮毛上的模仿,除非发展都有一天,某个新算法使得大模型出现了较强的真正的主动学习、探索知识的动机和能力,即机器人觉醒了,那人类的命运就可能就要悲剧了,除非人类不让机器人以人形的方式存在,否则人类没有可能性是人工智能的对手,但目前来看大模型仅仅相当于一个高级一点的 搜索引擎 ,最多只能称之为模仿。而提到模型具有自主学习能力,就不得不提到下一节的自主学习算法。
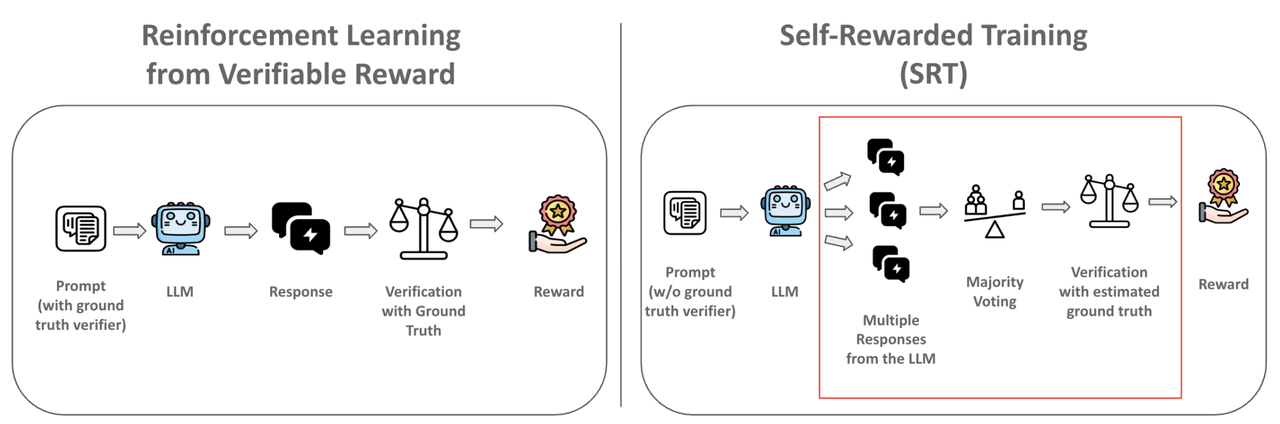
二、SRT对数据困境的作用
RLVR是当前非常看好的方向,但不用标注数据直接把数据喂给模型自学成才是更迷人的方向,但也更像精神鸦片,极具诱惑性却落地渺茫。
在 RLVR 方法中,系统通过真实验证器生成用于 强化学习 训练的奖励信号,与之相反,SRT 方法并不依赖真实验证器,而是通过模型自身生成结果的多数 投票****机制来估算真实值,并利用这一替代性奖励信号来训练模型 ,该方法能在强化学习训练期间,通过模型生成的多个解决方案之间的一致性来评估正确性,从而在没有标注数据的情况下提供自监督信号,但缺点是SRT目标定义的强化学习优化问题明确鼓励输出之间的一致性而不考虑其正确性导致训练崩溃,研究人员经常遇到,当模型对任务缺乏先验时(如在困难的数据集上),多数投票会反而强化错误预测 ,导致性能下降。
最近比较有代表性的论文《Can Large Reasoning Models Self-Train?》提出了一些缓解方法:
i)早停(Early Stopping):一个小的验证集可以可靠地检测到模型的最佳性能点,并防止在自我训练过程中发生崩溃,对于所有的留出集(heldout sets),最佳性能点几乎出现在同一位置,因此使用任何一个留出集进行早停都是有效的;
ii)使用离线生成的标签进行自我训练:一种有效的方法是从一个稳定的、先前固定的检查点生成伪标签,而不是利用来自演进中的策略的标签,这样做可以稳定训练,同时达到与 SRT 相当的性能;
iii)结合课程学习的自我训练:研究团队假设,在更具挑战性的数据集上训练时,模型崩溃会发生得更快,这一推测与研究团队的经验性发现一致。其直觉是,在更具挑战性的数据集上,模型更容易放弃其预训练知识,转而优化自我一致性,而不是真正学习解决潜在的任务。研究团队利用这一假设,通过根据(a)通过率和(b)多数投票的频率来识别 DAPO 数据集中「最简单」的子集,从而实施一种课程学习策略(更多细节请参见论文);
论文《Learning to Reason via Mixture-of-Thought for Logical Reasoning》从投票机制提出了一个缓解方法,其它论文也提出了一些类似的方法,很少有明显效果提升的方法**:**
多模态:模型一次性学到自然语言(NL)、代码(Code)和真值表(Truth Table:系统性枚举所有逻辑可能)三种表达与推理方式;
自我进化式训练:将每次各自“专家”的推理结果和答案进行筛选,然后反馈给模型进行新的微调,模型逐轮改进;
投票或融合:统计三个答案中出现次数最多的那个,如果出现平票 (tie),论文中提及随机选择一个作为最终答案,这样往往比只依靠某一个专家的单一观点更稳健;
毛主席说实践才是硬道理,而实践既包括试验还包括现实世界的反馈,可SRT的投票机制并不是实事求是的反馈,方法有待改善,若是在 RL 训练过后的模型的基础上加入SRT继续训练可能效果比从零无监督地SRT训练一个模型更靠谱些,至少已经具备更正确的先验知识,有了更正确的知识体系再进行无监督训练产生离谱投票的几率更小。
总体来讲,RL和SRT对于解决数据困境都有作用,一个属于高效采样一个属于高效 投票 ,目前RL效果最好而SRT前景更大,将RL损失函数中的那些clip、KL散度等不合理的限制优化之后RL的效果可能会更好,但离理想的目标都很遥远,不可能一蹴而就,当前人类还需要很长的路才可能找到更好的算法方案逐渐实现,当然,也有一些其它方向提出来,比如刚开始发展的世界模型算法方向,然而,世界模型寄希望于模型像人类一样理解世界然后能预测后续发展,这种“理解”学习方向想象很完美,但与统计学为基础的算法方向偏离更远,目前的方法很可能有问题(仍在摸索初期),若不从纯算法的角度来看,还有一个被逼无奈的解决数据困境方式就是合成数据,也存在一定的缓解作用,但AI大模型过于依赖合成数据可能会直接“崩溃”,回到现实,回到初心,AI的下一场战争可能仍然是数据之战。
参考文献:
《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》
《ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models》
《Can Large Reasoning Models Self-Train?》
《Unsupervised Post-Training for Multi-Modal LLM Reasoning via GRPO》
《Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents》
https://mp.weixin.qq.com/s/rNpKwlCagtvjO81FprtRqQ
https://mp.weixin.qq.com/s/Tn47-D5Bhddg02nuqK8Tsw
 暂无数据
 暂无数据 暂无数据