什么是世界模型?“观察真实世界环境并基于当前知识预测未来可能发生的事情”的系统。如同大脑预测棒球飞行轨迹以提前挥棒击球一样,AI也能凭借世界模型进行前瞻性的反应,Meta及其首席AI科学家Yann LeCun认为,要在未来十年内实现“类人智能”,必须依赖能够进行推理和规划的世界模型,让LLM走出纯粹的文本“洞穴”,去拥抱一个由图像、声音和物理规律构成的、多姿多彩的真实世界。Meta、Google、NVIDIA等公司都已经在布局,尤其是NVIDIA进行了大量投入,富豪公司们特别渴望得到能够 理解****世界的机器 ,让机器能够记忆、拥有直觉和常识,像人一样推理和规划,每个超级资本家都在寻找世界模型,这就是他们的真实嘴脸吗?恐怕未来很遥远!AI 智能体的质量从根本上受限于它们能够模拟和探索的世界的保真度,但基于统计学的 大模型 存在根本缺陷--缺乏可靠性 ,而且,学习纷繁复杂现实世界系统的精确世界模型本身就特别困难 ,这也从根本上限制了智能体的通用能力,不过,这个领域也有可能能创造一些人类社会价值,不从资本家的角度去看问题还是有研究价值。
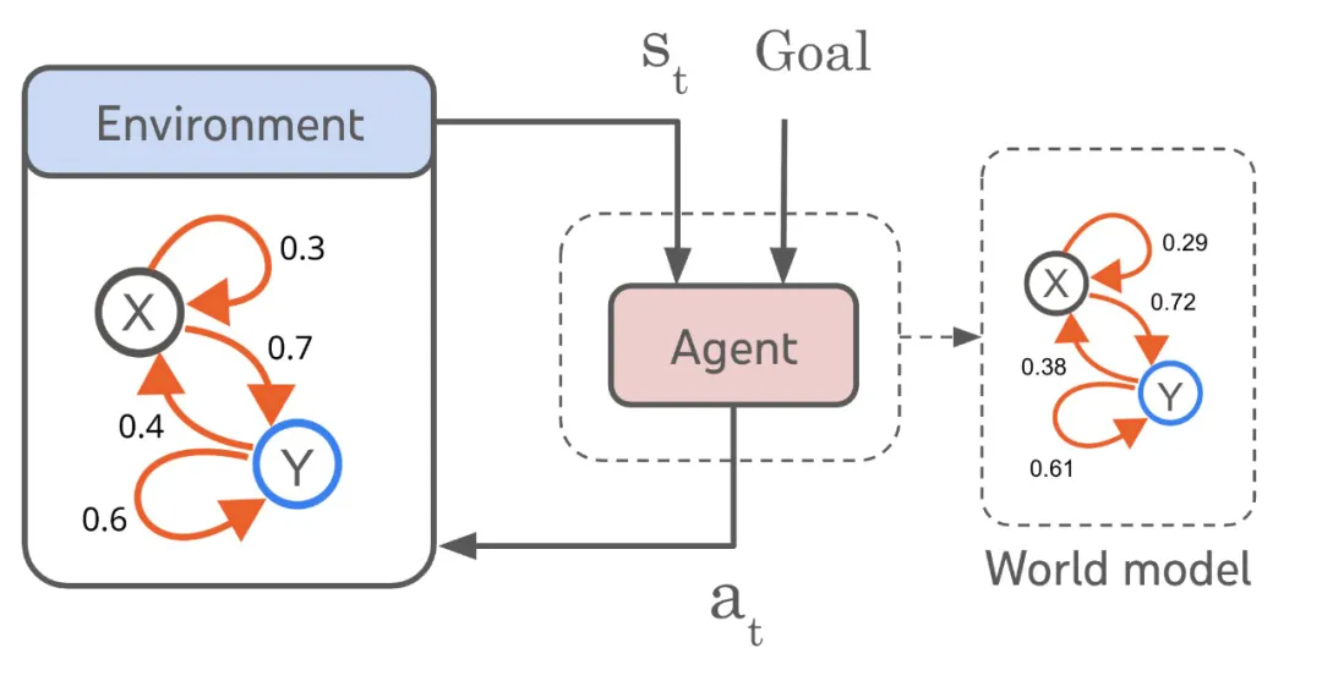
最近由于scalling law瓶颈,LLM的发展遇到严重困境,世界模型成了智能体的希望,同时,几乎所有科学家都在怀疑大模型的智能潜力,仅靠以统计学为基础的模式匹配能使大模型像人一样聪明?
电脑的记忆方式和人脑一样吗?显然不一样,但它可比人类更能记,那么,大模型不能像人类一样思考,它能打败人类吗?规模极大的统计学模型的力量可能超乎想象,不靠人类那种理解的方式记忆和思考也是一种方法 ,这个方向的潜力很大,往往解决事情的方法不只一种,就像动物捕食需要用爪子而人类不需要却顿顿有肉吃,大模型不能像人类一样的方式思考,但它靠模式匹配 解决问题的能力高度可能更可怕,我们可能优先应该考虑的不是大模型未来的能力高度,毕竟,即使短时间实现不好,人类未来无限长的日子里呢,咱们更应该考虑的是它的危险性。
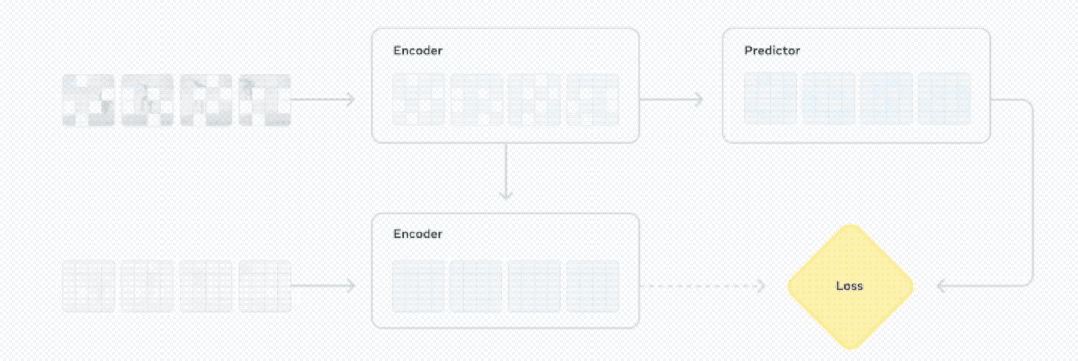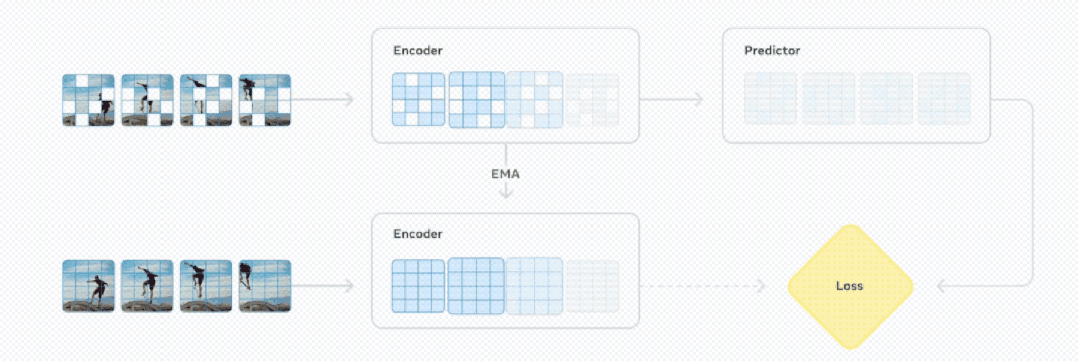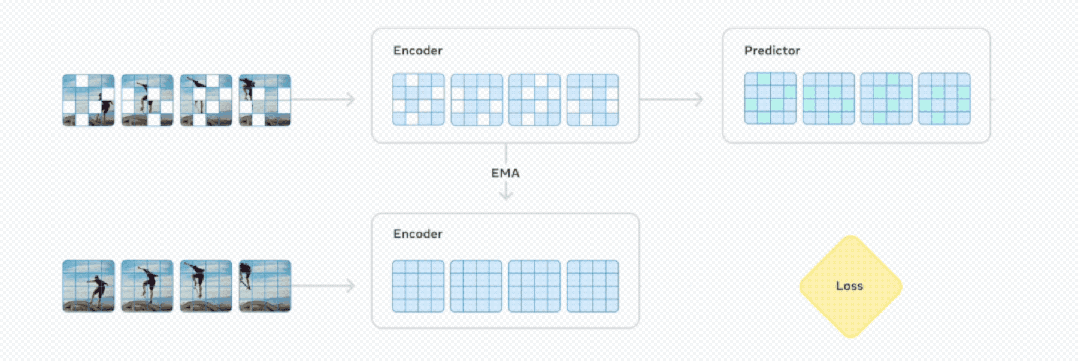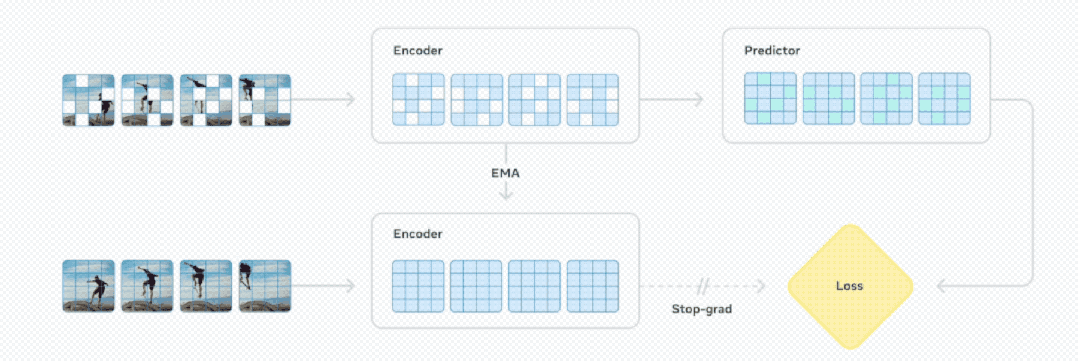
Meta开源的V-JEPA 2是个基于视频训练的世界模型,采用自监督学习框架,利用超过100万小时的互联网视频和图像数据进行预训练,不依赖语言监督,证明纯视觉自监督学习可以达到顶尖表现。图灵奖得主、Meta首席AI科学家Yann LeCun亲自出镜宣传,它提升了动作预测和物理世界建模能力,能够用于在新环境中进行零样本规划和机器人控制。作为世界模型它“应该”具备以下几种能力:
理解:世界模型应该能够理解世界的观察,包括识别视频中物体、动作和运动等事物;
预测:一个世界模型应该能够预测世界将如何演变,以及如果智能体采取行动,世界将如何变化;
规划:基于预测能力,世界模型应能用于规划实现给定目标的行动序列;
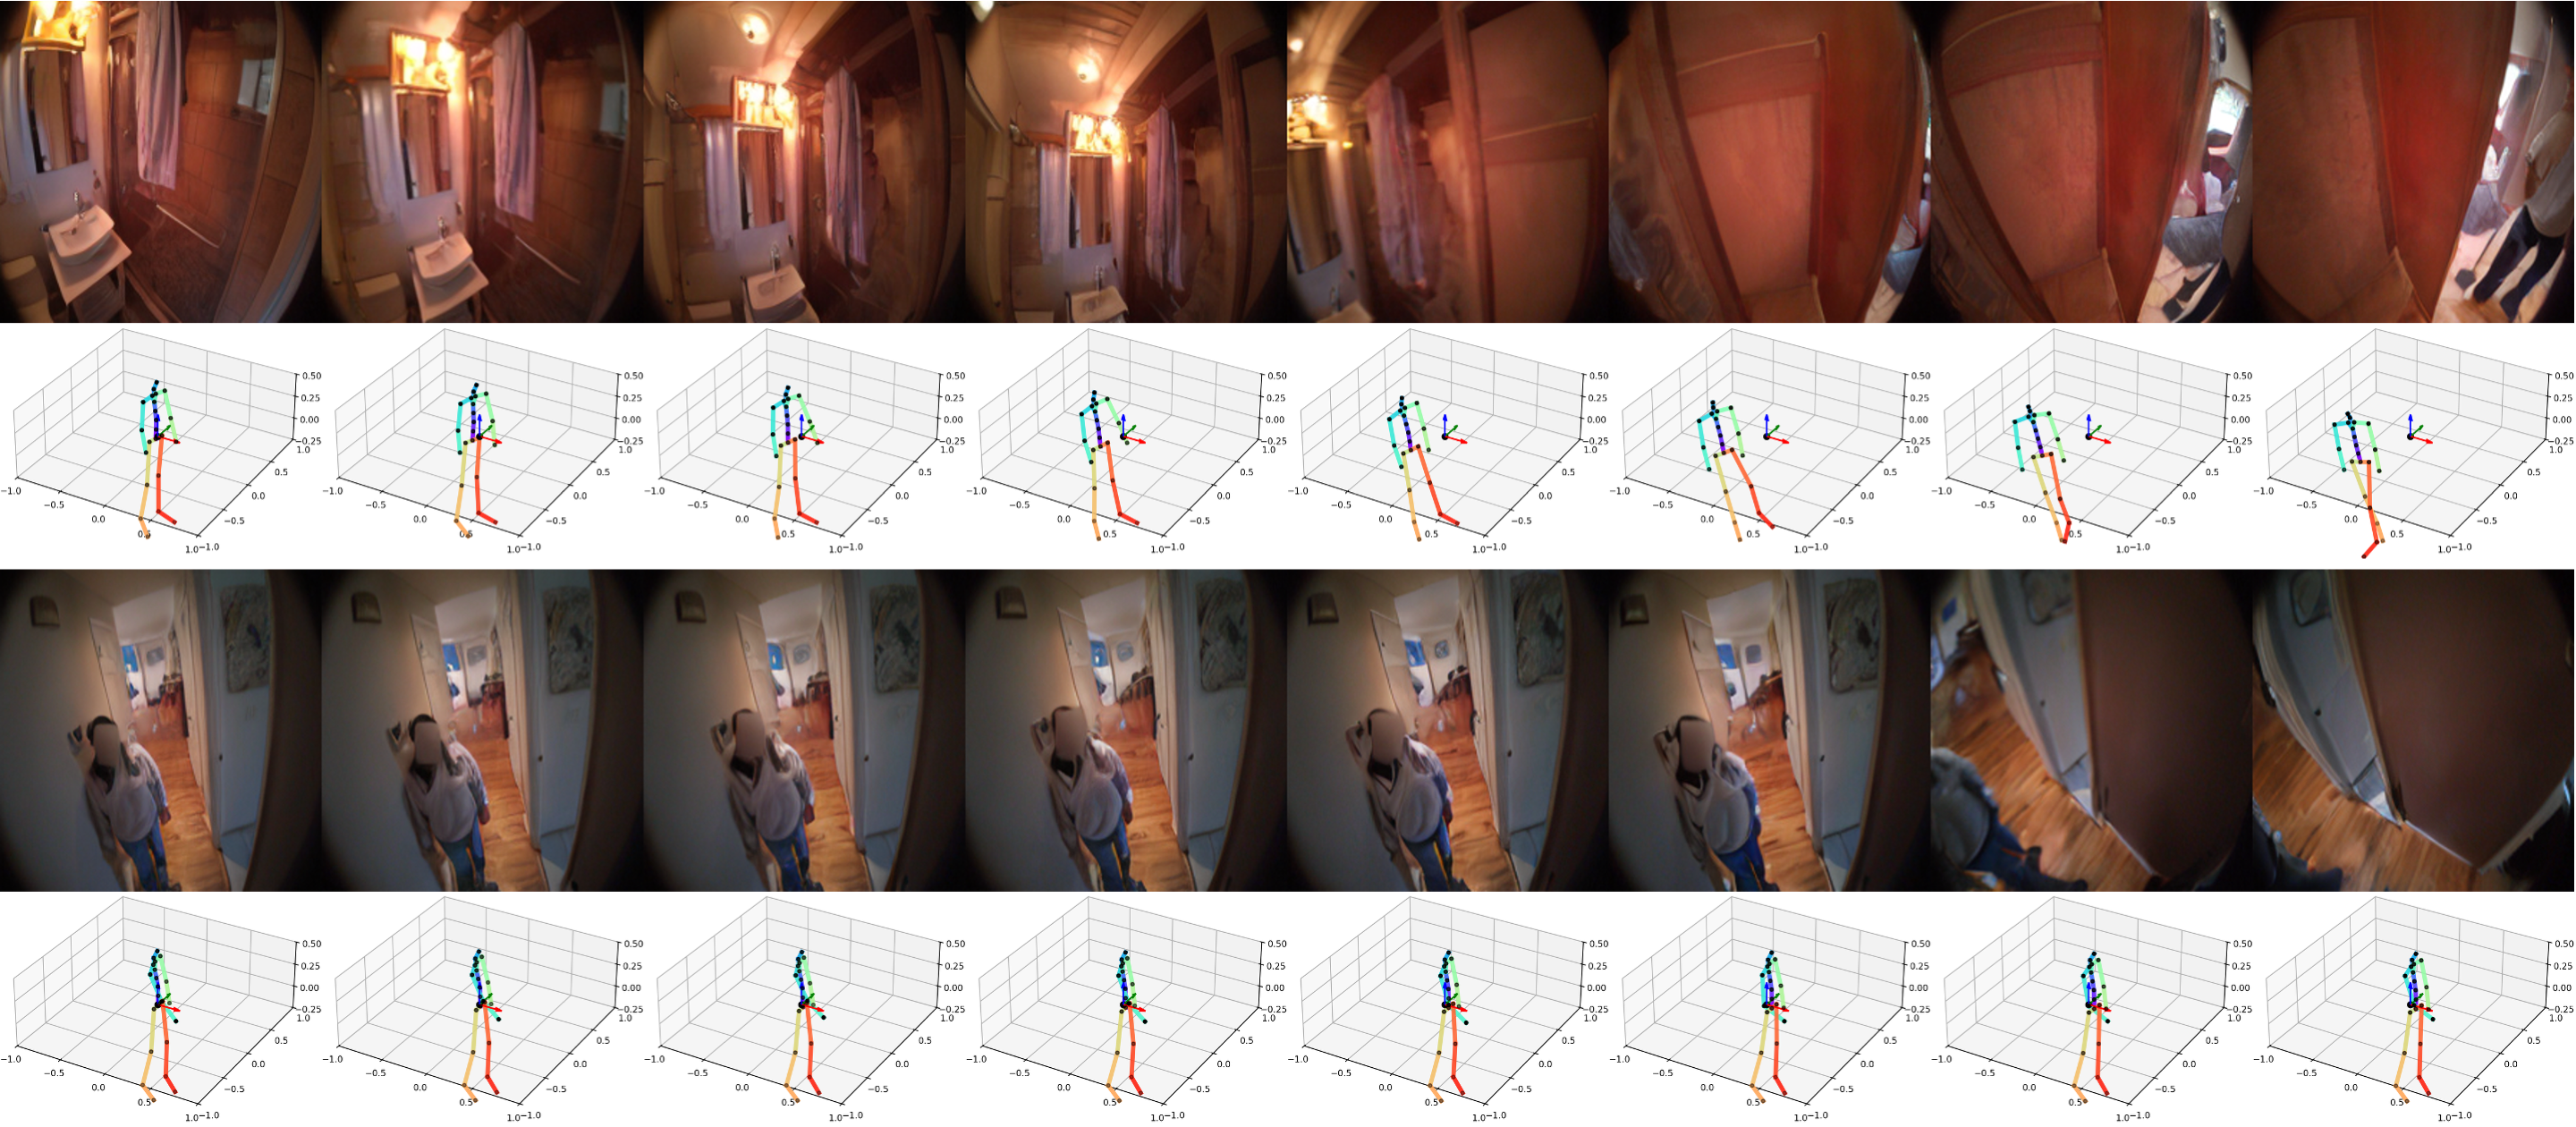
Yann LeCun团队还提出了一种名为PEVA(Predict Ego-centric Video from human Actions)的模型,该模型能够基于人体动作预测第一人称视角的未来视频,建模人体姿态与人体视角的关系 ,其核心原理是通过结构化的人体动作表示、条件扩散Transformer架构以及大规模数据集训练,从而实现对人体动作与视觉感知关系的建模。本方法按顺序生成下一状态,每次将生成的状态与新动作结合作为新上下文,最终通过VAE解码器还原为像素,加之采用了扩散算法,对大跳变场景效果应该不好,从演示效果来看,视角采样也不是人眼的真实超广角视场(人眼相当于135等效焦距的16mm超广角镜头,单眼可视角度相当于110°,双眼差不多180°,人眼还带背景虚化功能。),且不支持动态环境下的增量学习,场景适应能力差,故目前效果与真实的现实场景仍然差距较大。
Meta还透露了公司在通往高级机器智能之路上的下一步计划,V-JEPA 2 目前只能在单一时间尺度上学习和进行预测,但是,许多任务需要跨多个时间尺度的规划,所以一个重要的方向是发展专注于训练能够在多个时间和空间尺度上学习、推理和规划的分层次 JEPA模型,另一个重要的方向是多模态 JEPA模型,这些模型能够使用多种感官(包括视觉、音频和触觉)进行预测,不过,Meta对于当前是否能实现世界模型感觉比较渺茫,所以研究重心还是寄希望于数据短缺问题的解决以及RL算法的继续优化。
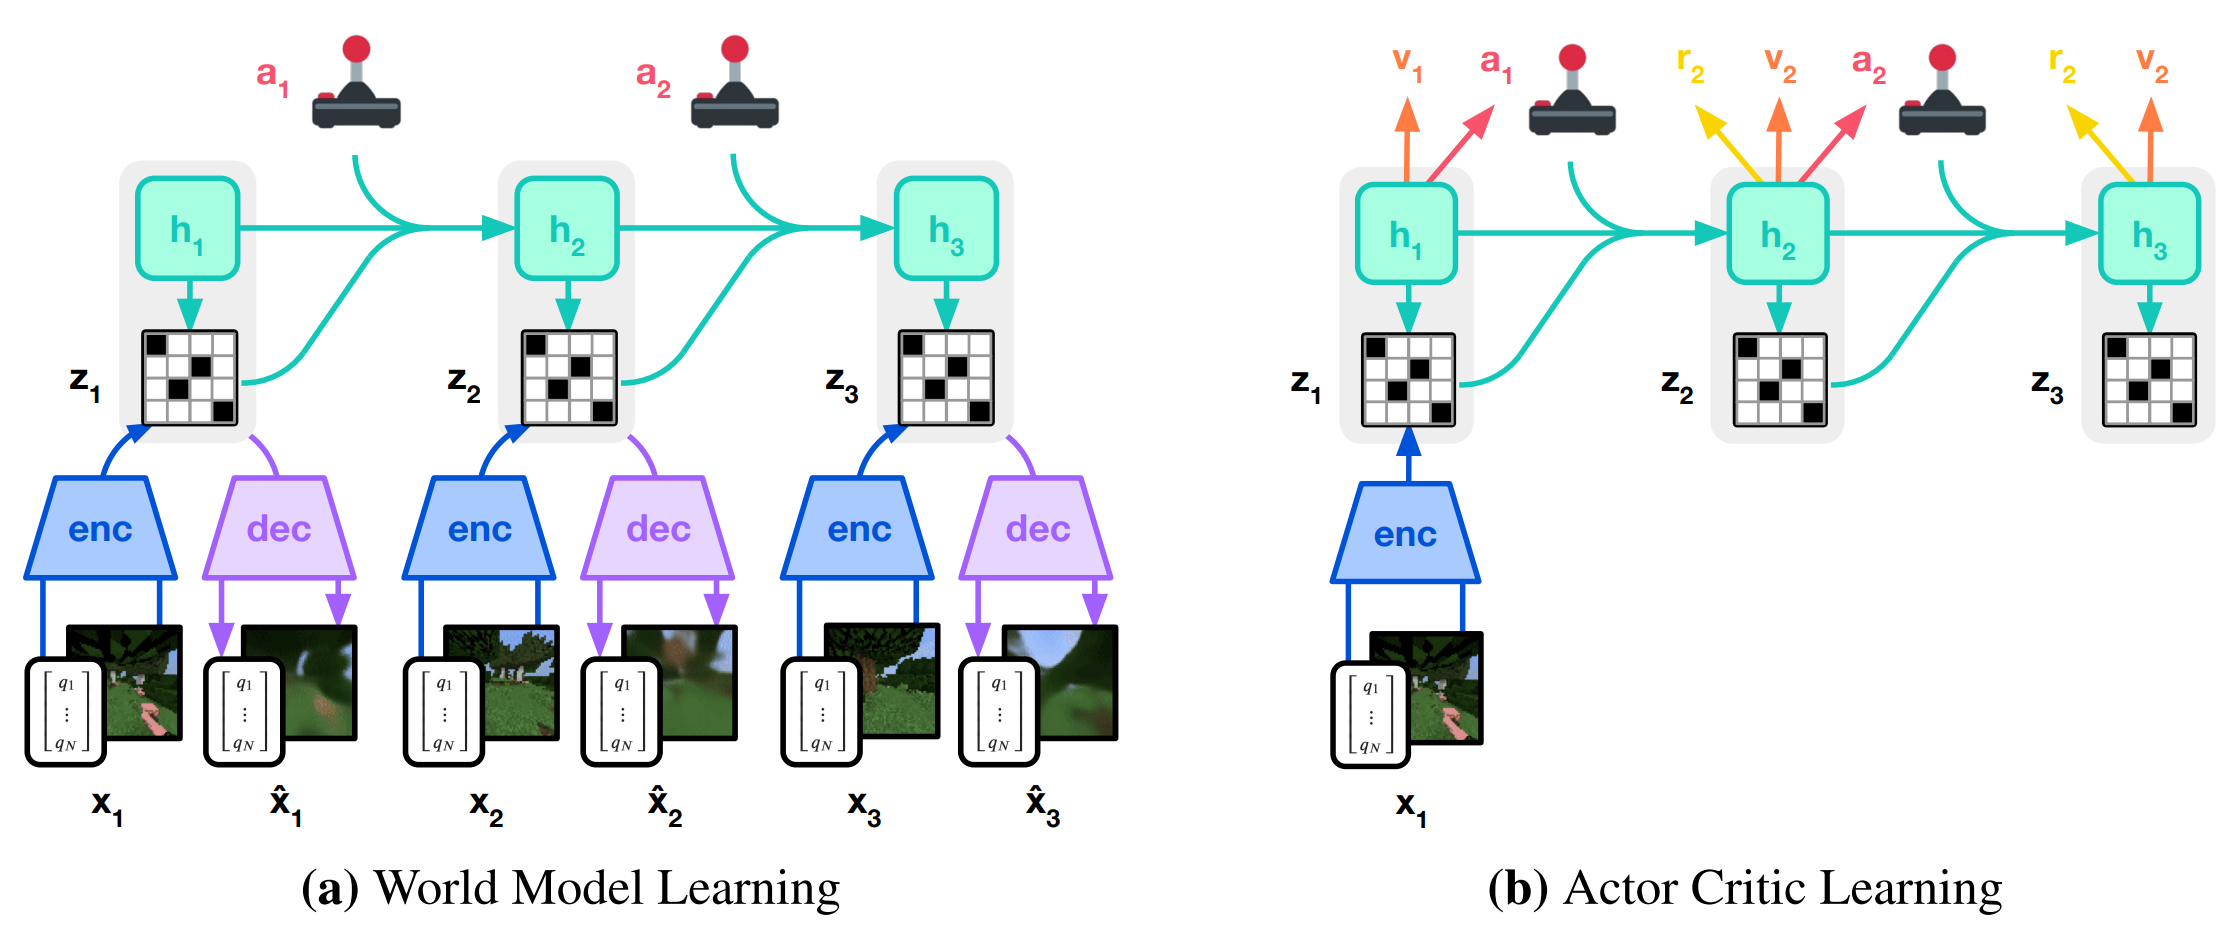
Google最新版通用强化学习算法 Dreamer V3,能够在无需更改超参数的情况下,处理超过150种不同任务。最大的突破在于,这是首个能够在 Minecraft 游戏中“从零开始”挖掘钻石的算法——完全没有借助任何人类示例,仅靠自身“想象力”和默认设置实现,不仅是强化学习的成就,也是世界模型的里程碑。Dreamer V3 由三大部分组成:World Model (在给定一个动作的情况下,模型能够预测下一个状态、预期奖励以及该回合是否继续。)、Critic(负责评判世界模型“想象”出的结果有多好或多坏。)、Actor(根据 World Model 和 Critic 提供的见解,决定采取何种最佳动作。)。
NVIDIA 对物理AI(Physical AI)的专注推动了名为Cosmos 的模块化“世界基础模型平台”的开发,Cosmos 平台包括三大主力模型系列:Predict1 用于模拟真实世界的动态、Transfer1 实现了跨模态的细粒度可控视频生成、Reason1 则负责对物理世界进行理解和推理从而做出具身决策。
Cosmos-Predict1:用于模拟视觉世界随时间的变化,通过超过一亿段视频学习通用的物理世界动态,并可在较小任务数据集上针对特定目标进行微调,实现通过文本、动作或相机输入等方式进行可控生成;
Cosmos-Transfer1:构建于 Cosmos-Predict1 之上,并为其赋予强大的自适应多模态控制能力,让用户可以利用多种空间控制信号(如分割图、深度图、边缘图、模糊的视觉输入、高清地图和 LiDAR 数据等)来引导世界生成过程;
Cosmos-Reason1:通过利用 Predict1 的模拟世界和 Transfer1 的精炼视觉来做出明智决策,实现物理 AI 系统的闭环。该模型(提供8B和56B参数规模)能够推理发生了什么、接下来会发生什么,以及在真实物理和环境动态下可行的动作;
优秀的世界模型能捕捉环境的普遍特性和底层动态,让智能体能够推理并应对训练时未遇到的新情况,让智能体可以“想象”不同动作策略下未来状态的序列,从而制定最佳方案。但想象很完美现实很骨感,从以上Meta、Google、NVIDIA等公司的实例可以看出,他们所实现的功能都是片面的,即便后续加入多模态以及更复杂一点的场景,谈不上“世界”这么大的维度,更不用说模型真正理解世界了,而且当前 大模型 基于统计学,它的内部知识库是分布,而不是类似人脑的逻辑知识体系,所以COT、 RL 之类的方法要么用外力协助模型一步一步生成要么按照人类兴趣进行生成才出现明显的效果提升,本质上还都是 帮助大模型增强其知识从概率分布到强逻辑体系的转换效率 , 类似于梳理知识体系,这是一种近似模拟,模型自身并不懂所谓的推理思考,根本谈不上真正的理解,不过这一点倒是还有较大提升空间,科研人员可以加强研究**。世界模型是智能体的新起点,** 但是太难太远,大家现在纷纷在对世界模型的难度降级,比如,OpenAI 联合创始人 Ilya Sutskever以前说当前的大型神经网络就是世界模型现在引起了巨大的反思,谷歌论文《General agents need world models》还对其进行了证明,甚至还有学者说基于transformers的纯LLM泛化性能不够撑不起世界模型等等,如果Ilya的说法是事实,那么,后续相当长一段时间内的世界模型研究之路将又被数据困难拉回现实,不过,当前所谓的缺,缺的是可开放的高质量文本数据,实际上人类生活在现实的3维、5感空间,空间数据的“金矿”还处在挖掘的起始阶段,这方面算法的研发也还处在起始阶段,因此,智能体的未来才刚刚步入新的起点。
参考文献:
《Potemkin Understanding in Large Language Models 》
《Whole-Body Conditioned Egocentric Video Prediction》
《V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning》
《Critiques of World Models》
https://baijiahao.baidu.com/s?id=1625992638834190598&wfr=spider&for=pc
 暂无数据
 暂无数据 暂无数据