0
0
0
0
vllm双节点部署Qwen3-32B失败
2025-07-10 09:52:04
254
使用vllm 0.8.5-ubuntu22.04-dtk25.04.1-rc5-das1.6-py3.10-20250705镜像,双节点运行,每个节点4张DCU卡,显存为16G。首先构建Ray集群,节点1和节点2分别执行Ray init命令,结果如下:
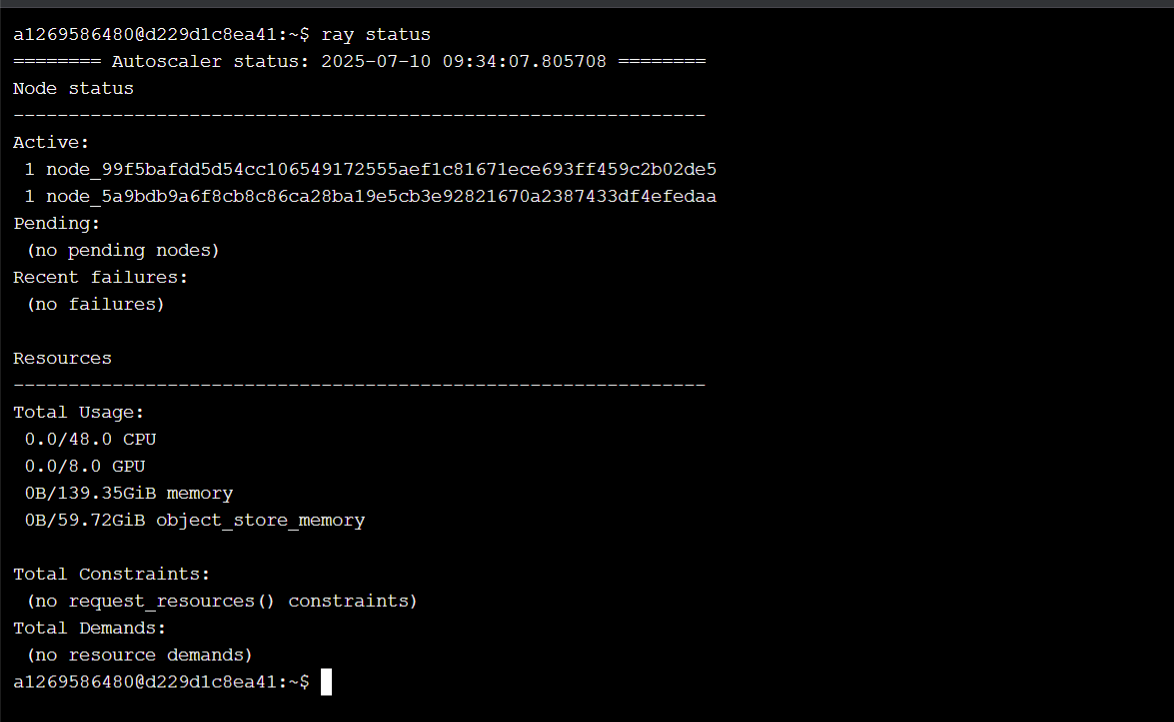
然后在头节点执行部署命令:
python3 -m vllm.entrypoints.openai.api_server --model ./model --served-model-name Qwen3-32B --host 0.0.0.0 --port 8000 --distributed-executor-backend ray --pipeline-parallel-size 2 --tensor-parallel-size 4
按照vllm官方多节点推荐设置pp为2,tp为4,然后运行报错如下:
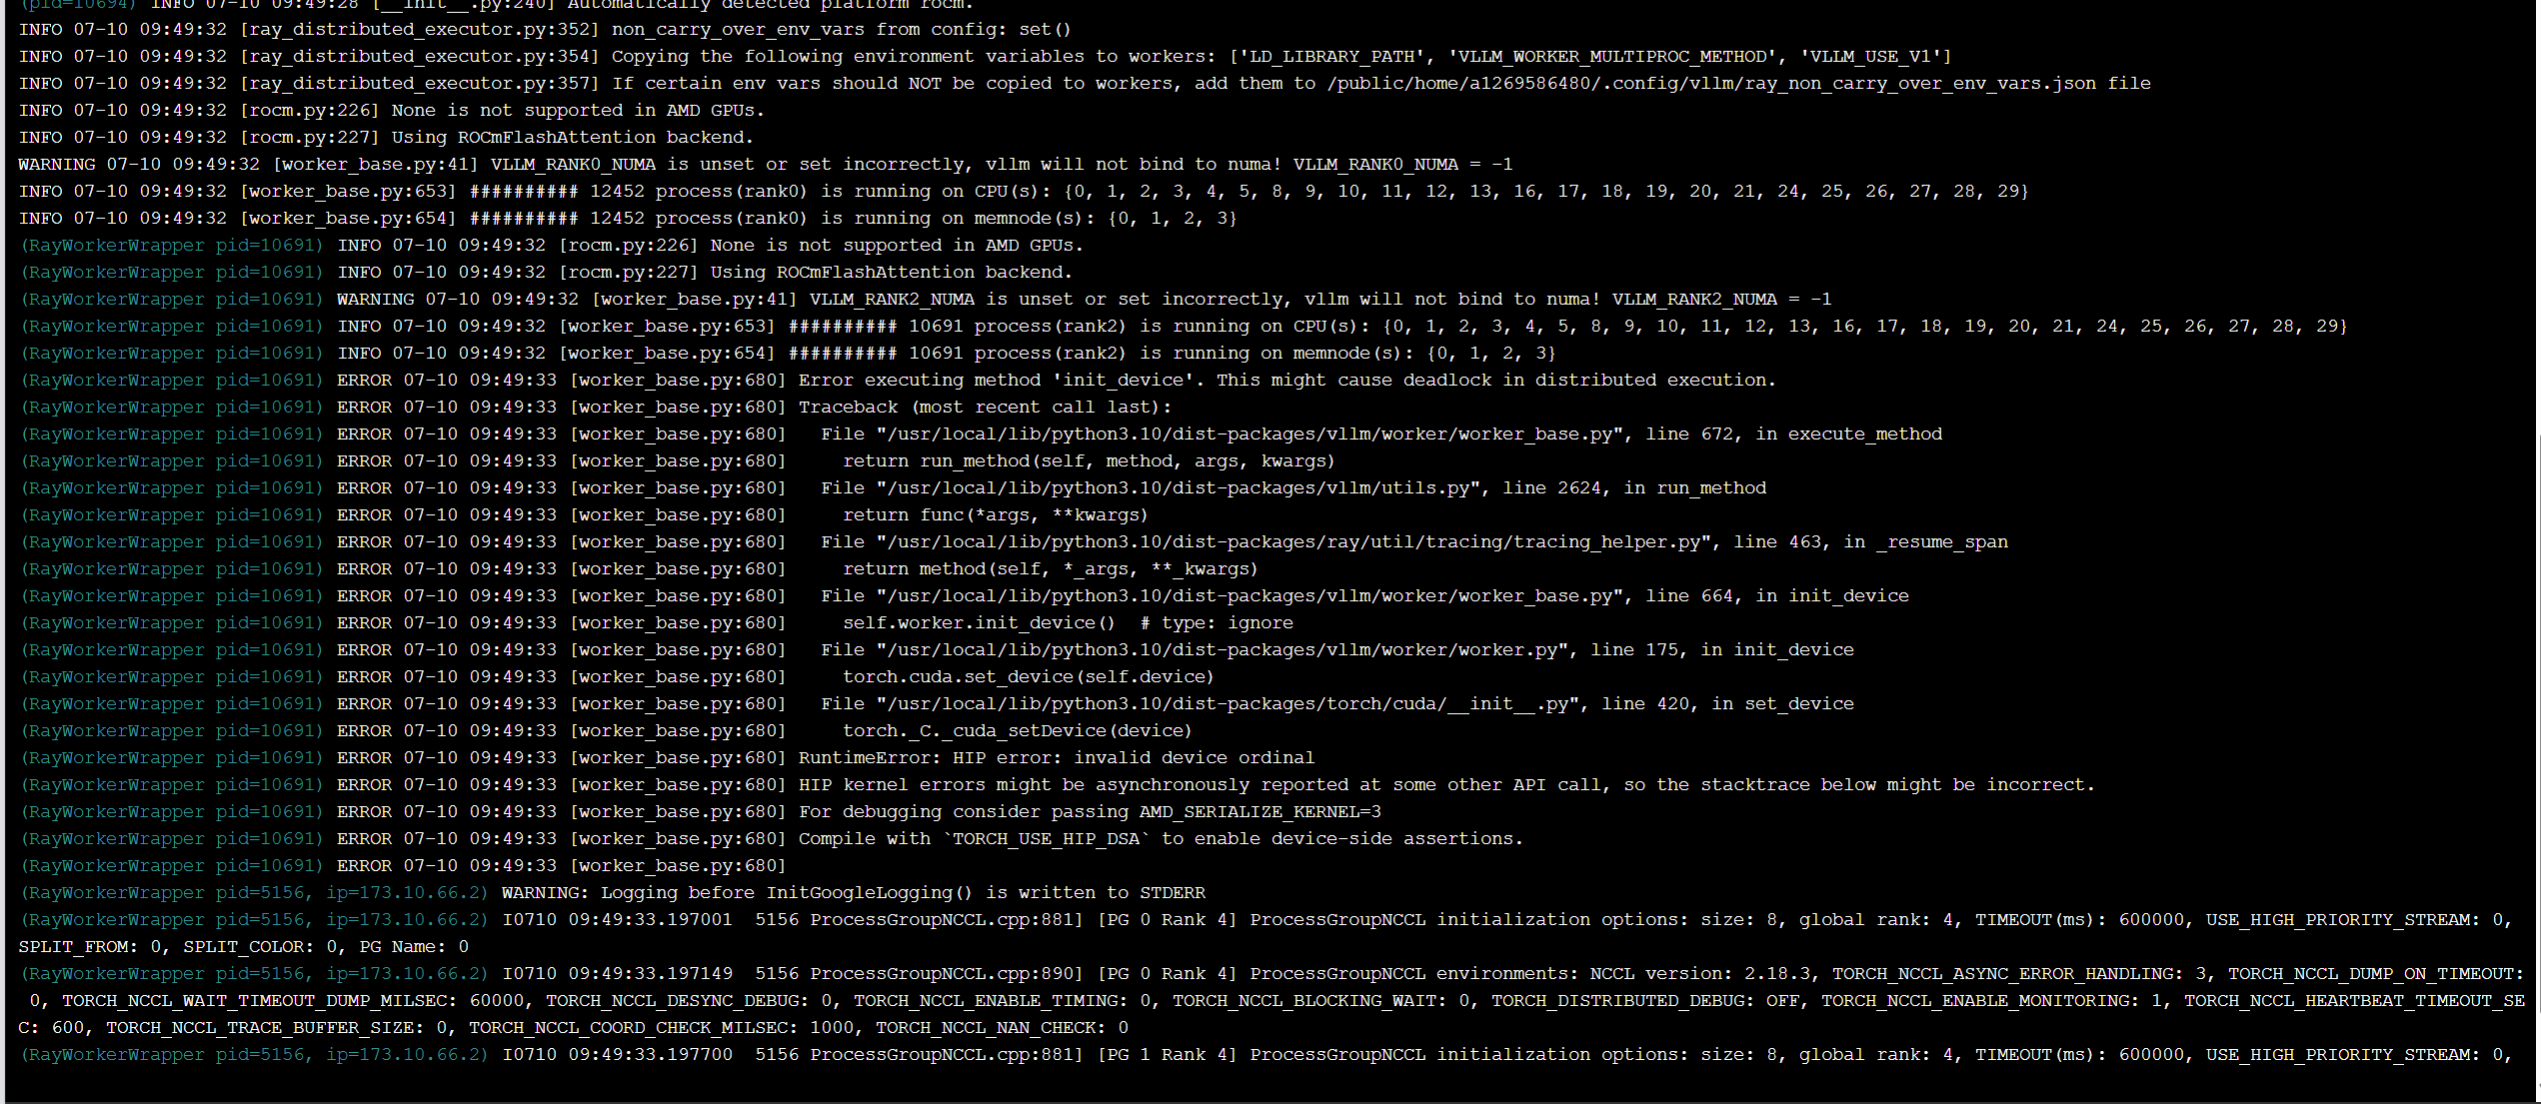
随后程序卡住再也不动
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据
两个节点加上如下变量到 ~/.bashrc中:
export ALLREDUCE_STREAM_WITH_COMPUTE=1
export VLLM_HOST_IP=当前IP地址
export NCCL_SOCKET_IFNAME=上面IP地址对应的网口名
export GLOO_SOCKET_IFNAME=上面IP地址对应的网口名
export NCCL_MIN_NCHANNELS=16
export NCCL_MAX_NCHANNELS=16
export NCCL_NET_GDR_READ=1
export HIP_VISIBLE_DEVICES=0,1,2,3
加完以后重启容器或者 source ~/.bashrc
主节点ray 启动命令:
ray start --head --node-ip-address=(头节点的VLLM_HOST_IP) --port=6379 --num-gpus=4 --num-cpus=32
工作节点ray启动命令:
ray start --address='头节点的VLLM_HOST_IP:6379' --num-gpus=8 --num-cpus=32
启动服务命令:
vllm serve ./model --served-model-name Qwen3-32B --host 0.0.0.0 --port 8000 --distributed-executor-backend ray -tp 8