0
5
0
0
k100_ai显存部署模型后,显存增长
2025-08-01 11:34:17
188
使用镜像:
image.sourcefind.cn:5000/dcu/admin/base/vllm:0.8.5-ubuntu22.04-dtk25.04.1-rc5-das1.6-py3.10-20250724,
执行脚本为:
vllm serve /data/qwen3-235b-a22b/ --served-model-name qwen3-235b-a22b --max-model-len 15000 -tp 8 --gpu-memory-utilization 0.95 --dtype float32
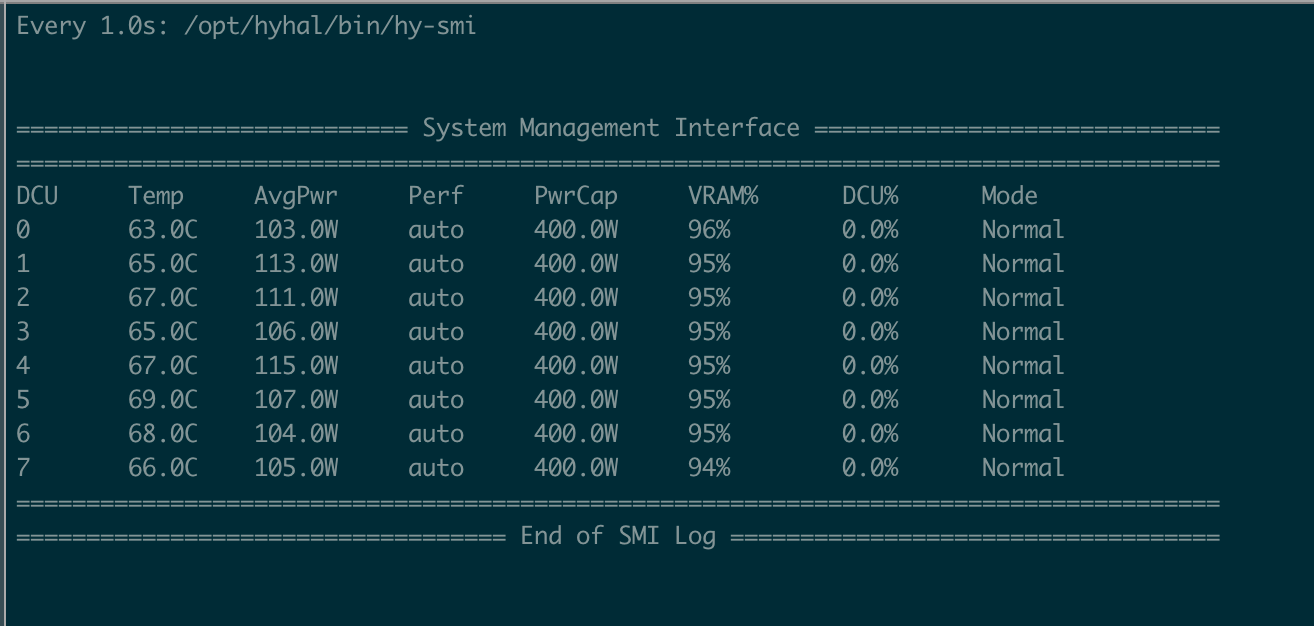
初始显存为:
请求多了之后,显存慢慢涨了,看着也没释放:
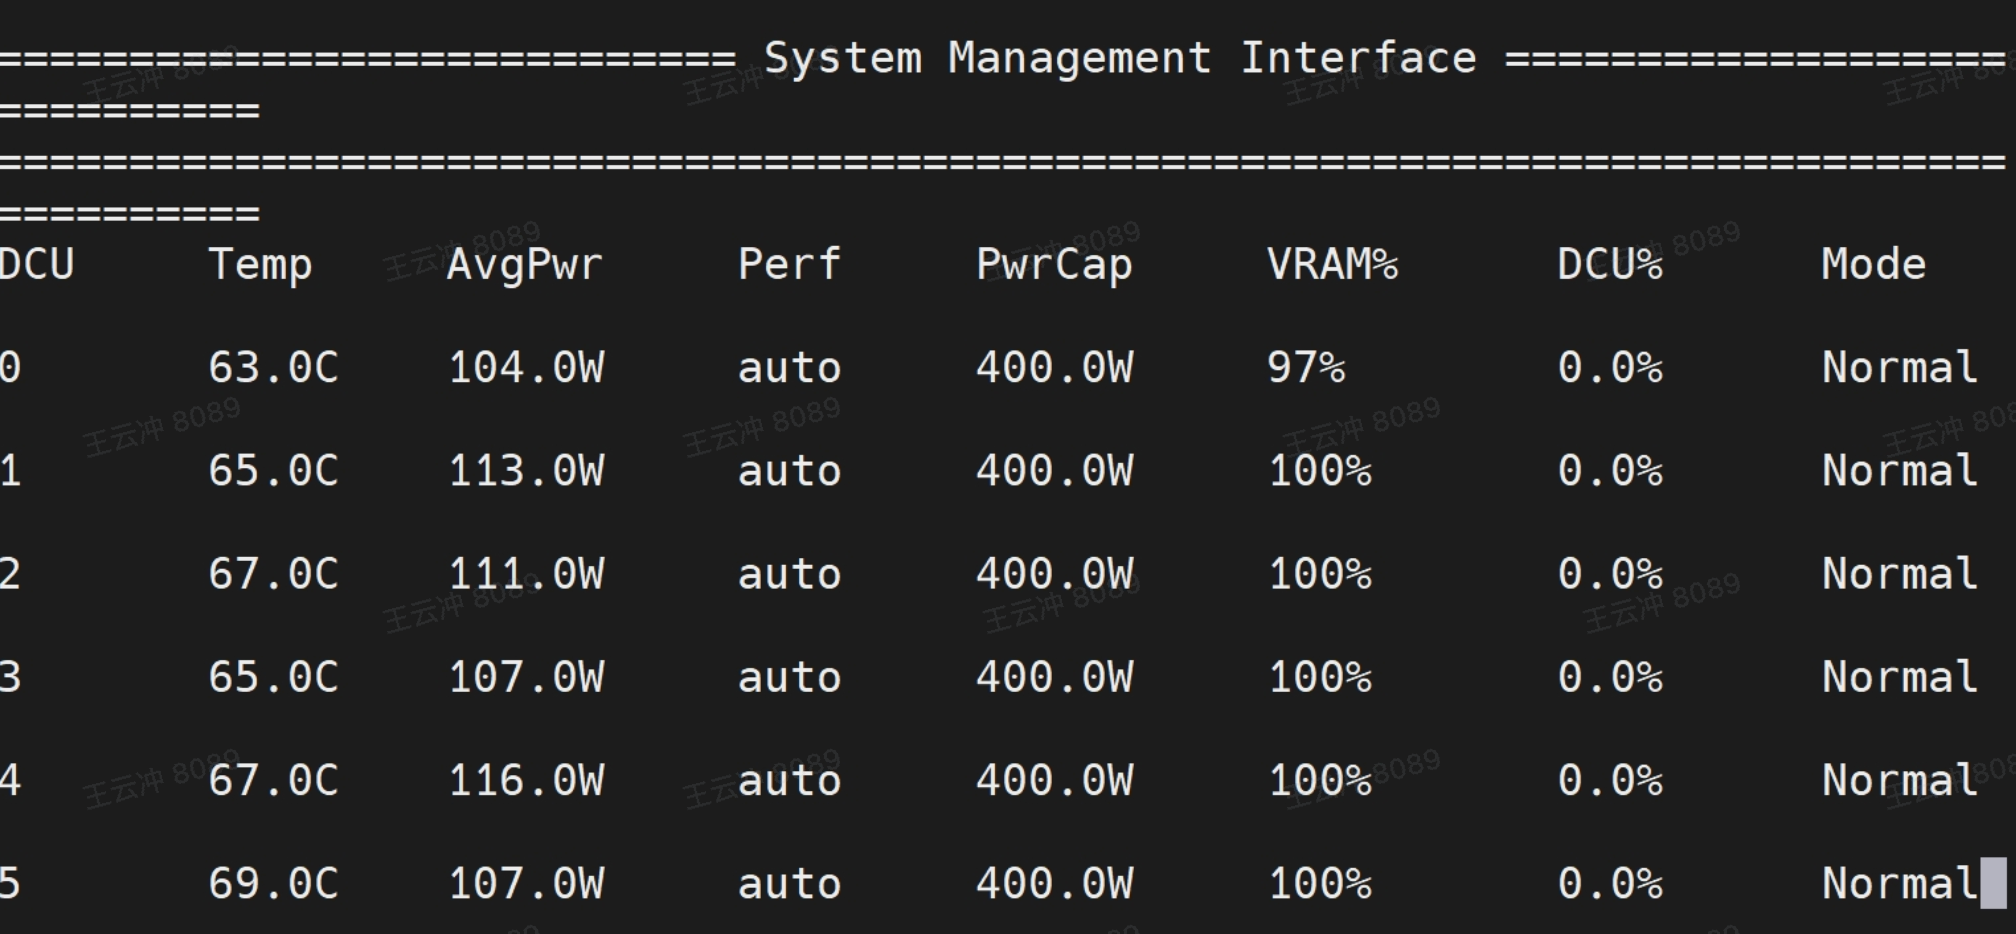
这是什么原因呢,是不是少配置什么参数了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据
原因是:
1、KV 缓存动态增长
初始加载模型时,仅占用模型权重本身的显存(95%),未包含 KV 缓存。
随着请求增多,尤其是长序列请求(你的--max-model-len 15000设置允许极长序列),KV 缓存会持续占用更多显存,直至占满剩余 5% 空间。
若请求序列长度接近max-model-len(15000),单条请求的 KV 缓存会占用大量显存,多并发下极易触发显存耗尽。
2、未启用 KV 缓存量化
你使用了--dtype float32(全精度),而未对 KV 缓存进行量化,导致 KV 缓存占用显存过大:
全精度(FP32)的 KV 缓存每 token 每头占用 2 * 32bit = 8B 显存,15000token 的单条请求在多注意力头下会占用数十 MB 显存。
8 张卡张量并行(-tp 8)时,单卡仍需承担部分 KV 缓存,多并发叠加后显存快速耗尽。
解决办法:
1、启用 KV 缓存量化(核心优化)
加参数--kv-cache-dtype bf16
2、限制单卡最大并发序列数
通过--max-num-seqs限制单卡同时处理的请求数,避免并发过高导致 KV 缓存爆显存:
--max-num-seqs 32 # 单卡最大并发序列数,总并发=32*8=256
3、降低gpu-memory-utilization预留缓冲
--gpu-memory-utilization 0.9 # 预留10%显存作为缓冲
4、优化请求序列长度
若业务允许,降低--max-model-len(如从 15000 降至 8000),减少单条请求的 KV 缓存占用。