您好,请问您用的是哪个版本的镜像呢?
0
3
0
0
VLLM多卡多机部署推理速度慢
2025-08-20 11:54:28
391
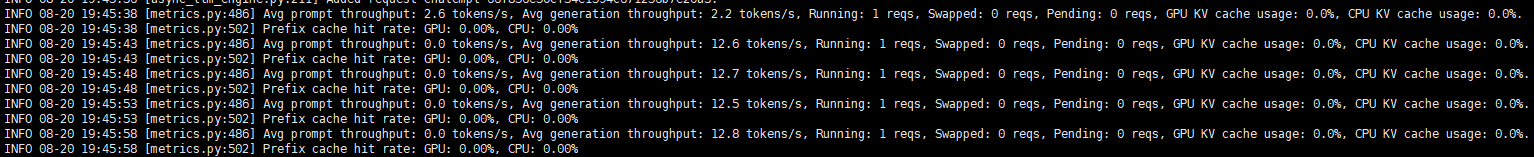
在两台(每台有8张K100)采用25G网卡直连的机器上部署Qwen3-235B模型,测试推理速度较慢,维持在13tokens/s左右。想问一下有方法提升推理速度吗?
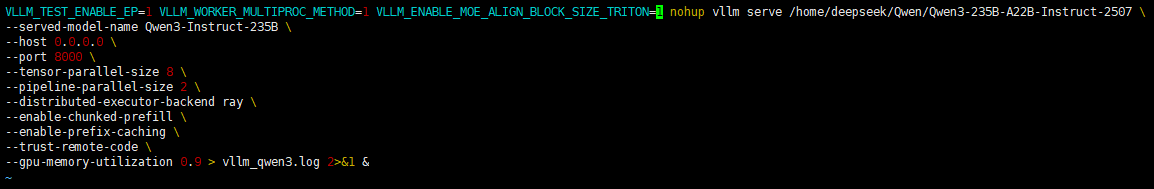
部署方式:
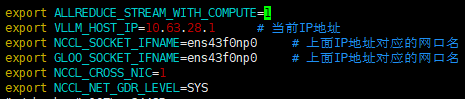
环境变量设置:
全部评论(5)
只看楼主
网
2025/8/22
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据在两台(每台有8张K100)采用25G网卡直连的机器上部署Qwen3-235B模型,测试推理速度较慢,维持在13tokens/s左右。想问一下有方法提升推理速度吗?
部署方式:
环境变量设置:
暂无数据 暂无数据