**反馈**
**一、环境信息**
* **显卡型号:K100-AI(64G)**
* **服务器数量:2 台**
* **每台 GPU 数量:8 张**
* **网络环境:千兆 / 万兆(均测试)**
* **镜像:**[harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.11.0-ubuntu22.04-dtk25.04.2-1226-das1.7-py3.10-20251226](http://harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.11.0-ubuntu22.04-dtk25.04.2-1226-das1.7-py3.10-20251226)
**二、问题概述**
在使用最新的 **MiniMax-M2.1 K100-AI 适配镜像** 部署完成后,推理性能异常偏低。
注:m2、m2.1、m2.5三个模型都试过了,使用的都是这个镜像,结果是一样的。m2.5有个BW1000的镜像,在K100AI上使用时,vllm启动会报错
**具体表现:**
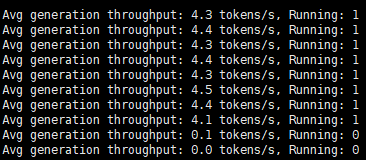
* 单并发情况下:
* 输出速度仅 **4\~5 tokens/s**
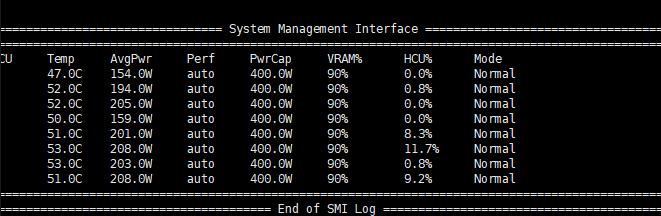
* HCU 利用率极低
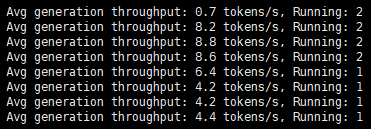
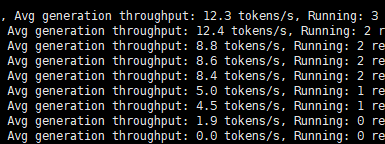
* 提高并发数后:
* 总 tokens/s 线性增长
* 但 **单请求平均 tokens/s 仍维持在 4\~5**
说明:
当前问题表现为“吞吐可叠加,但单流速度严重受限”。
**三、对照测试结果**
为排查问题,进行了以下测试:
**1️****⃣****网络测试**
| **测试场景** | **结果** |
| ------------------ | -------------- |
| 两台服务器(千兆) | 无改善 |
| 两台服务器(万兆) | 无改善 |
→ 网络带宽不是瓶颈。
---
**2️****⃣****参数调优测试**
测试修改参数:
* dtype
* max-model-len
* max-num-batched-tokens
* max-num-seqs
结果:
所有参数调整均未对单并发 tokens/s 产生影响。
---
**3️****⃣****模型对比测试**
| **模型** | **单并发tokens/s** |
| -------------- | ------------------------ |
| MiniMax-M2.1 | 4\~5 |
| Qwen系列 | 20\~30 |
说明:
同硬件环境下,其他模型性能正常,问题可能与 MiniMax 适配实现相关。
**四、问题特征总结**
* 单流速度受限
* 并发增加仅提高总吞吐
* HCU 利用率低
* 网络无影响
* 参数调优无影响
* 其他模型性能正常

 暂无数据