有没有代码,我也想测试一下
0
2
0
0
海光K100-AI并行训练死机重启
2026-03-13 17:07:55
307
问题描述:
8卡海光K100-AI服务器,pytorch ddp模式多卡并行训练hrnet图像分割,4卡并行没问题,8卡并行跑几个轮次就会重启。
硬件信息
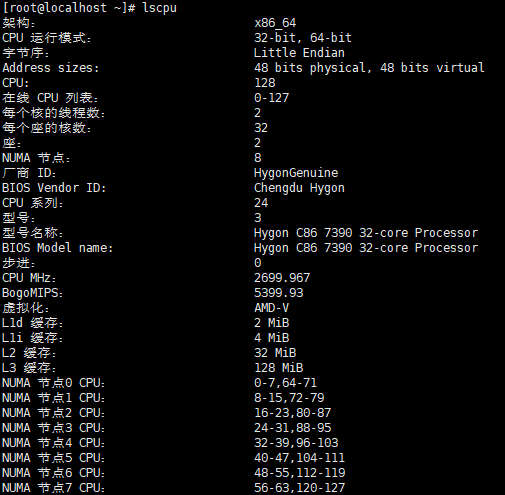
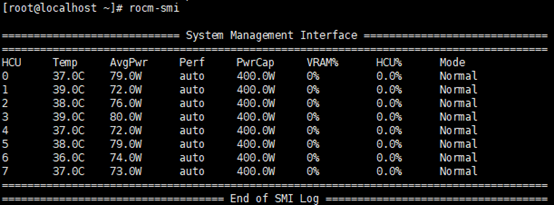
驱动和软件信息
驱动版本: rock-6.3.3-V1.8.0.run
DTK版本:DTK-25.04-Kylinv10SP3-x86_64.tar.gz
pytorch:torch-2.4.1+das.opt2.dtk2504-cp310-cp310-manylinux_2_28_x86_64
训练命令: python -m torch.distributed.launch --nproc_per_node=8 train.py
问题过程:
8卡启动训练后,模型执行几个轮次服务器直接死机重启,两卡或四卡无问题。
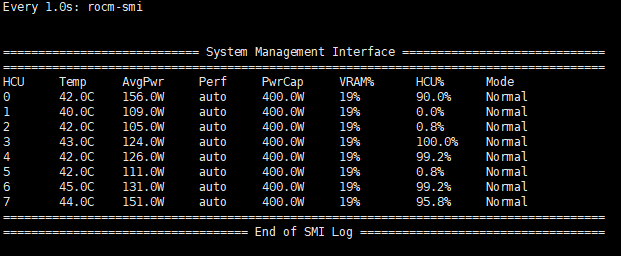
重启前监控温度功耗显存占用都在正常范围
全部评论(18)
只看楼主
李
6/1
L
建议先升级下驱动和dtk,你这个版本看着有点低
3/16
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据