2
4
0
0
快速上手国产计算卡海光DCU
2026-07-06 10:26:43
62
# 国产计算卡海光DCU保姆级教程
> 本博客基于曙光智算的超算互联网平台 https://www.scnet.cn/ 进行的实践与教学,其平台界面相较于北京超算云等平台更加现代,操作十分方便,几乎不需要使用vscode等ssh工具就可以获得相当便捷的运行环境。如果想要进行本地开发,也有一定的参考价值。目前我自己也在这一平台进行海洋相关科学计算和vllm推理加速的任务。
## 一、DCU简介
### 1.1 基本定义
DCU 全称**Deep Computing Unit(深度计算单元)**,是海光信息自研的**国产通用 GPGPU 并行加速芯片**,对标英伟达 A/H 系列 GPU,主打 AI 大模型训练、推理、高性能科学计算,是国内成熟商用通用算力卡之一。
### 1.2 产品线迭代
1. **深算一号(DCU 8000/Z100)**
7nm 工艺,32/64GB HBM2 显存,支持 FP64 双精度,2021 年量产;兼顾超算仿真与中小模型训练,国产化算力起步主力。
2. **深算二号(DCU 8200/K100)**
迭代升级,96GB HBM3,FP32 峰值 256TFLOPS,大模型训练性能大幅提升,2025 年规模商用,适配千亿参数大模型训推一体。
3. **深算三号(8300)**
5nm 工艺,128GB 超大 HBM3E 显存,算力翻倍,对标 H100,研发推进中。
### 1.3 硬件核心特性
- 全精度算力:FP64/FP32/FP16/INT8/FP8 全覆盖,兼顾科学计算与 AI 混合精度训练;
- HBM 高带宽显存,单卡 TB/s 级带宽,适配大模型海量参数;
- PCIe4.0 + xGMI 多卡高速互联,支持单机多卡、分布式算力集群扩展;
- 服务器标准加速卡形态,风冷 / 液冷可选,适配国产 x86 服务器(海光 CPU 配套最优)。
### 1.4 软件生态 DTK(核心优势)
自研**DTK 开发工具栈**,兼容 ROCm 生态,提供类 CUDA 迁移接口:
1. 少量修改即可迁移原有 CUDA 代码,迁移成本低;
2. 原生适配 PyTorch、TensorFlow、飞桨等全部主流深度学习框架;
3. 完整编译器、算子库、调试 / 性能分析工具;
4. 全面适配 ChatGLM、Qwen、Llama、文心等国产 / 开源大模型。
### 1.5 应用场景
1. AI 领域:大语言模型训练微调、AIGC、计算机视觉、语音识别;
2. HPC 超算:气象、流体仿真、能源勘探、生物医药分子计算;
3. 行业信创:金融、政务、运营商国产化智算中心算力底座。
## 二、基础入门:从0构建第一个DCU程序
> 本节在曙光超算互联网的 **DCU 队列** 下完成,所有命令均可在交互式 `srun` 或 `sbatch` 提交方式下使用。如果你用的是别的平台(如北京超算云、阿里云弹性加速实例),逻辑一致,只是 DTK 路径和 SLURM 队列名不同。
### 2.1 第一步:写一个 SLURM 任务提交脚本
在超算上跑 DCU 程序,**第一步永远不是写代码,而是先把资源申请好**。海光集群几乎都使用 SLURM 作为调度器,我们用 `sbatch` 把任务扔到队列里执行。
**最小可用模板** `hello_dcu.sh`
```bash
#!/bin/bash
#SBATCH -p dcu # 提交到 DCU 队列(不同集群名字可能不同:kshdmcc202x、dcuh100 等)
#SBATCH -N 1 # 申请 1 个计算节点
#SBATCH -n 8 # 8 个 CPU 核心(DCU 程序通常需要 CPU 线程做 I/O 与任务调度)
#SBATCH --gres=dcu:1 # 关键:每节点申请 1 张 DCU
#SBATCH -J hello_dcu # 作业名,方便 squeue 查询
#SBATCH --exclusive # 独占节点(避免别人和你抢 DCU 显存/带宽)
# 在这里放你的 DCU 程序
./hello_dcu
```
**常用参数速查**
| 参数 | 含义 | 备注 |
|---|---|---|
| `-p 队列名` | 提交到哪个分区 | DCU 队列一般叫 `dcu` / `dcuh100` / `kshdmcc2026` |
| `-N` | 节点数 | 多机分布式才用 `>1` |
| `-n` | CPU 任务总数 | 不等于核数,是 SLURM 任务槽数 |
| `--gres=dcu:N` | **每节点 DCU 数量** | 整机申请要写成 `--gres=dcu:4` |
| `--cpus-per-task` | 每个任务占几个 CPU 核 | 配合 `-n` 一起算总核数 |
| `--mem=0` | 申请节点全部内存 | 大数据预加载时建议加上 |
**提交与查看**
```bash
# 提交
sbatch hello_dcu.sh
# 查看自己的作业
squeue -u $USER
# 取消(作业 ID 从 squeue 输出第一列获取)
scancel <作业ID>
```
提交后用 `squeue` 能看到状态是 `PD`(排队)或 `R`(运行)。等状态变成 `R` 后,程序就会在分配到的节点上开始执行,结果写入 `hello_dcu.log`。
---
### 2.2 第二步:寻找依赖(DTK、hipcc、运行时库)
DCU 的开发工具叫 **DTK(DCU Toolkit)**,它本质上是 AMD ROCm 的国产化发行版。所以我们写代码用的 API 是 **HIP(Heterogeneous-Compute Interface for Portability)**——和 CUDA 几乎一一对应。
#### 编译器在哪?
`hipcc` 一定藏在 DTK 安装目录里。不同集群的 DTK 版本不一定一样,先在交互节点上探测一下:
```bash
ls /public/software/compiler/rocm/
# 典型输出:dtk-25.04.4 dtk-24.04.1 dtk-22.10.1
```
找到版本后,编译器路径就是:
```bash
HIPCC=/public/software/compiler/rocm/dtk-25.04.4/hip/bin/hipcc
```
#### 运行时库
DCU 程序运行时需要加载 ROCm 的动态库,否则会报 `libamdhip64.so` 找不到。统一加到 `LD_LIBRARY_PATH` 即可:
```bash
DTK=/public/software/compiler/rocm/dtk-25.04.4
export LD_LIBRARY_PATH=$DTK/lib:$DTK/lib64:$DTK/hip/lib:$LD_LIBRARY_PATH
```
#### 一键探测脚本(推荐加到 `~/.bashrc`)
把下面这一段加到作业脚本开头,**自动找最新可用的 DTK**,避免写死路径:
```bash
DTK_VER=""
for try_ver in "dtk-25.04.4" "dtk-24.04.1" "dtk-22.10.1"; do
candidate="/public/software/compiler/rocm/${try_ver}/hip/bin/hipcc"
if [ -f "$candidate" ]; then
DTK_VER="$try_ver"
break
fi
done
[ -z "$DTK_VER" ] && { echo "找不到 DTK,请联系超算管理员"; exit 1; }
DTK=/public/software/compiler/rocm/$DTK_VER
export HIPCC=$DTK/hip/bin/hipcc
export LD_LIBRARY_PATH=$DTK/lib:$DTK/lib64:$DTK/hip/lib:$LD_LIBRARY_PATH
echo "使用 DTK: $DTK_VER"
```
---
### 2.3 第三步:编译与链接
#### 最小编译命令
假设你只有一个源文件 `hello_dcu.cpp`,里面包含 HIP kernel:
```bash
$HIPCC -std=c++14 -O2 \
--offload-arch=gfx906 \
-o hello_dcu hello_dcu.cpp
```
> **新手最常踩的坑**:忘了加 `--offload-arch=gfx906`,编译能过,但运行时 `hipGetDeviceCount` 返回 0,程序直接退出而无明显报错。
> `gfx906` 对应海光深算一号(Z100)和 AMD MI50/MI60。如果你是深算二号 K100,需要换成 `gfx940` 或 `gfx942`(具体看集群文档)。
#### 关键参数
| 参数 | 作用 |
|---|---|
| `-std=c++14` | HIP 头文件要求至少 C++14 |
| `-O2 / -O3` | 优化等级,DCU 计算代码建议 `-O3` |
| `--offload-arch=gfx906` | 目标 DCU 架构,**必加** |
| `-I/path` | 第三方头文件目录(如 netcdf、hdf5) |
| `-L/path -lxxx` | 链接第三方库 |
| `-Wl,-rpath,/path` | 把库路径烧进可执行文件,避免运行时找不到 |
#### 完整实战例子(链接 NetCDF + HDF5)
这是真实项目里常见的"既要科学库又要 GPU"的编译命令:
```bash
NC_LIB=/public/home/achwjznh4b/install/bin/glnxa64
NC_INC=/public/sourcecode/amber18/AmberTools/src/netcdf-4.3.0/include
$HIPCC -std=c++14 -O3 \
--offload-arch=gfx906 \
-I"$NC_INC" \
-o myapp myapp.cpp \
-L"$NC_LIB" -l:libnetcdf.so.7 -l:libhdf5.so.8 \
-Wl,-rpath,"$NC_LIB"
```
注意:`-l:libnetcdf.so.7` 这种写法是直接链接具体的 .so 文件名,比 `-lnetcdf` 更稳(避免版本冲突),上面的"科学计算库"就是读取netCDF的库。
---
### 2.4 实例 1:查看当前节点的 DCU 设备信息
在写第一个 kernel 之前,**先确认你申请到的节点上确实有 DCU,并且版本对**。有两种方式:
#### 方式 A:Shell 一行命令(最快)
```bash
rocm-smi
```
输出类似:
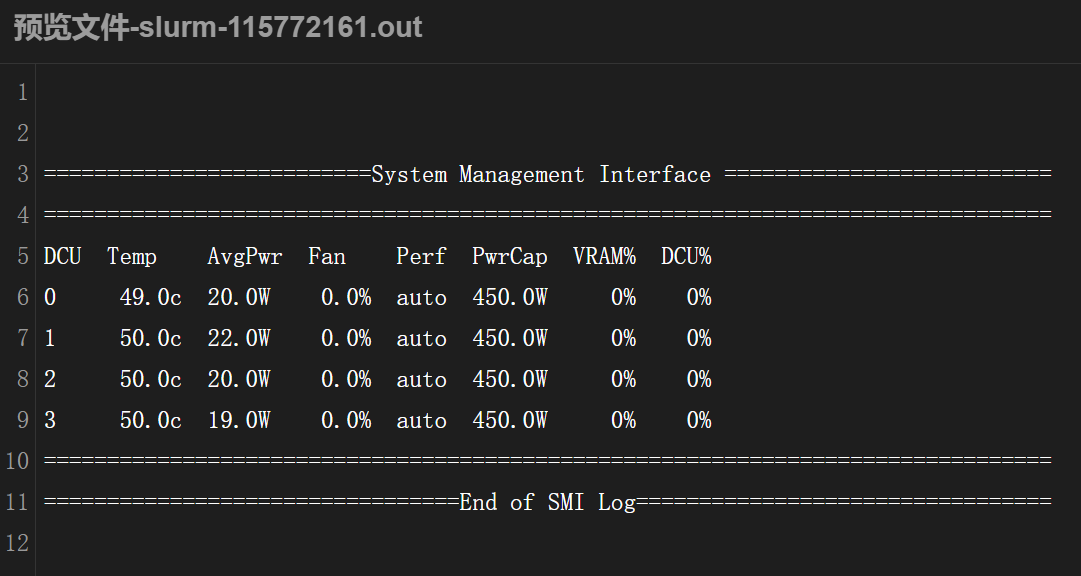
如果想看更详细的信息(频率、显存、温度):
```bash
rocm-smi --showmeminfo vram --showuse --showtemp
```
#### 方式 B:写一个 C++ 程序通过 HIP API 查询
文件 `query_dcu.cpp`:
```cpp
#include
#include
int main() {
int n = 0;
hipError_t err = hipGetDeviceCount(&n);
if (err != hipSuccess) {
printf("HIP 错误: %s\n", hipGetErrorString(err));
return 1;
}
printf("检测到 %d 张 DCU/GPU\n", n);
for (int i = 0; i < n; i++) {
hipDeviceProp_t prop;
hipGetDeviceProperties(&prop, i);
printf("\n=== DCU %d ===\n", i);
printf("名称 : %s\n", prop.name);
printf("架构 : %d.%d\n", prop.major, prop.minor);
printf("全局显存 : %.1f GB\n", prop.totalGlobalMem / 1e9);
printf("每个 block 的 shared mem: %zu KB\n", prop.sharedMemPerBlock / 1024);
printf("每个 block 的最大线程数: %d\n", prop.maxThreadsPerBlock);
printf("多处理器数量: %d\n", prop.multiProcessorCount);
}
return 0;
}
```
编译运行(记得按照第三步操作!):
```bash
$HIPCC -std=c++14 -O2 --offload-arch=gfx906 -o query_dcu query_dcu.cpp
./query_dcu
```
预期输出(节选):

> 看到这些数字基本就能判断这张卡的算力档位。`gfx906 + 60 CU` 就是海光深算一号/AMD MI50 这一档。
---
### 2.5 实例 2:第一个真正的 DCU 程序——向量加法
这是 GPU 编程的"Hello World":计算 `C = A + B`,A、B、C 各 1024 万个 float。
文件 `vec_add.cpp`:
```cpp
#include
#include
#include
// HIP_CHECK: 任何 HIP API 失败立刻报错退出
#define HIP_CHECK(cmd) do { \
hipError_t e = cmd; \
if (e != hipSuccess) { \
printf("HIP 错误 %s:%d: %s\n", \
__FILE__, __LINE__, hipGetErrorString(e)); \
exit(1); \
} \
} while(0)
// __global__ 标记的函数会被编译成 DCU 上的 kernel
__global__ void vec_add(const float* A, const float* B, float* C, int n) {
int i = blockIdx.x * blockDim.x + threadIdx.x;
if (i < n) {
C[i] = A[i] + B[i];
}
}
int main() {
const int N = 1 << 24; // 1677 万个元素
const size_t bytes = N * sizeof(float);
// 1) 分配主机端内存并初始化
float *hA = (float*)malloc(bytes);
float *hB = (float*)malloc(bytes);
float *hC = (float*)malloc(bytes);
for (int i = 0; i < N; i++) {
hA[i] = 1.0f;
hB[i] = 2.0f;
}
// 2) 分配 DCU 显存
float *dA, *dB, *dC;
HIP_CHECK(hipMalloc(&dA, bytes));
HIP_CHECK(hipMalloc(&dB, bytes));
HIP_CHECK(hipMalloc(&dC, bytes));
// 3) 把数据从内存拷到 DCU(H2D)
HIP_CHECK(hipMemcpy(dA, hA, bytes, hipMemcpyHostToDevice));
HIP_CHECK(hipMemcpy(dB, hB, bytes, hipMemcpyHostToDevice));
// 4) 启动 kernel
int block = 256;
int grid = (N + block - 1) / block;
vec_add<<>>(dA, dB, dC, N);
HIP_CHECK(hipGetLastError()); // 检查 kernel 启动是否成功
HIP_CHECK(hipDeviceSynchronize()); // 等待 DCU 算完
// 5) 把结果拷回内存(D2H)
HIP_CHECK(hipMemcpy(hC, dC, bytes, hipMemcpyDeviceToHost));
// 6) 验证结果
printf("C[0] = %f(应为 3)\n", hC[0]);
printf("C[N-1] = %f(应为 3)\n", hC[N - 1]);
// 7) 释放资源
HIP_CHECK(hipFree(dA));
HIP_CHECK(hipFree(dB));
HIP_CHECK(hipFree(dC));
free(hA);
free(hB);
free(hC);
return 0;
}
```
#### 在 SLURM 作业里运行
把上面命令拼成 `vec_add.sh` 提交:
```bash
#!/bin/bash
#SBATCH -p kshdmcc2026
#SBATCH -N 2
#SBATCH -n 64
#SBATCH --exclusive
#SBATCH --gres=dcu:4
#SBATCH -J MCC_RUN
DTK_VER=""
for try_ver in "dtk-25.04.4" "dtk-24.04.1" "dtk-22.10.1"; do
candidate="/public/software/compiler/rocm/${try_ver}/hip/bin/hipcc"
if [ -f "$candidate" ]; then
DTK_VER="$try_ver"
break
fi
done
[ -z "$DTK_VER" ] && { echo "找不到 DTK,请联系超算管理员"; exit 1; }
DTK=/public/software/compiler/rocm/$DTK_VER
export HIPCC=$DTK/hip/bin/hipcc
export LD_LIBRARY_PATH=$DTK/lib:$DTK/lib64:$DTK/hip/lib:$LD_LIBRARY_PATH
echo "使用 DTK: $DTK_VER"
$HIPCC -std=c++14 -O2 --offload-arch=gfx906 -o vec_add vec_add.cpp
./vec_add
```
提交运行结果:

---
### 小结
到这里,你已经掌握了 DCU 编程的**完整最小链路**:
```
写 SLURM 脚本申请资源 → 探测/配置 DTK → hipcc 编译 → 提交作业运行
(2.1 节) (2.2 节) (2.3 节) (2.5 节)
```
下一节我们会从"向量加法"升级到真实的科学计算场景:利用 DCU 的多卡并行 + HIP 流并发,做一个**滑动窗口气候态统计**程序。
全部评论(0)
只看楼主
 暂无数据
--
楼主
0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据