本文档以密度泛函中密度的计算为例,介绍流的使用。
一般来说,DCU计算的过程可以分为三步:
(1) HOST到DCU的数据传输
(2)DCU上的数据计算
(3) DCU到HOST的数据传输。
如果在计算中不指定流,程序一般是在默认流上运行,在编程中如果想使用多个流,则可以显示的创建流:
hipStreamCreate(hipStream_t pStream);
或者: hipStreamCreateWithFlags(hipStream_t pStream) *
以密度泛函程序中密度的计算流程为例,假设我们创建4个流,将计算分为多个block,代码流程大概如下:
do i = 1,npblk
B =
dm_p(i,j)
C =
dgemm(B,Bas)
den(i) = ddot(C,Bas)
end do
计算过程大致为:
hipStreamCreate(&stream); ! 初始化流
hipMalloc(d_b, size_b) ! 为数组分配内存空间
hipMemcpy(d_b, &b, size_b, hipMemcpyHostToDevice) ! host to dcu 数据传输
for(int stream_id = 0; ! 从不通的流启动计算
stream_id < 4; i++){
ddot_gpu<<<blocks,
threads, 0, stream[i]>>>(d_c, d_bas, d_b, stream_num, stream_id,
npblk, nspn, nu, d_weights, d_e, d_zk, d_vlda, d_den)
}
hipDeviceSynchronize() !同步
hipMemcpy(&den,d_den, size_den, hipMemcpyDeviceToHost) ! 拷贝数据到HOST
hipStreamDestroy(hipStream_t stream) !资源释放
Stream[i]为申请的显式流的id,如果填0则使用的是默认流,这里我们使用4个显式流执行任务,由于不同流之间是异步的,因此计算可以重叠,使用hipprof进行性能分析如下:
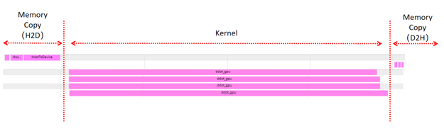
可以看到,流是并行运行的,但是数据拷贝并没有并行。流的运行只有等数据拷贝结束后才能启动。而DCU到host的拷贝也只有等流计算结束后才能启动。
如果要实现计算的拷贝的重叠,需要采取锁页内存(pinned memeory)方法来实现, 可以使用以下函数来申请锁页内存:
hipHostMalloc(void ptr, size_t size, unsigned intflags)
也可以将已经申请的内存修改为锁页内存:
hipHostRegister(void ** *hostPtr, size_t sizeBytes, unsigned int flags)
使用锁页内存在流内拷贝的方法如下:
hipMemcpyAsync(&d_b,&b,size_b/stream_num ,hipMemcpyHostToDevice,stream) ! 异步 HOST到DCU拷贝
for(int stream_id = 0; ! 从不通的流启动计算(与上同)
stream_id < 4; i++){
**ddot_gpu<<<blocks,
threads, 0, stream[i]>>>(d_c, d_bas, d_b, stream_num, stream_id,
npblk, nspn, nu, d_weights, d_e, d_zk, d_vlda, d_den)}
hipMemcpyAsync(&b,&d_b,size_b/stream_num ,hipMemcpyDeviceToHost,stream) 异步拷贝数据到HOST
全部完成后,使用hipHostFree释放分页锁定内存,避免因减少系统可分页的物理存储器数量,而降低系统的整体性能。
使用hipprof分析的计算与拷贝时间情况如下:
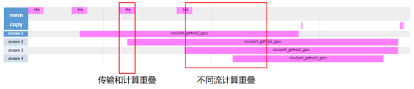
从图中可以看出,使用该方法可以实现不同流之间计算和拷贝的重叠,以及计算和计算的重叠。
以上只是简单示例,欢迎多提宝贵意见。
 暂无数据
 暂无数据 暂无数据