0
5
0
0
【光合基金分享】OpenChiral 一款模拟质子、中子以及轻核质量的内部结构及其量子效应的贡献与影响
2022-11-18 16:12:26
230
OpenChiral将主要基于HIP C++编写。70%的计算将在dcu上完成,cpu只负责控制和轻量的计算任务。在格点计算中,我们把格子分成等体积的多个区域。每个并行的线程负责一个独立的区域,所有的数据也被相应的分到不同的线程上,由相应的内存和处理器来分别独立操作。格子在每个区域,具有相同的形状,需要几乎一样操作,这就非常利于我们实现并行加速。
为了最大程度地实现格点上夸克的手征对称性,我们需要使用比简单的差分操作复杂得多的方案来离散化夸克的运动方程。这就是基于overlap夸克作用量,手征对称性能够保证离散化操作本身不会对夸克质量造成额外的修正,所以对于研究物质质量起源等问题十分关键。OpenChiral主要目标是将基于overlap作用量的cpu代码移植到C86及其加速卡的计算平台。
主要的并行优化策略:格点QCD中代码中最主要的操作是dslash(D)差分操作,在overlap作用量中,手征费米子计算中的基本单元是D共轭和 D的组合操作,如果能合并这两个操作,将极大的减少cpu与加速卡之间的重复数据传输,从而可以达到更高的计算性能,在目前英伟达开发的gpu加速软件QUDA框架下几乎无法实现。
其他并行优化策略:除了在DCU代码中实现QUDA上su3矩阵压缩,我们还将采取通过异步通信掩盖延时。如下图所示,我们将计算和通讯分成两个同时进行的流,一个主要负责具体的运算操作(dslash操作),另一个流主要负责线程间得通讯。这样可以极大地减少计算等待通讯的时间,从而掩盖延时。
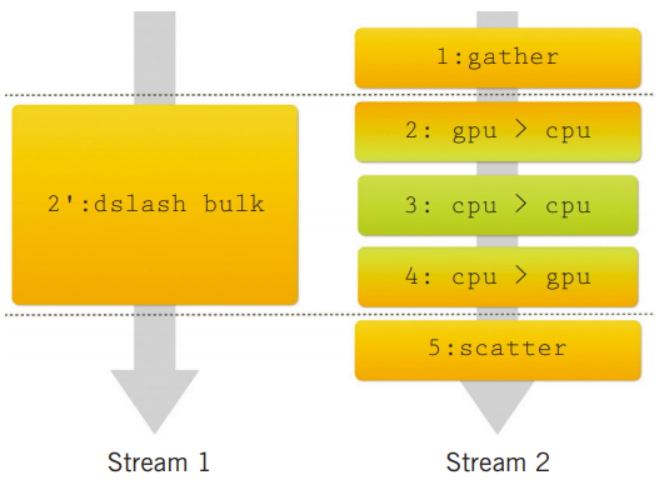
除此之外我们还将针对c86架构对核函数和通信进行深度优化:包括但不限于合并稀疏矩阵操作和矢量计算,以及重复使用数据的多个矢量计算等,以上正是OpenChiral的优化策略。
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据