换sglang部署吧,吊打vllm
0
1
0
0
两卡K100AI跑Qwen3.8-27B都有哪些优化手段?
2026-08-27 11:34:14
539
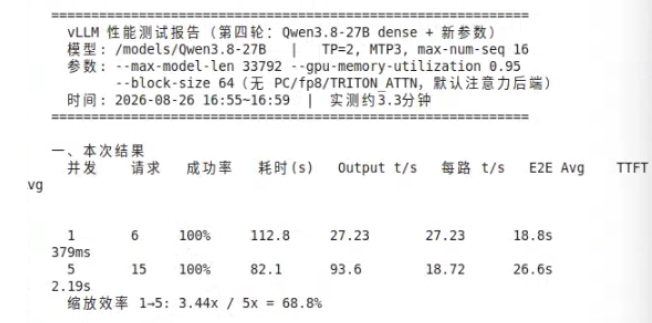
我希望目标优化到40tok/s,目前只有27tok/s,还有什么优化手段吗
docker run -dit --name=dcm38 --network=host --privileged --shm-size 60g -v /opt/hyhal:/opt/hyhal:ro --device=/dev/kfd --device=/dev/dri --device=/dev/mkfd --group-add video --cap-add=SYS\_PTRACE --security-opt seccomp=unconfined -u root -v /home/user/dcm/models:/models -e HIP\_VISIBLE\_DEVICES=0,1 harbor.sourcefind.cn:5443/dcu/admin/base/custom:vllm0.18.1-ubuntu22.04-dtk26.04-py3.10-20260810-qwen3.8 bash
vllm serve /models/Qwen3.8-27B --host 0.0.0.0 -tp 2 --max-model-len 33792 --max-num-seq 16 --gpu-memory-utilization 0.95 --block-size 16 --speculative-config.method mtp --speculative-config.num\_speculative\_tokens 3
绑定NUMA
全部评论(7)
只看楼主
B
9/5
江
你跑int8版本啊,我单卡都有35t/s
8/29
彭
道友, 优化成功了吗
8/28
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据