收到您的反馈,我们确认下给您回复
0
3
0
0
请问qwen3.5的专用镜像是不是还不支持AWQ?设备为K100AI
2026-02-27 09:32:39
341
用qwen3.5专用镜像,参考https://developer.sourcefind.cn/modelzoo/list/qwen3.5_vllm/detail?post_id=46176b42-0c0b-11f1-a49f-0242ac150003
部署Qwen3.5-27B-AWQ-4bit模型报错(https://modelscope.cn/models/cyankiwi/Qwen3.5-27B-AWQ-4bit/summary)
报错内容:
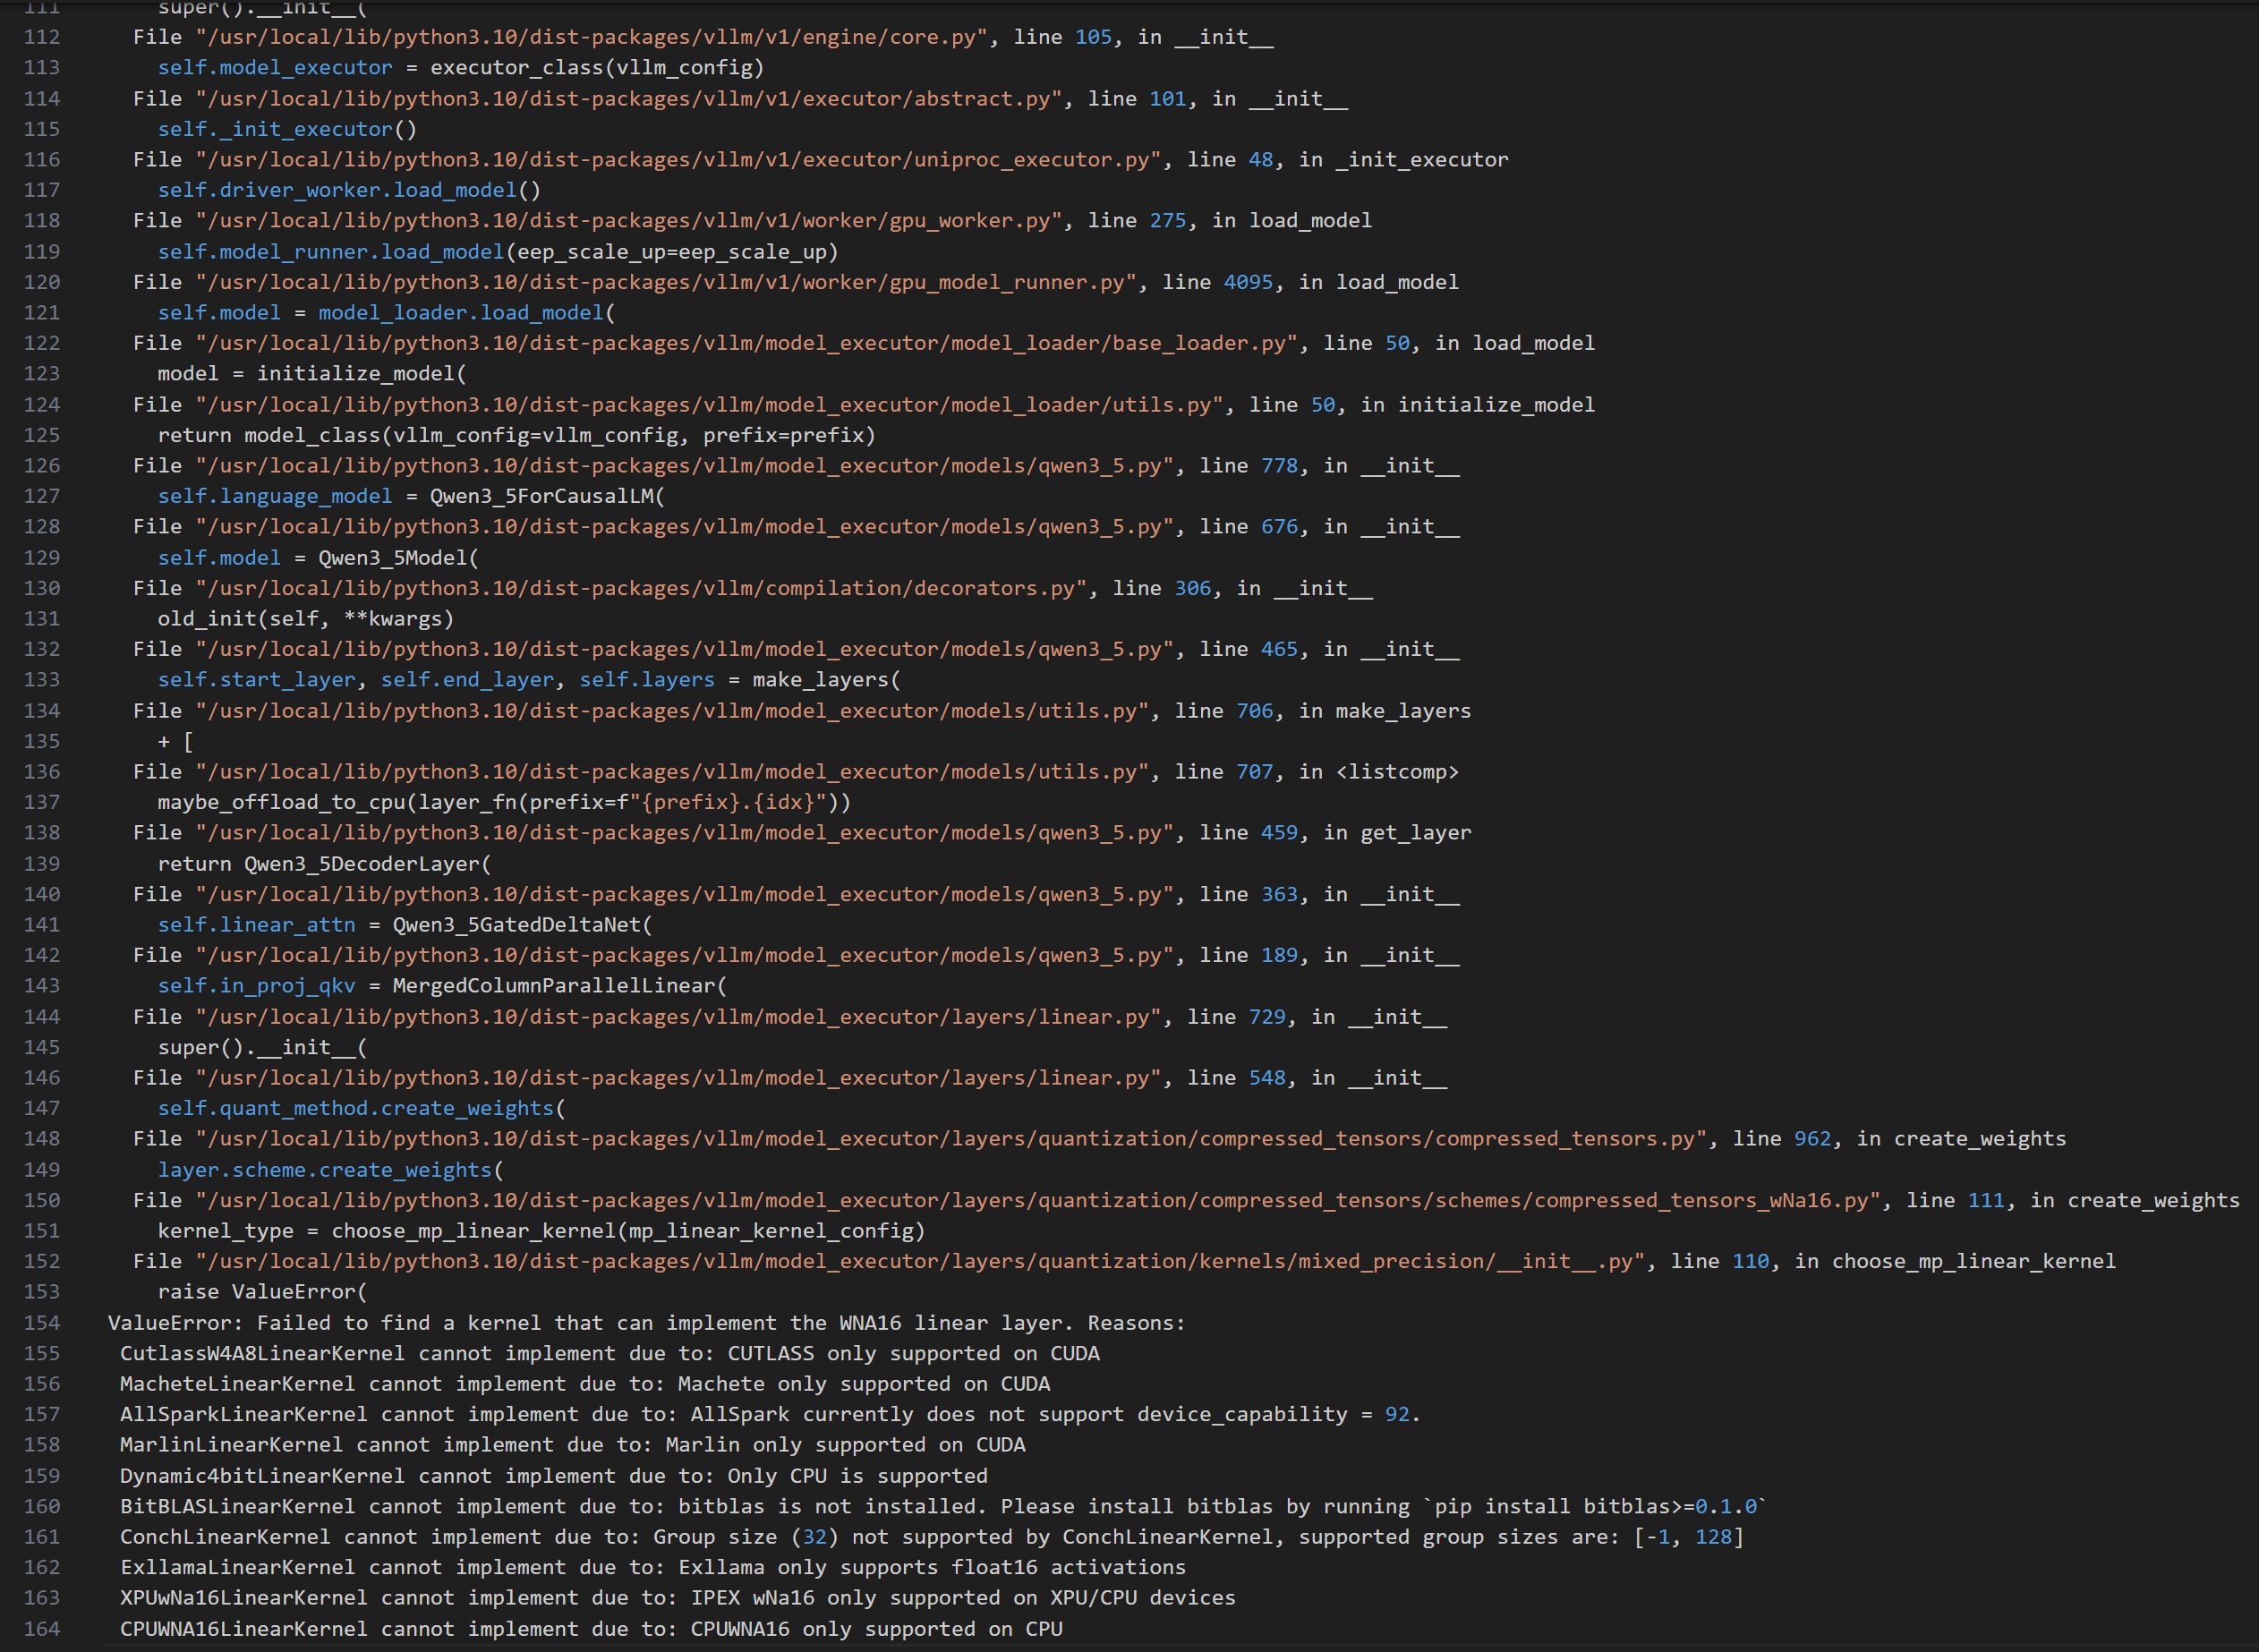
起镜像的命令是:
#!/bin/bash
docker run -it \
--name test_qwen3_5 \
--shm-size 200g \
--network=host \
--name qwen3.5 \
--privileged \
--device=/dev/kfd \
--device=/dev/dri \
--device=/dev/mkfd \
--group-add video \
--cap-add=SYS_PTRACE \
--security-opt seccomp=unconfined \
-u root \
-v /opt/hyhal/:/opt/hyhal/:ro \
--volume /home/test:/root \
--ipc=host \
image.sourcefind.cn:5000/dcu/admin/base/custom:pytorch2.9.1-ubuntu22.04-dtk26.04-0130-py3.10-20260204-qwen3_5 bash
启动vllm的命令是(只用一张K100AI卡):
#!/bin/bash -x
export HIP_VISIBLE_DEVICES=0
export VLLM_LOGGING_LEVEL=DEBUG

export VLLM_SPEC_DECODE_EAGER=1
export VLLM_MLA_DISABLE=0
export VLLM_USE_FLASH_MLA=1
export VLLM_RPC_TIMEOUT=1800000

export VLLM_NUMA_BIND=1
export VLLM_RANK0_NUMA=0
export VLLM_RANK1_NUMA=1
export VLLM_RANK2_NUMA=2
export VLLM_RANK3_NUMA=3
export VLLM_RANK4_NUMA=4
export VLLM_RANK5_NUMA=5
export VLLM_RANK6_NUMA=6
export VLLM_RANK7_NUMA=7

vllm serve /root/models/Qwen3.5-27B-AWQ-4bit \
  --served-model-name Qwen3.5-27B-AWQ-4bit \
  --tensor-parallel-size 1\
  --max-model-len 262144 \
  --reasoning-parser qwen3 \
  --enable-prefix-caching \
  --gpu-memory-utilization 0.9 \
  --port 9100
Qwen3.5-397B
GPTQ-4bit
全部评论(9)
只看楼主
A
2/27
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据