0
7
0
0
一套可复用的海光DCU优化思路:来自真实HPC项目实践
2026-08-19 18:32:57
104
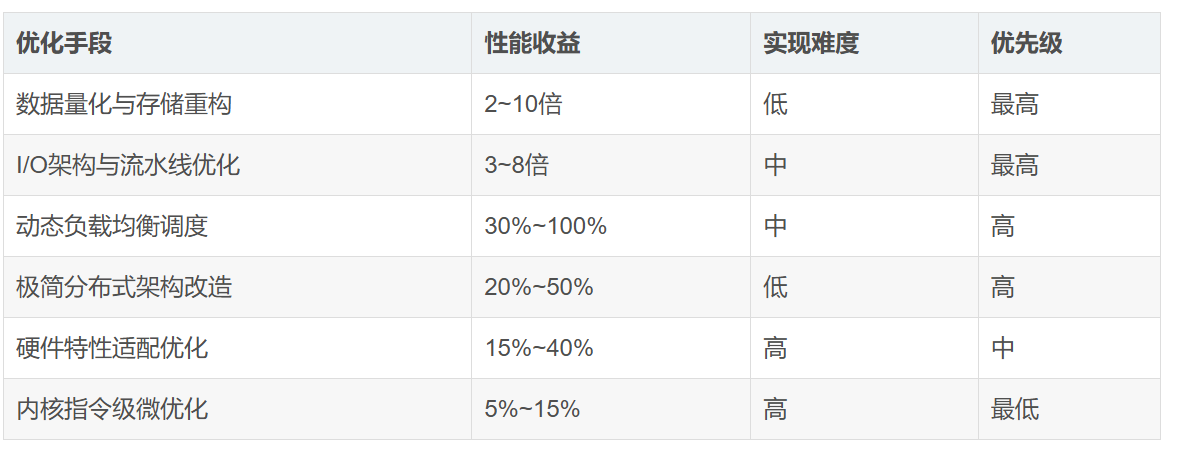
一、我的核心实战认知:DCU优化,优先级完全和传统GPU相反
在接触海光DCU初期,我和大多数开发者一样,沿用CUDA 的固有思路:把主要精力放在内核函数优化上,执着于消分支、循环展开、指令优化、共享内存调优。但整套迭代下来发现,这些细碎的代码改动,对整体性能的提升微乎其微。
在本次万倍加速的项目落地中,我最终总结出了DCU高性能优化的核心优先级:数据架构 > I/O调度 > 任务并行模型 > 内核细节优化。
这也是绝大多数新手最容易产生的认知偏差:过度聚焦计算逻辑,忽略了数据流转才是DCU HPC项目的真正性能上限。海光DCU的算力本身冗余度极高,绝大多数场景下,GPU永远在等数据,而非算不完数据。
所以我在实战中刻意调整了优化重心:放弃无休止的内核微优化,把80%的精力投入到数据预处理、文件读取优化、任务调度架构调整上,最终实现了量级式的性能提升。
二、可复用思路:用数据取舍换极致性能,是性价比最高的优化
在传统开发思维中,我们习惯性追求数据精度最大化、无损化,不敢做任何数据压缩和精度简化。但在真实的工程落地中,我发现合理的数据量化与存储重构,是DCU项目收益最高的优化方式。
本次项目中,我没有局限于浮点数据的原生存储方式,而是主动将float浮点数据量化为short短整型存储。这一个简单的工程取舍,直接让整体显存占用、主机到设备传输量、集群I/O压力全部减半。
更关键的是,经过实测验证,量化带来的精度损耗微乎其微,远低于海洋观测数据本身的误差,完全满足业务验证标准。用可忽略的精度代价,换取翻倍的整机吞吐性能,是非常划算的工程决策。
这也是新手普遍存在的认知误区:执着于绝对精度,不敢做任何工程妥协。实际上,高性能计算的核心不是极致精准,而是在业务允许的精度范围内,最大化硬件算力利用率。这套量化优化思路,完全可以复用在气象、海洋、环境等大规模科学计算场景中。
三、可复用思路:摒弃复杂框架,极简架构才是最高性能
最开始做分布式 并行开发时,我和很多人一样,第一时间想到引入MPI分布式框架,想用成熟的通信框架做多节点任务调度。但在实际测试中发现,对于天然尴尬并行、节点间无数据交互的HPC任务,复杂框架带来的启动开销、调度开销、兼容性开销,远大于其并行收益。
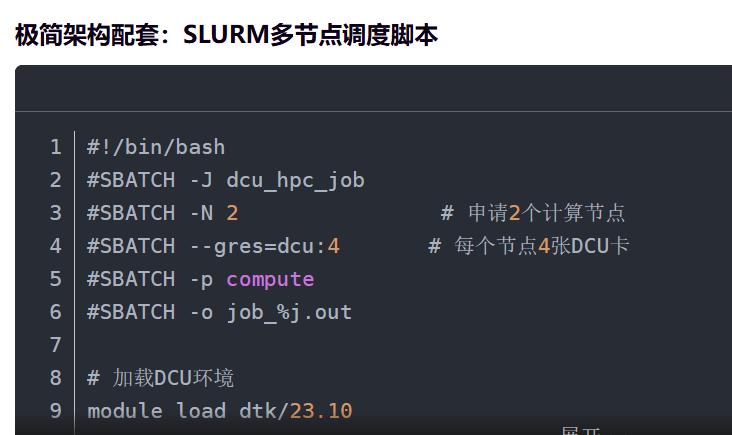
于是我在最终方案中主动舍弃了所有复杂分布式框架,采用独立节点+无通信架构,通过SLURM直接调度多节点任务,全程零MPI依赖。架构简化之后,不仅代码逻辑更清晰、故障率更低,还直接省去了数秒的无效串行开销。
这是我落地项目后最大的感悟:高性能计算,从来不看技术栈有多复杂,只看无效开销有多少。很多新手盲目堆砌各类并行框架、封装多层工程结构,看似技术专业,实则给程序增加了大量不确定开销,反而限制了硬件性能。
针对所有独立分片、无跨节点通信的DCU任务,最简的裸架构,永远是最优解。
四、可复用思路:拒绝静态分片,动态调度适配真实集群环境
早期迭代版本中,我采用的是行业通用的静态任务分片方案:提前给每个线程、每张DCU固定分配计算任务。这种方式在本地小数据测试时非常稳定,但迁移到集群并行文件系统后,性能波动极大。
核心原因是Lustre、ParaStor这类并行文件系统存在天然的I/O抖动,不同线程读取文件的耗时差异极大,静态分片会直接导致部分线程早早空闲,部分线程阻塞等待,整体算力利用率大打折扣。
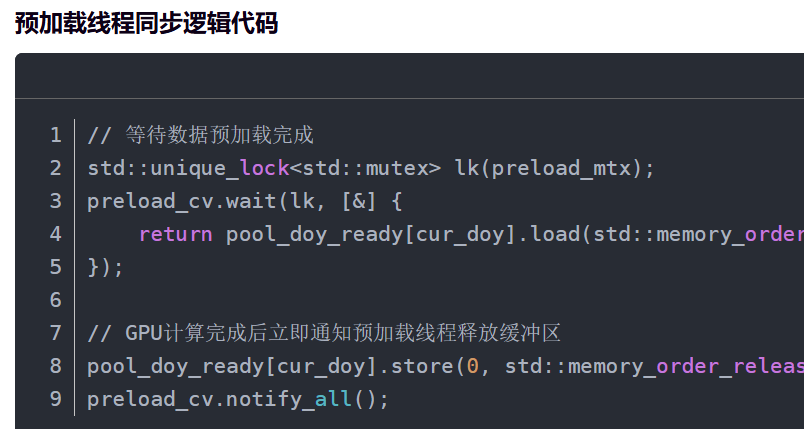
针对这个问题,我最终采用了工作窃取动态调度思路,让所有预加载线程通过原子操作竞争任务,不再人工固定分片。集群I/O快的线程会自动多承担任务,慢速线程少承担,实现全自动负载均衡。
对比下来我深刻意识到:人工静态调优永远适配不了动态的集群环境。新手容易过度依赖手动调参、固定分片,忽略集群环境的不确定性,导致硬件算力始终跑不满。动态负载调度,是所有大规模多线程I/O密集型DCU项目的通用最优解。
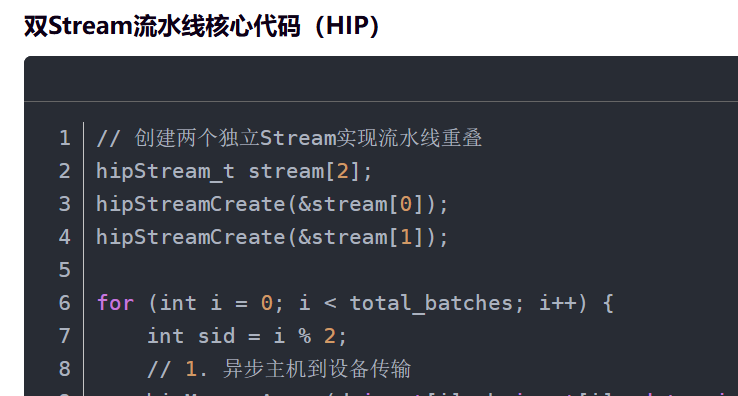
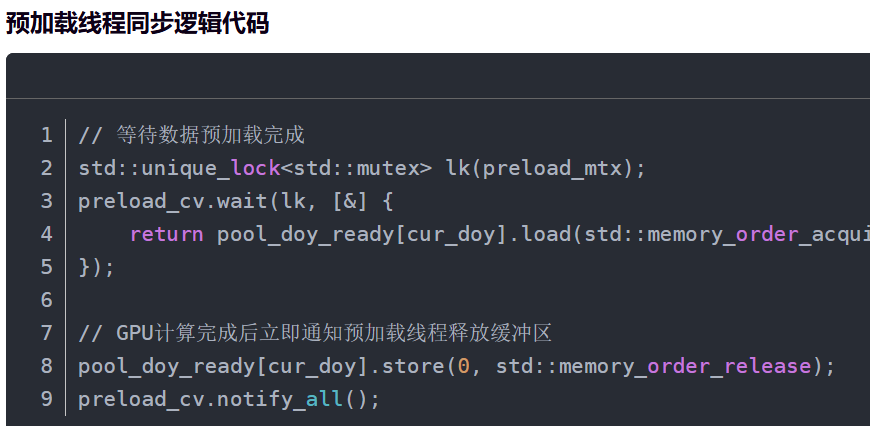
五、可复用思路:适配DCU硬件特性,拒绝CUDA思维照搬
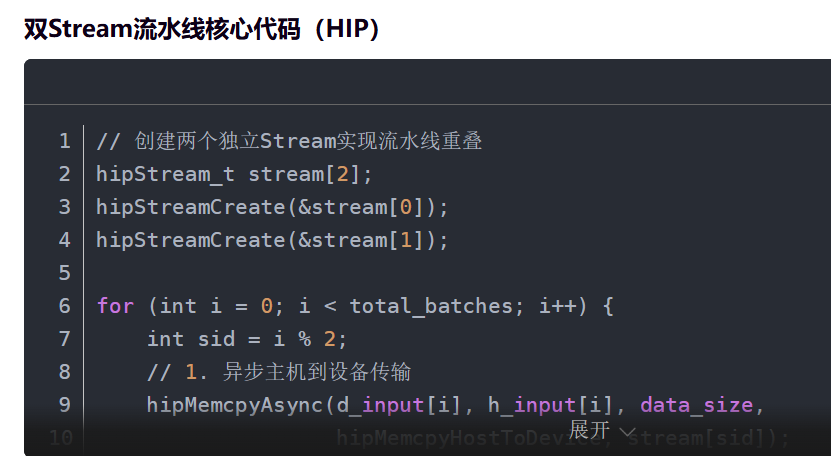
作为从CUDA迁移到DCU的开发者,我最深刻的体会是:CUDA的最优开发范式,并不适配海光CDNA架构,盲目照搬经验,只会让DCU性能被严重限制。
比如CUDA开发中常用的共享内存排序、细粒度任务拆分、多流堆叠等优化手段,在DCU上收益极低,甚至会产生负优化。DCU的Wave64调度特性、超大寄存器堆、高带宽HBM的硬件特点,决定了它更适合大粒度规整计算、寄存器级数据缓存、精简流水线的开发模式。
本次项目中,我放弃了传统共享内存排序方案,利用DCU寄存器优势,在寄存器内维护Top34有序数组,零显存、零LDS通信开销,适配硬件特性的同时,大幅提升了计算效率。
很多新手开发者的通病,就是拿着CUDA的固有经验套用到DCU开发中,代码可以正常运行,但永远无法触达硬件性能极限。适配国产GPU,核心不是语法兼容,而是开发思维的硬件适配。
常见优化手段
CUDA平台效果
DCU平台效果
核心差异原因
共享内存排序
性能大幅提升
收益低甚至负优化
DCU寄存器堆更大,LDS Bank冲突开销高
多流并发堆叠
带宽利用率提升
收益有限易抢资源
DCU HBM带宽本身已饱和,多流抢占无增益
细粒度任务拆分
调度更灵活
Wave启动开销剧增
Wave64调度粒度大,小任务 overhead 更高
循环深度展开
指令并行提升
易挤占寄存器
DCU单Wave寄存器资源有限,展开降低占用率
大粒度规整计算
收益一般
性能大幅提升
Wave64锁步执行天然适配大块连续计算
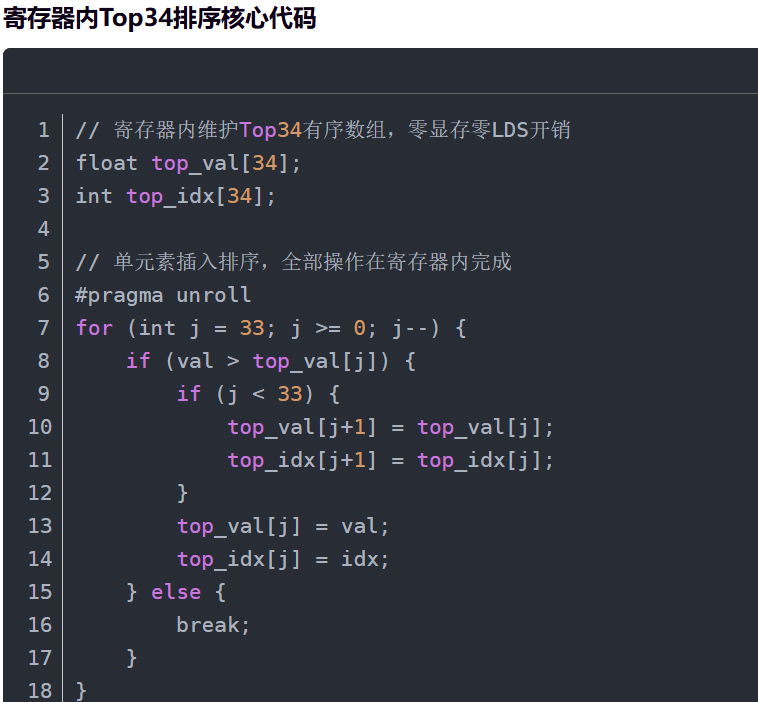
六、可复用思路:以硬件计数器为唯一标准,拒绝盲目迭代优化
在整个调优过程中,我最大的成长,是告别了“凭感觉优化”的开发模式,完全以rocprof硬件计数器数据为核心依据。
通过硬件指标可以清晰看到,本项目GPU内存单元占用率达到99.7%,属于典型的HBM带宽瓶颈,ALU算力长期处于闲置状态。这就意味着,所有针对内核计算逻辑的微优化,都是无效迭代。
大部分新手会陷入无休止的代码微调、参数试错中,反复迭代却看不到性能提升。本质原因就是没有找准真实瓶颈,优化方向完全错位。
我在项目中总结出一条很实用的准则:看懂硬件瓶颈,比会写优化代码更重要。当硬件计数器证明已经触达硬件极限时,及时停止优化,避免无效工作,也是工程能力的体现。
rocprof核心指标
阈值参考
对应瓶颈类型
优先优化方向
MemUnitBusy
> 95%
HBM带宽瓶颈
数据量化、访存重排、减少冗余传输
VALUUtilization
< 50%
算力闲置瓶颈
增大计算粒度、优化任务调度、喂饱数据
L2CacheHit
< 30%
缓存命中瓶颈
调整数据排布、合并访存、优化访问局部性
WaveOccupancy
< 30%
并行度瓶颈
减少寄存器使用、增大block数量、降低共享内存占用
FetchSize
远大于计算量
访存密集瓶颈
增加计算密度、复用数据、减少全局内存访问
七、核心体系可视化
DCU实战优化新旧方案对比表
优化维度
新手传统方案(踩坑版)
实战最优方案(可复用版)
核心收益
优化重心
聚焦内核分支、循环展开、指令优化
优先数据架构、I/O流转、任务调度
规避无效微优化,实现量级性能提升
数据存储方式
原生float/double无损存储,占用显存高
short量化存储,业务精度可控妥协
显存、传输、I/O压力减半
分布式架构
盲目引入MPI框架,冗余开销大
无通信极简架构,SLURM原生调度
消除框架开销,程序更稳定高效
任务调度模式
人工静态分片,适配性差
工作窃取动态调度,自动负载均衡
适配集群I/O抖动,拉满算力利用率
开发思维
照搬CUDA共享内存、多流堆叠优化
适配CDNA架构,寄存器优先、大粒度计算
贴合DCU硬件特性,突破性能上限
调优依据
凭经验、凭感觉盲目迭代
rocprof硬件计数器数据驱动调优
精准定位瓶颈,杜绝无效优化
数据量化核心代码(精度换性能)
// 浮点数据量化为short,大幅降低显存与传输开销
const double inv = 1.0 / g_scale;
#pragma GCC ivdep
for (int i = 0; i < GRID_SIZE; i++) {
double sv = raw_buf[i] * inv;
// 空值填充+四舍五入量化,精度损耗可忽略
dest[i] = (sv == sv) ? (short)lround(sv) : g_fill;
}
// GPU端实时解码,还原计算精度
float v = (float)((double)raw * scale_factor + add_offset);
Lobster AI
工作窃取动态调度核心代码
// 原子竞争任务,实现全自动负载均衡
std::atomic next_pool_idx{0};
while ((pi = next_pool_idx.fetch_add(1, std::memory_order_relaxed)) < node_pool_doys) {
// 动态抢占任务,适配集群I/O快慢波动
// 完成单DOY数据预加载,标记就绪通知GPU计算
pool_doy_ready[pi].store(1, std::memory_order_release);
preload_cv.notify_all();
}
Lobster AI
硬件瓶颈判定核心指令(调优必备)
# rocprof统计硬件计数器,快速定位DCU真实瓶颈
rocprof --stats ./dcu_program
# 核心判定规则
# 1. MemUnitBusy > 95%:HBM带宽瓶颈,无需优化内核
# 2. VALUUtilization 偏低:算力闲置,数据喂不饱GPU
# 3. L2CacheHit 偏低:需优化数据访存布局
Lobster AI
八、最终总结:属于DCU HPC开发的通用优化逻辑
跑完本次万倍加速的真实项目,我沉淀出这套可复用的海光DCU优化思路,也彻底理清了国产异构高性能开发的核心逻辑:
1. 算力冗余是常态,优先优化数据流转与I/O架构,而非内核细节;
2. 合理的精度取舍、数据量化,是性价比最高的工程优化;
3. 无意义的框架堆叠只会增加开销,极简架构适配绝大多数HPC场景;
4. 放弃人工静态分片,用动态调度适配真实集群的I/O波动;
5. 摒弃CUDA固化思维,基于DCU硬件特性做针对性开发;
6. 数据驱动调优,找准硬件瓶颈,拒绝盲目迭代优化。
相比于代码技巧,这套工程思维,才是本次项目最大的收获。也希望这些来自一线实战的真实经验,能给正在学习海光DCU、做国产异构计算开发的开发者提供一些切实的参考。
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据