1
2
编译器
Z100L编译llama.cpp与运行qwen gguf问题
2024-11-21 09:39:49
214

参考了 https://github.com/ggerganov/llama.cpp?tab=readme-ov-file#hipblas

如果用的是Z100L的卡的话,target选择gfx926。
编译成功了 但启动时也没报错 但打印的信息是用的CPU。
请问这样是否是编译成功,或者请给出编llama.cpp的脚本。attachmentId-image.png
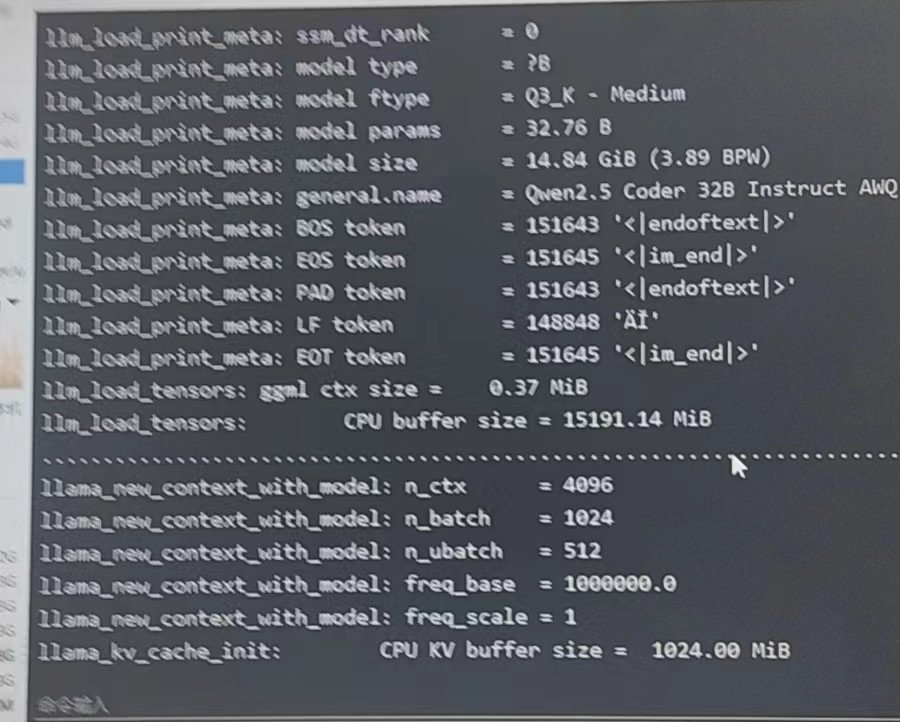
另外请问是否支持llama.cpp上启动gguf模型,如果支持,请给命令指导

全部评论(3)
只看楼主
索
索大喝旺仔
楼主
2楼
cmake -S . -B build -DCMAKE_POSITION_INDEPENDENT_CODE=on -DLLAMA_CCACHE=OFF -DLLAMA_NATIVE=off -DLLAMA_AVX=on -DLLAMA_AVX2=off -DLLAMA_AVX512=off -DLLAMA_FMA=off -DLLAMA_F16C=off -DCMAKE_BUILD_TYPE=Release -DLLAMA_SERVER_VERBOSE=off -DLLAMA_HIPBLAS=on -DCMAKE_C_COMPILER=/opt/dtk/llvm/bin/clang -DCMAKE_CXX_COMPILER=/opt/dtk/llvm/bin/clang++ -DGGML_HIPBLAS=ON-DAMDGPU_TARGETS=gfx926 -DGPU_TARGETS=gfx926 echo "build step2..." for f in `ag xhip build -l` do sed -i 's/^\(C_FLAGS.*\) -xhip --cuda-gpu-arch=gfx926\(.*\)/\1 --gpu-max-threads-per-block=1024 \2/g' $f sed -i 's/^\(CXX_FLAGS.*\)/\1 --gpu-max-threads-per-block=1024/g' $f done cmake --build build --config Release -- -j 8 echo "build done..."
2024/11/27
W
wangs
1楼

z100对应的是gfx906; 按照您反馈的信息,只能只有CPU信息的话,应该是没有调用成功调用DCU卡;

目前 https://github.com/ggerganov/llama.cpp?tab=readme-ov-file#hipblas还没有做相关的适配
2024/11/22
W
wangs
回复 @wangs
llama.cpp 目前已经在DCU可用, 可以参考这里https://developer.sourcefind.cn/codes/OpenDAS/llama.cpp
2024/11/22
没有更多内容了
--
楼主
Level.1
0 帖子
楼主热帖
暂无数据

