0
0
0
0
Qwen3-ASR-1.7B成功部署攻略
2026-09-23 22:45:44
58
部署Qwen3-ASR-1.7B,需要手动修改docker 镜像内部文件
推荐使用镜像:`harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.18.1-ubuntu22.04-dtk26.04-py3.10`
1)模型下载:模型Qwen3-ASR-1.7B下载地址推荐魔方:https://modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
模型我下载到了:/hddata1/models/Qwen3-ASR-1.7B目录下
2)启用docker镜像qwen3-asr
docker run -it
--shm-size 20g
--network=host
--name qwen3-asr
--privileged
--device=/dev/kfd
--device=/dev/dri
--device=/dev/mkfd
--group-add video
--cap-add=SYS_PTRACE
--security-opt seccomp=unconfined
-u root
-v /opt/hyhal/:/opt/hyhal/:ro
-v /hddata/:/workspace/
harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.18.1-ubuntu22.04-dtk26.04-py3.10 bash
3)进入DOCKER ,(可以通过命令进入 docker exec -it qwen3-asr bash)
进入docker 对qwen3\_asr.py文件进行修改:
vim /usr/local/lib/python3.10/dist-packages/vllm/transformers\_utils/configs/qwen3\_asr.py
修改地方如下:
python
def __init__(
self,
thinker_config=None,
support_languages=None,
**kwargs,
):
if thinker_config is None:
thinker_config = {}
logger.info(
"thinker_config is None. Initializing thinker model with default values"
)
**self.thinker_config = Qwen3ASRThinkerConfig(**thinker_config)
super().__init__(**kwargs)
self.support_languages = support_languages**
保存修改好的文件。
4)下载vllm[audio]音频以来包和下载numpy稳定版本,这2个安装包很重要,
pip install "vllm[audio]"
下载nmpy稳定版
pip install numpy==1.26.4
5)启动vllm
export HIP_VISIBLE_DEVICES=1
export VLLM_USE_FUSED_RMS_ROPE=0
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=100
vllm serve /workspace/models/Qwen3-ASR-1.7B
--port 8020
--served-model-name qwen-asr-1.7b
--trust-remote-code
--tensor-parallel-size 1
--dtype bfloat16
--gpu-memory-utilization 0.15
--max-model-len 8192
--limit-mm-per-prompt '{"audio": 1}' > /workspace/vllm_qwen-asr.log 2>&1 &
6)查看是否成功运行:
tail -100f /workspace/vllm_qwen-asr.log
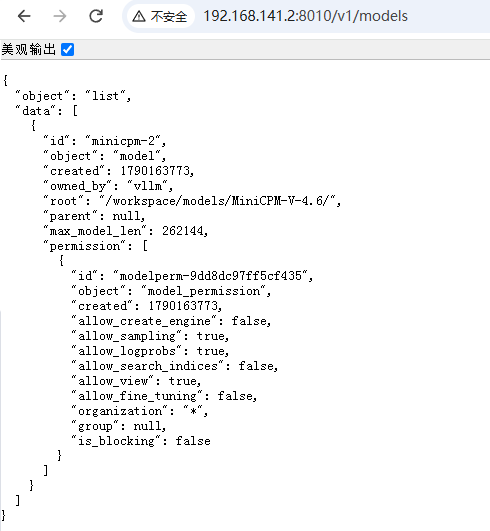
7)启动成功后查看模型:
curl http://127.0.0.1:8082/v1/models
8)启用测试任务:
curl -X POST "http://192.168.141.2:8020/v1/audio/transcriptions"
-F "file=@/hddata2/20260920_7618772130645573745.wav"
-F "model=qwen-asr-1.7b"
测试成功:

如有问题,请及时留言!
DCU达人计划
DCH
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据