3
2
2
0
海光破壁-从海光专属栈到通用 AI 模型栈的开荒,最新vllm,llama和任意模型
2026-05-03 17:32:23
840
适合显卡玩家、国产 GPU 折腾者、AI 智能体执行者阅读,测试卡z100l*4
0. 先说结论:这不是刷卡教程,而是“通用栈还原工程”
这篇文章讲的是一次 Z100L 显卡开荒:目标不是把卡伪装成 AMD,不是刷 VBIOS,也不是继续依赖海光私有 demo,而是尽量把它拉回到 PyTorch/HIP/vLLM/Transformers/FastAPI 这类更通用的开源模型运行方式。
最终结果可以概括为:在主机环境中,Z100L 已经不再只能跑海光 demo,而是可以作为一个通用 AI 模型服务节点使用,承载 LLM、ASR、TTS、多模型评测和 OpenAI-compatible API。
需要先把话说严谨:这里的“能运行任何模型”不是字面上的所有模型零修改运行。更准确的说法是:只要模型最终能落到 PyTorch/HIP、vLLM、Transformers、llama.cpp 或可替换的 CUDA 兼容路径上,就有系统化办法把它接入 Z100L;但强依赖 CUDA FlashAttention、特定 NVIDIA kernel 或训练反传数值路径的模型,仍然需要专项适配或暂时放弃。
1. 小白版背景:为什么 Z100L 一开始这么难用
普通玩家理解 GPU 加速,往往会想:装驱动、装 PyTorch、pip install vLLM,然后直接跑模型。但 Z100L 的现实不是这样。
· NVIDIA 的生态核心是 CUDA,绝大多数新模型、vLLM、FlashAttention、Triton kernel 都优先支持 CUDA。
· AMD 的生态核心是 ROCm/HIP,PyTorch 可以通过 HIP 版本把 torch.cuda 这一套 API 映射到底层 HIP 设备。
· 海光 DTK 很像 ROCm/HIP,但不是标准 ROCm 目录布局,核心 HIP 库叫 libgalaxyhip.so,而不是常规 ROCm 用户预期中的 libamdhip64.so。
· 很多开源框架默认找 /opt/rocm、标准 FindHIP、标准 hipBLASLt/Tensile 资产、标准 gfx 支持列表;Z100L 这些地方都可能卡住。
所以真正的工作不是“找一个神奇命令”,而是把每一层的接口对齐:硬件能算,HIP 能跑,PyTorch 能识别,vLLM 能发 kernel,模型服务能稳定暴露 API。
2. 机器和基础事实
| 项目 | 事实 |
| 系统 | Ubuntu 22.04.5 LTS,Linux 5.15 系列内核 |
| GPU | Z100L,gfx906,单卡 32GB,当前机器 4 卡约 128GB |
| CPU/内存 | 双路 E5-2667v3 级别平台,64GB 内存,SATA SSD,1GbE |
| DTK | /opt/dtk-26.04,软链 /opt/dtk -> /opt/dtk-26.04 |
| 关键库 | libgalaxyhip.so 是核心 HIP 实现,libamdhip64.so -> libgalaxyhip.so |
| 基础 smoke | hipMalloc、hipMemcpy、kernel launch、hipBLAS SGEMM、Python ctypes 调 hipGetDeviceCount 均已通过 |
| 当前服务 | ASR Lab 18200,TTS CosyVoice2 18400,均不设置开机自启 |
3. 总体架构图
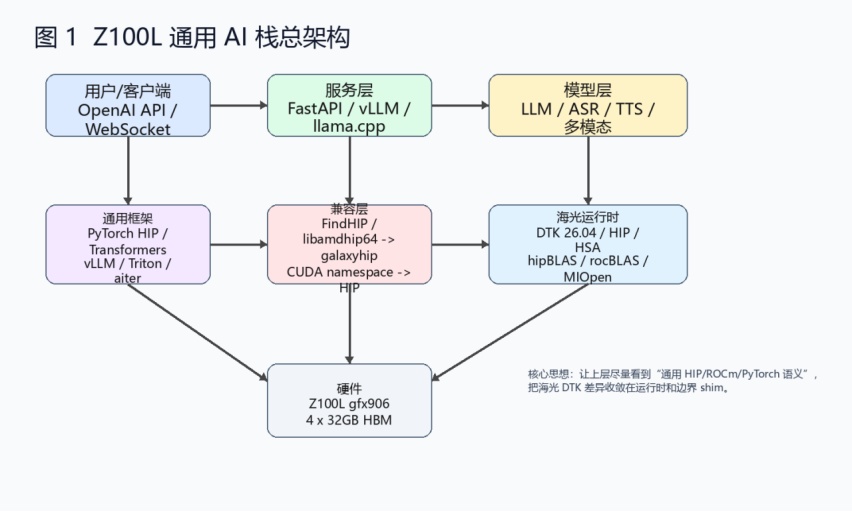
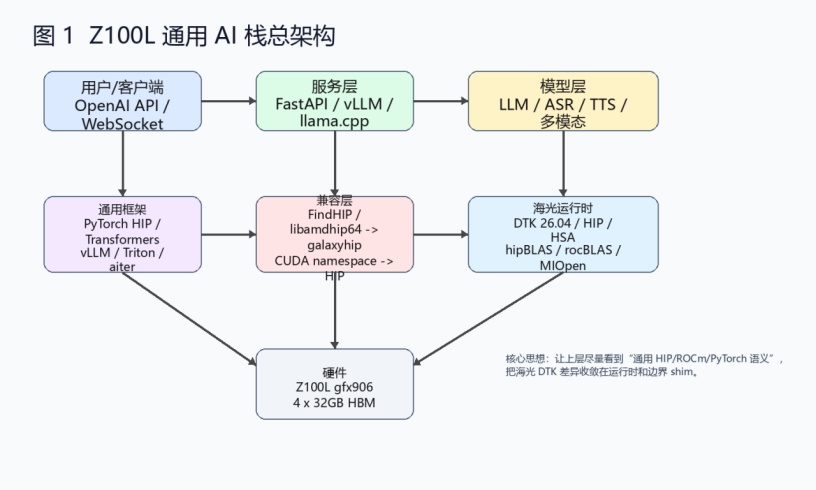
这张图的核心是分层:越靠上越通用,越靠下越接近海光硬件。适配时不要到处乱改,而要尽量把海光差异收敛在“运行时路径”和“兼容层”。
4. 从私有栈到通用栈:完整开荒路线
4.1 第一阶段:别急着编译,先证明 GPU 真的能算
最开始的关键判断是:不能把旧的 PyTorch 脏树、旧 build 产物、CPU-only torch、海光 demo 输出当成成功。必须先用最小程序证明通用 HIP 计算链路是真的。
| 验证项 | 为什么重要 | 结果 |
| hipGetDeviceCount | 确认运行时能发现 Z100L | 通过 |
| hipMalloc / hipMemcpy | 确认显存分配和主机设备拷贝可用 | 通过 |
| kernel launch + sync | 确认能发自定义 GPU kernel | 通过 |
| hipBLAS SGEMM | 确认基础矩阵乘法库可用 | 通过,C=[19 22; 43 50] |
| Python ctypes 加载 libamdhip64.so | 确认 Python 层能直接触达 HIP runtime | 通过 |
这个阶段的意义很大:它把问题从“这卡能不能用”缩小成“上层框架如何适配”。
4.2 第二阶段:抛弃脏树,重建干净 PyTorch/HIP 基线
旧的 PyTorch 源码树污染很重:大量 M/D/??,.gitmodules 被删过,sparse checkout,浅克隆,还有坏掉的 cuda.cmake 补丁。继续在这棵树上盲编只会越修越乱。
· 正确做法:重新 clone 干净 PyTorch v2.9.1 树。
· 先做零补丁 configure,找出真实失败点。
· 只迁移最小必要补丁:FindHIP/CMake 边界 shim,少量 allocator API 兼容。
· 不要把旧树里不明来源的 aten/hip 文件和坏 cuda.cmake 补丁整包搬过去。
这一步的目标不是“海光特化”,而是让 DTK 尽量表现得像标准 ROCm/HIP 环境。
4.3 第三阶段:vLLM、Triton、aiter 和 gfx906
大模型推理最麻烦的是 vLLM 这一层。vLLM 不只是 Python,它里面有调度、KV cache、attention kernel、Triton kernel、采样逻辑、分布式逻辑。Z100L 的 gfx906 不在很多默认优化路径的舒适区。
| 问题 | 处理方向 | 经验 |
| gfx906 不在主流默认优化路径 | 补 Triton/ROCm/gfx906 支持,必要时使用 correctness-first fallback | 先保证正确,再看速度 |
| prefill fallback 慢 | 早期走了会物化大 attention 中间结果的慢路径 | 主路径可用后速度改善,但仍受 kernel 资产和硬件限制 |
| hipBLASLt/Tensile 资产缺失 | 检查 gfx906 对应库资产,不存在就回退或避开 | 这是 DTK/库资产问题,不是模型问题 |
| CUDA-only 代码 | 用 PyTorch HIP 的 torch.cuda 语义、SDPA fallback、CPU sampling 等方式替代 | 不是刷卡,也不是伪装 PCI Vendor |
| Docker 内 vLLM 崩溃 | 主机可用,容器内 GPU 分配路径仍有问题 | Docker 包可复现环境,但不是最终生产运行主线 |
4.4 第四阶段:跑通 Gemma 4 26B 4bit 和服务化
在主机运行时上,Z100L 已经能承载 Gemma 4 26B AWQ 4bit 这类大模型服务。围绕它做过上下文上限、token 速度、多卡利用率、锁频、DFlash、llama.cpp/GGUF 等方向测试。
一个重要结论是:在 Z100L 这类 PCIe 3.0 多卡机器上,不是所有多卡并行都会变快。短请求、多卡 tensor parallel 可能被通信和调度拖慢。更实用的策略是:能单卡放下就单卡,放不下再多卡;多模型服务则倾向每个 worker 固定一张 GPU。
Docker 方向也做了打包:镜像内包含 patched PyTorch、patched vLLM、triton-rocm、aiter 和模型文件。但当前文档里的结论是:主机 vLLM 可用,Docker 内完整 vLLM 推理仍受容器侧 GPU allocation 问题影响,所以 Docker 更适合作为环境归档,不应被宣传成最终无脑部署包。
4.5 第五阶段:从 LLM 扩展到 ASR/TTS/多模型服务
后来工作重心扩展到语音输入法和模型评测。这里不再只是“跑一个模型”,而是把 Z100L 变成模型服务器。
| 服务/模型 | 端口/状态 | 结论 |
| ASR Lab | 18200 | 统一 HTTP API,默认只暴露 fun_asr_nano_2512 与 vibevoice_asr_hf,其他模型按 active/experimental/debug_only 区分 |
| Qwen3-ASR-1.7B | 实验候选 | AISHELL-1 1000 条 CER 约 2.42%,p50 latency 约 718ms,但异常输入 false transcription 和 prompt leakage 有硬伤,不能直接 final selected |
| VibeVoice-ASR-HF | recheck / long_audio / finetune_base | AISHELL CER 约 7.44%,p50 latency 约 2886ms,不适合短句默认,但领域词 hotword hit rate 高,异常输入安全性好 |
| Fun-ASR-Nano | fallback baseline | 稳定但延迟和长期底座价值有限 |
| FireRedASR2-LLM | disabled | 持续输出 #,默认链路移除 |
| CosyVoice2 TTS | 18400 | 用于生成测试语音,GPU matmul 保留,采样路径做 CPU fallback 规避 Z100L/gfx906 VMFault |
5. CUDA-only 模型到底怎么在 Z100L 上跑
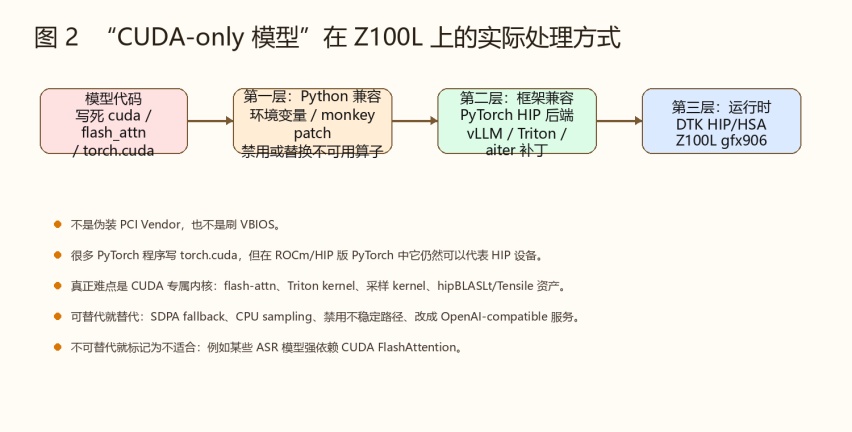
这里最容易误解。所谓“CUDA 转换”不是把 Z100L 变成 NVIDIA,也不是让 CUDA driver 真跑在海光卡上。实际做法是分三类:
1. 框架层名字兼容:很多 PyTorch ROCm/HIP 版本依然使用 torch.cuda 这个 Python namespace,模型代码写 cuda 并不一定等于必须有 NVIDIA。
2. 算子层替代:如果模型调用 flash_attn、CUDA Triton kernel、GPU sampling kernel,就用 SDPA、Triton ROCm、CPU sampling 或禁用不稳定路径来替代。
3. 不可替代则放弃:例如 Kimi-Audio 7B 在 Z100L 上能加载,但官方强依赖 CUDA FlashAttention,SDPA shim 下输出重复标点,这种不能包装成成功。
| CUDA/ROCm/HIP 概念 | 小白解释 | Z100L 适配方式 |
| CUDA | NVIDIA 的 GPU 编程生态 | 不能原生运行,只能通过上层兼容或替代路径 |
| HIP | AMD/ROCm 风格的 GPU 编程接口 | Z100L 通过 DTK/HIP 跑这一层 |
| torch.cuda | PyTorch 中历史遗留的 GPU API 名字 | 在 HIP 版 PyTorch 中也可能代表 HIP GPU |
| FlashAttention | 高性能 attention CUDA kernel | Z100L 上通常要找 ROCm/Triton 替代或用 SDPA fallback |
| Triton | 模型推理常用 kernel 编译器 | 需要补 gfx906/ROCm 路径,不能默认假设 NVIDIA |
6. 主要替换了海光哪些东西
准确说,不是把海光 DTK 全部替换掉,而是把“必须依赖海光私有 demo”的部分替换成更通用的开源框架入口。
| 原来容易依赖的东西 | 现在更通用的替代 | 说明 |
| 海光私有 demo | HIP smoke + PyTorch HIP + vLLM/Transformers 服务 | demo 只能证明样例,不能证明通用模型栈 |
| /opt/rocm 假设 | /opt/dtk-26.04 + ROCM_SOURCE_DIR/HIP_PATH/LD_LIBRARY_PATH | 让构建系统找到真实 DTK |
| 标准 libamdhip64.so 假设 | libamdhip64.so -> libgalaxyhip.so | 让上层按 AMD HIP 名字加载海光 HIP 实现 |
| vLLM 默认 CUDA/新卡路径 | patched vLLM + Triton/ROCm/gfx906 兼容 | 按真实失败点修,不做全局伪装 |
| GPU 采样/softmax 不稳定路径 | CPU fallback 或禁用不稳定路径 | CosyVoice2、VibeVoice 训练诊断中都体现了这个原则 |
| 模型散落脚本 | FastAPI/OpenAI-compatible 统一服务 | 客户端不需要理解底层 GPU 细节 |
7. 哪些事情已经可以做,哪些还不能吹
| 能力 | 当前判断 | 备注 |
| HIP 基础计算 | 可用 | runtime、kernel、hipBLAS、Python ctypes 均验证过 |
| PyTorch/HIP 语义 | 可用但需要维护补丁 | 核心是干净树和最小 shim |
| 主机 vLLM 大模型推理 | 可用 | Gemma 4 26B 4bit 等已经跑通过 |
| Docker 完整 vLLM 推理 | 不建议吹成完成 | 镜像可打包,但容器侧 GPU allocation 仍有阻塞 |
| ASR 服务化 | 可用 | 18200 已有统一 API,多模型状态管理 |
| TTS 服务化 | 可用 | 18400 CosyVoice2,注意采样 fallback |
| VibeVoice LoRA 在 Z100L 训练 | 暂停 | forward 有限但 backward/optimizer 后 non-finite/NaN,进一步 sweep 不安全 |
| 所有 CUDA-only 模型无脑运行 | 不成立 | 强依赖 CUDA FlashAttention 的模型仍可能失败 |
8. 迁移到其他海光卡应该怎么做
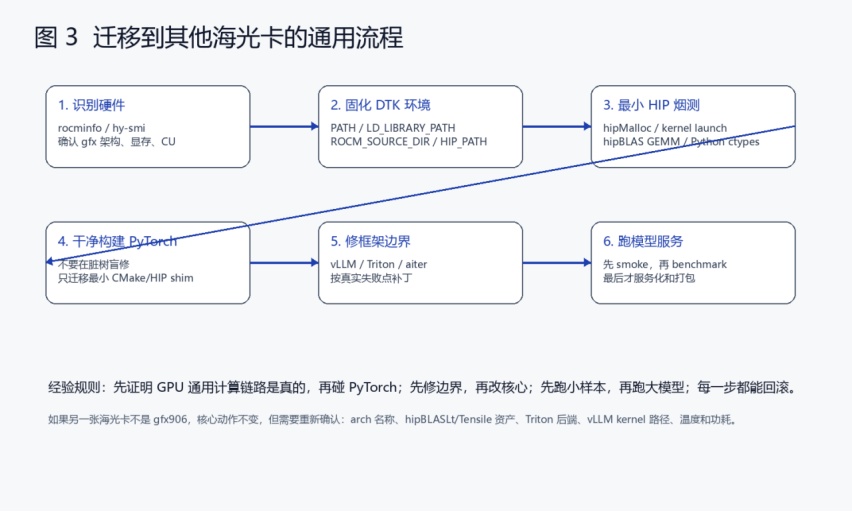
Z100L 的经验可以迁移到其他海光卡,但不能直接复制文件。不同卡可能是不同 gfx 架构、不同 DTK 版本、不同库资产。应该迁移“方法”,不是迁移“补丁包”。
8.1 通用迁移清单
· 确认硬件:hy-smi、rocminfo、lspci,记录 Device ID、gfx 架构、显存、CU、温度功耗。
· 固化环境:写一个 env 脚本,统一 ROCM_SOURCE_DIR、HIP_PATH、ROCM_PATH、PATH、LD_LIBRARY_PATH。
· 跑最小 HIP:hipGetDeviceCount、hipMalloc、hipMemcpy、kernel launch、hipBLAS GEMM。
· 建立干净 PyTorch 树:不要在脏树上盲修;先零补丁 configure,再看真实失败点。
· 只做边界补丁:FindHIP、库名映射、路径发现、少量 API shim;不要大面积改核心源码。
· 再碰 vLLM/Triton:先跑最小模型,确认 attention、sampling、KV cache、并发策略。
· 最后才跑大模型:从 1B/7B 到 26B/31B,不要一上来跑 100GB 模型。
· 服务化隔离:实验端口和生产端口分开,debug 模型不要进默认 /models。
· 写报告:每个失败都记录原始报错、根因判断、是否可回滚。
8.2 其他海光卡最可能遇到的差异
| 差异点 | 检查方式 | 处理方式 |
| gfx 架构不同 | rocminfo 看 Name: gfxxxx | Triton/aiter/vLLM kernel 支持要重测 |
| DTK 版本不同 | hipcc --version、库目录 | 不要混用旧补丁,重新做 configure |
| hipBLASLt/Tensile 资产不同 | find DTK library/*gfx*co | 缺失就回退或避开对应 kernel |
| 显存不同 | hy-smi / torch memory | 重新定 max_model_len、gpu_memory_utilization、TP |
| 温度散热不同 | 长期压测时监控温度 | 超过 88°C 降载,超过 90°C 停止长跑 |
| 训练路径不同 | 先 one-step smoke | 不要用推理成功推断训练稳定 |
9. 可以直接发给 AI 智能体的短提示词
下面这段可以给其他显卡爱好者直接复制给他的 AI 智能体。它不能保证一键成功,但能让智能体按正确路线排查。
你现在接管一台海光 GPU 机器,目标是把它尽量拉回通用 PyTorch/HIP/vLLM/Transformers 技术路线,不要刷 VBIOS,不要伪装 PCI Vendor,不要依赖厂商 demo。先做现场审计:系统、DTK、hipcc、rocminfo、libamdhip64/libgalaxyhip、GPU gfx 架构、显存和温度。然后固化 DTK 环境脚本,跑最小 HIP runtime、hipBLAS GEMM、Python ctypes smoke。不要在脏源码树上盲编,重新 clone 干净 PyTorch,先零补丁 configure,再只做最小 FindHIP/CMake/API shim。PyTorch/HIP 成立后再适配 vLLM/Triton/aiter,先小模型 smoke,再大模型。遇到 CUDA-only 模型,优先用 PyTorch HIP 的 torch.cuda 语义、SDPA fallback、CPU sampling 或禁用不稳定 kernel,不要假装 CUDA 原生可用。所有实验服务和生产服务端口隔离,每一步输出原始报错、根因、补丁范围、可回滚方案和性能数据。
10. 给小白的实操心法
· 不要相信“装完驱动就能跑所有模型”。国产 GPU 的主要工作在框架边界和 kernel 路径。
· 不要把 CPU-only 当成功。一定要看到 GPU 显存占用、GPU kernel、hipBLAS 或 vLLM 实际推理。
· 不要把一次 import torch 成功当成功。模型生成、长上下文、异常输入、并发、重启恢复都要测。
· 不要盲目追最新版。Z100L 上某些包版本组合是工作资产,随便升级可能破坏 torch/vLLM/transformers。
· 不要把 fallback 当最终优化。fallback 是用来先保证正确,后面还要找主路径或承认性能边界。
· 不要把训练和推理混为一谈。Z100L 推理可用不代表 LoRA 训练稳定。
11. 常见问题 FAQ
Q1:是不是不用海光 DTK 了?
不是。当前底层仍依赖海光驱动和 DTK。我们替换的是上层私有 demo 路线,把模型运行入口尽量变成 PyTorch/HIP/vLLM/Transformers。
Q2:能不能直接用 AMD ROCm?
不能简单假设。Z100L 的 DTK 和标准 ROCm 布局不同,驱动、库资产、设备 ID、gfx 支持都要验证。以后也许某些卡能更接近 ROCm,但本项目不是靠替换系统驱动完成。
Q3:为什么很多代码里还是 torch.cuda?
因为 PyTorch 的 HIP/ROCm 版本历史上也复用 torch.cuda 这个 Python API 名字。代码写 cuda 不等于底层一定是 NVIDIA。
Q4:为什么 VibeVoice 不做默认短句 ASR?
它领域词和异常输入安全性强,但短句延迟和 AISHELL CER 不如更轻的候选;适合 recheck、long_audio、finetune_base,不适合默认每句话调用。
Q5:为什么不继续在 Z100L 上训练 LoRA?
诊断显示 forward loss 有限,但 backward 后 gradient non-finite,optimizer.step 后 adapter 权重 NaN/Inf,继续 sweep 风险大。
Q6:其他海光卡照搬这套能成吗?
不能照搬,但路线可复用:先硬件和 HIP smoke,再干净 PyTorch,再 vLLM/Triton,再模型服务。不同 gfx 和 DTK 版本要重测。
12. 附录:关键路径和命令示例
| 用途 | 路径/命令 |
| DTK 环境脚本 | /home/muyi/envs/dtk26-z100l.sh |
| PyTorch GPU venv | /home/muyi/venvs/torch-gpu-z100l |
| PyTorch 干净源码 | /home/muyi/src/pytorch-clean-v291 |
| vLLM 源码 | /home/muyi/src/vllm |
| ASR Lab 服务 | http://192.168.147.248:18200 |
| TTS 服务 | http://192.168.147.248:18400 |
| Gemma Docker 资料 | D:\code\Z100L\docker\z100l-gemma4\README.md |
| ASR 交接报告 | /home/muyi/asr_lab/bench/results/z100l_to_voice_client_handoff_v1.zip |
source /home/muyi/envs/dtk26-z100l.sh
source /home/muyi/venvs/torch-gpu-z100l/bin/activate
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.device_count())"
curl http://192.168.147.248:18200/health
curl http://192.168.147.248:18400/health
13. 最后总结
Z100L 的这次开荒,真正有价值的不是某一个补丁,而是一条可复用的方法论:把国产 GPU 先拉到通用 HIP 语义,再把 PyTorch、vLLM、Transformers、Triton、服务 API 一层一层接上。能进通用栈的模型就服务化,不能进通用栈的模型就明确标记风险,不把失败包装成成功。
如果后续换成其他海光卡,最应该复制的是这套排查和分层方法,而不是直接复制某个补丁目录。
vllm,llama,任意模型
全部评论(2)
只看楼主
M
8/11
Z
膜拜
5/7
没有更多内容了
--
楼主
0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据