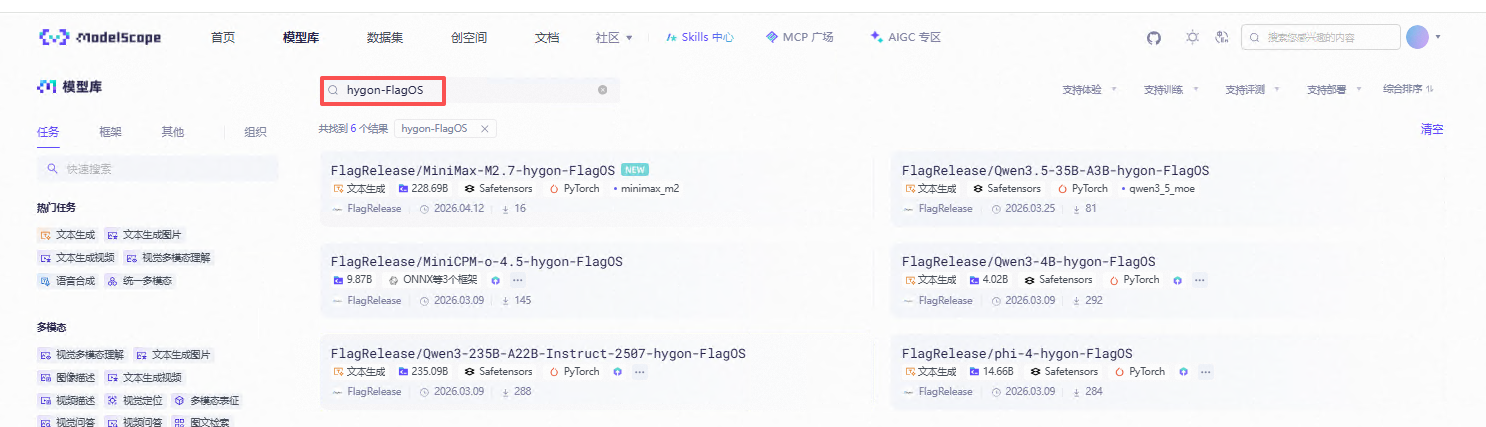
近期尝试使用flagos,发现推理效率相较海光自有的vllm0.11.0提升3倍多。命令如下:
```language
docker run \
--name flagos-minimax \
--network=host \
--ipc=host \
--device=/dev/kfd \
--device=/dev/mkfd \
--device=/dev/dri \
-v /opt/hyhal:/opt/hyhal \
-v /{path_to}/workspace:/workspace \
-v /{path_to}/models:/models \
--group-add video \
--cap-add=SYS_PTRACE \
--security-opt seccomp=unconfined \
-itd \
harbor.baai.ac.cn/flagrelease-public/flagrelease-hygon-minimax:202604120035 \
/bin/bash -c '
HIP_VISIBLE_DEVICES="2,3,4,5" \
OMP_NUM_THREADS=32 \
NCCL_MIN_NCHANNELS=16 \
NCCL_MAX_NCHANNELS=16 \
VLLM_V1_FAST_TOKEN_ID_COPY=1 \
NCCL_P2P_LEVEL=LOC \
HSA_FORCE_FINE_GRAIN_PCIE=1 \
HIP_PERF=1 \
SAFETENSORS_FAST_GPU=1 \
vllm serve /models/QuantTrio/MiniMax-M2.5-AWQ \
--trust-remote-code \
--served-model-name minimax-m2.5 \
--max-model-len 196608 \
--max-num-batched-tokens 32768 \
--dtype bfloat16 \
--gpu_memory_utilization 0.90 \
--max-num-seqs 10 \
--tensor-parallel-size 4 \
--port 8000 \
--enable-auto-tool-choice \
--tool-call-parser minimax_m2 \
--reasoning-parser minimax_m2 \
--disable-custom-all-reduce
'
```

 ,我也去实验一下。

 暂无数据