0
4
0
0
k100-ai 4卡机部署qwen延迟问题
2026-07-02 19:52:28
321
求教,手上有一台4卡的k100-ai,在部署qwen3.6-a35b,看了官方的教程和社区的帖子,大家似乎都没有这个情况,也添加过海光那些特有的环境变量,但都没用。
这个问题是,单卡推理的时候的速度不错,30token/s,但tp=2的时候,就10秒一个token,无法接受的慢,他也不报错,我感觉是卡间延迟非常大,这个怎么解决呢。
就这问题也不是模型问题,因为我换了qwen3-30b-2507,换过qwen3-32b,都慢。换过各个版本的镜像,通用的,定制的,老的新的,都慢。但单卡就正常。然后手上还有个8卡k100-ai,也都正常不需要搞这么复杂。
vllm日志里有时候经常出现一个No available shared memory broadcast block found in 60 seconds. This typically happens some processes are hanging or doing some time-consuming work. 和这个有关吗?
更新情况:
已知和镜像/模型等没关系。
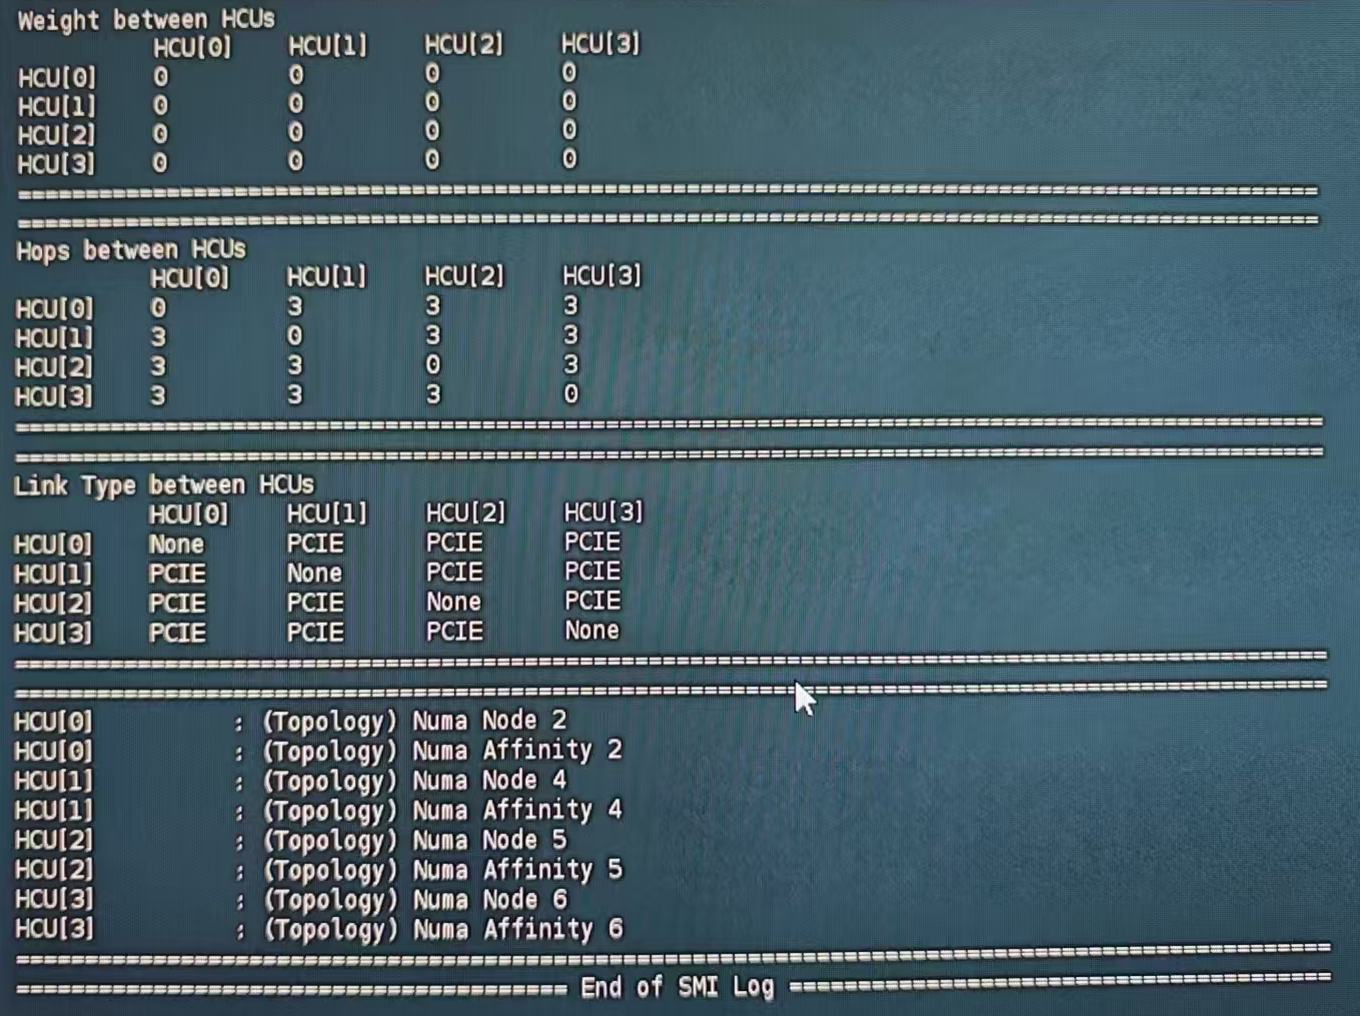
正常的8卡K100_AI服务器,双cpu,拓扑信息是4张卡对应一个物理CPU的Numa3,另外4张卡对应4张卡对应另外一个物理CPU的Numa7。一组卡间的Hops为2,组与组之间为3。表现为有时候4卡跑反而比8卡跑更快一些。
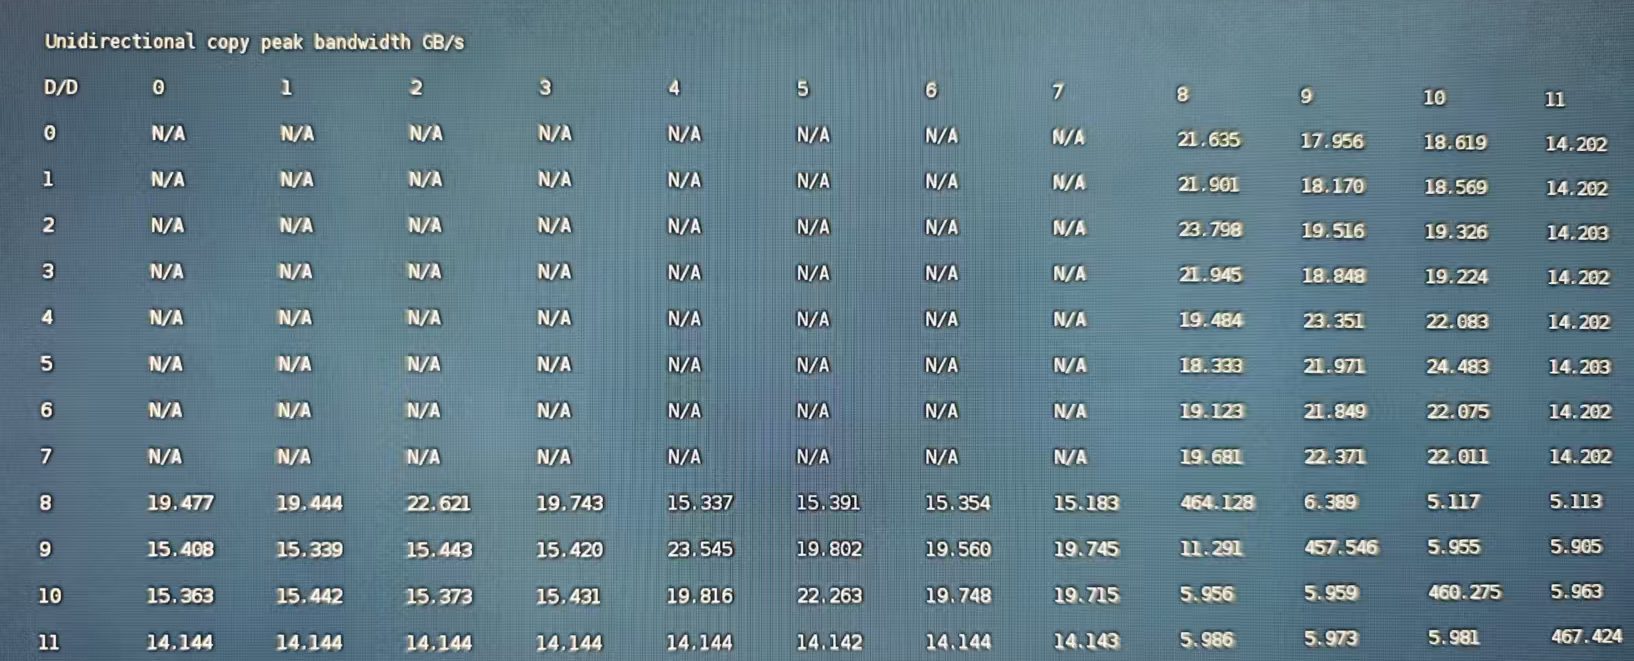
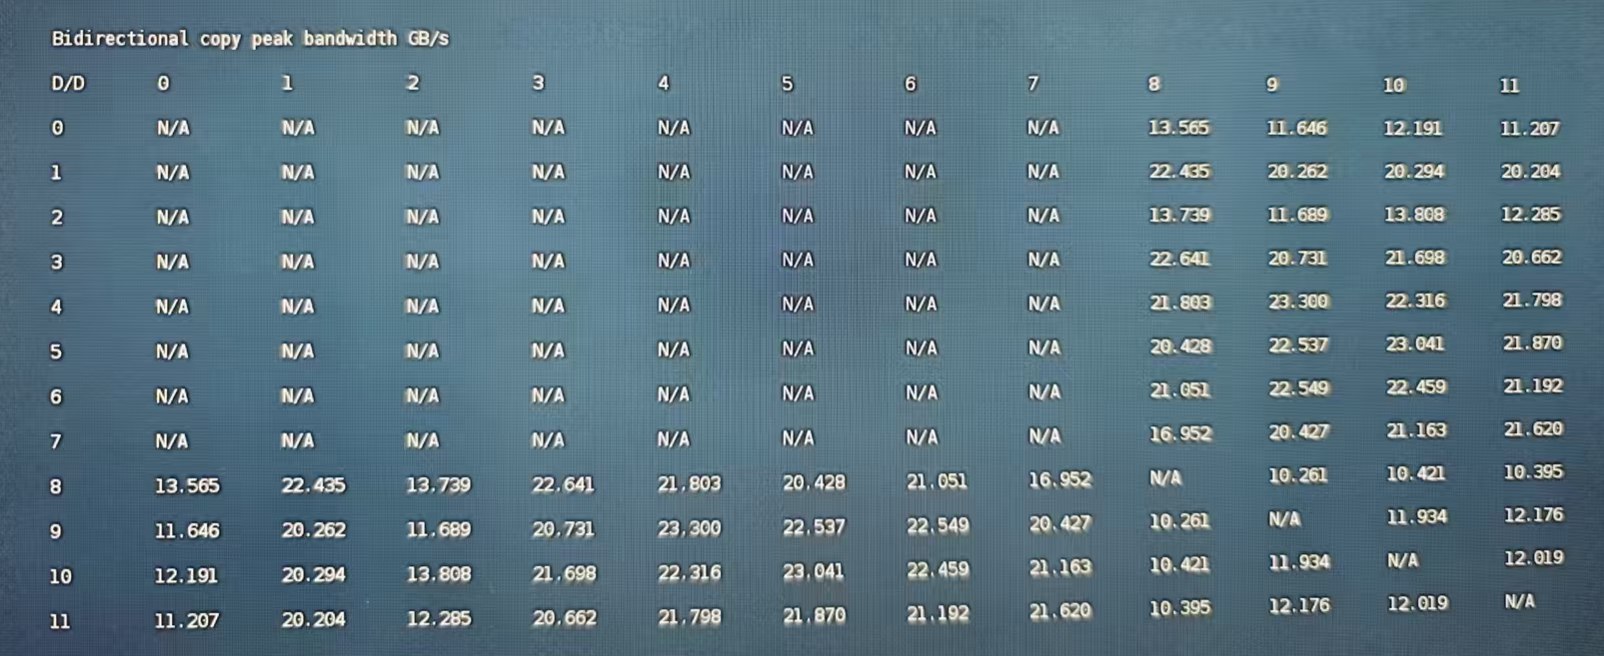
而那个4卡K100_AI服务器,单CPU被拆分成4个Numa,4张卡分别对应Numa2,4,5,6,导致卡和卡之间Hops为3。此外有个rocm-bandwidth-test的带宽测试,结果也很低。是不是这个Numa的问题呢?如果是应该怎么解决?
docker-compose.yaml如下:
services:
  qwen-service:
    image: harbor.sourcefind.cn:5443/dcu/admin/base/custom:vllm018-ubuntu22.04-dtk26.04-qwen3.6-20260423
    container_name: qwen3.6-35b
    privileged: true
    user: "root"
    shm_size: '256gb'
    restart: on-failure

    ports:
      - "8001:8001"

    ipc: host


    environment:
      - HIP_VISIBLE_DEVICES=2,3
      #- PYTHONWARNINGS=ignore
      #- VLLM_HCU_USE_CUSTOM_QUANTIZATION_GEMM=0
      #- VLLM_HCU_USE_CUSTOM_OPS=0
      #- VLLM_NUMA_BIND=1
      #- VLLM_RANK0_NUMA=5         对应 2 号卡的 NUMA 5
      #- VLLM_RANK1_NUMA=6         对应 3 号卡的 NUMA 6,这些写过没啥用
      #- HSA_FORCE_FINE_GRAIN_PCIE=1
      #- NCCL_P2P_LEVEL=SYS
      #- NCCL_LAUNCH_MODE=GROUP
      #- NCCL_MIN_NCHANNELS=8
      #- NCCL_MAX_NCHANNELS=8
      #- NCCL_DEBUG=INFO


    devices:
      - /dev/kfd:/dev/kfd
      - /dev/dri:/dev/dri
      - /dev/mkfd:/dev/mkfd

    cap_add:
      - SYS_PTRACE
    security_opt:
      - seccomp=unconfined
    group_add:
      - video
    volumes:
      - ./qwen3.6-35b/model:/model:ro
      - /opt/hyhal/:/opt/hyhal/:ro


    command: vllm serve /model \
          --port 8001 \
          --served-model-name atom \
          --api-key xxx \
          --gpu-memory-utilization 0.90 \
          --tensor-parallel-size 2 \
          --max-model-len 65536 \
          --enable-prefix-caching \
          --enable-auto-tool-choice \
          --tool-call-parser qwen3_coder \
          --reasoning-parser qwen3
qwen3.6-27b
K100-ai
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据
Ubuntu 22.04
内核 6.8.0-57-generic
驱动:rock-6.3.30-V1.4.1a.run
2 张 K100AI
新增了一张卡测试双卡推理,跑不通了的说。
求解,跟内核有关?
大家内核都是跟官方文档一个版本吗?