试一下vllm011的镜像吧
0
3
0
0
Qwen3-32B用8张K100AI卡,token输出速度只能在30tokens/s
2026-04-12 10:22:50
374
启动命令(基于docker)
vllm serve /model
--host 0.0.0.0
--port 30003
--tensor-parallel-size 8
--served-model-name Qwen/Qwen3-32B
--gpu-memory-utilization 0.85
--max-model-len 40960
--max-num-seqs 32
--max-num-batched-tokens 16384
--block-size 32
--trust-remote-code
请求相关信息
特点:输入的prompt比较大
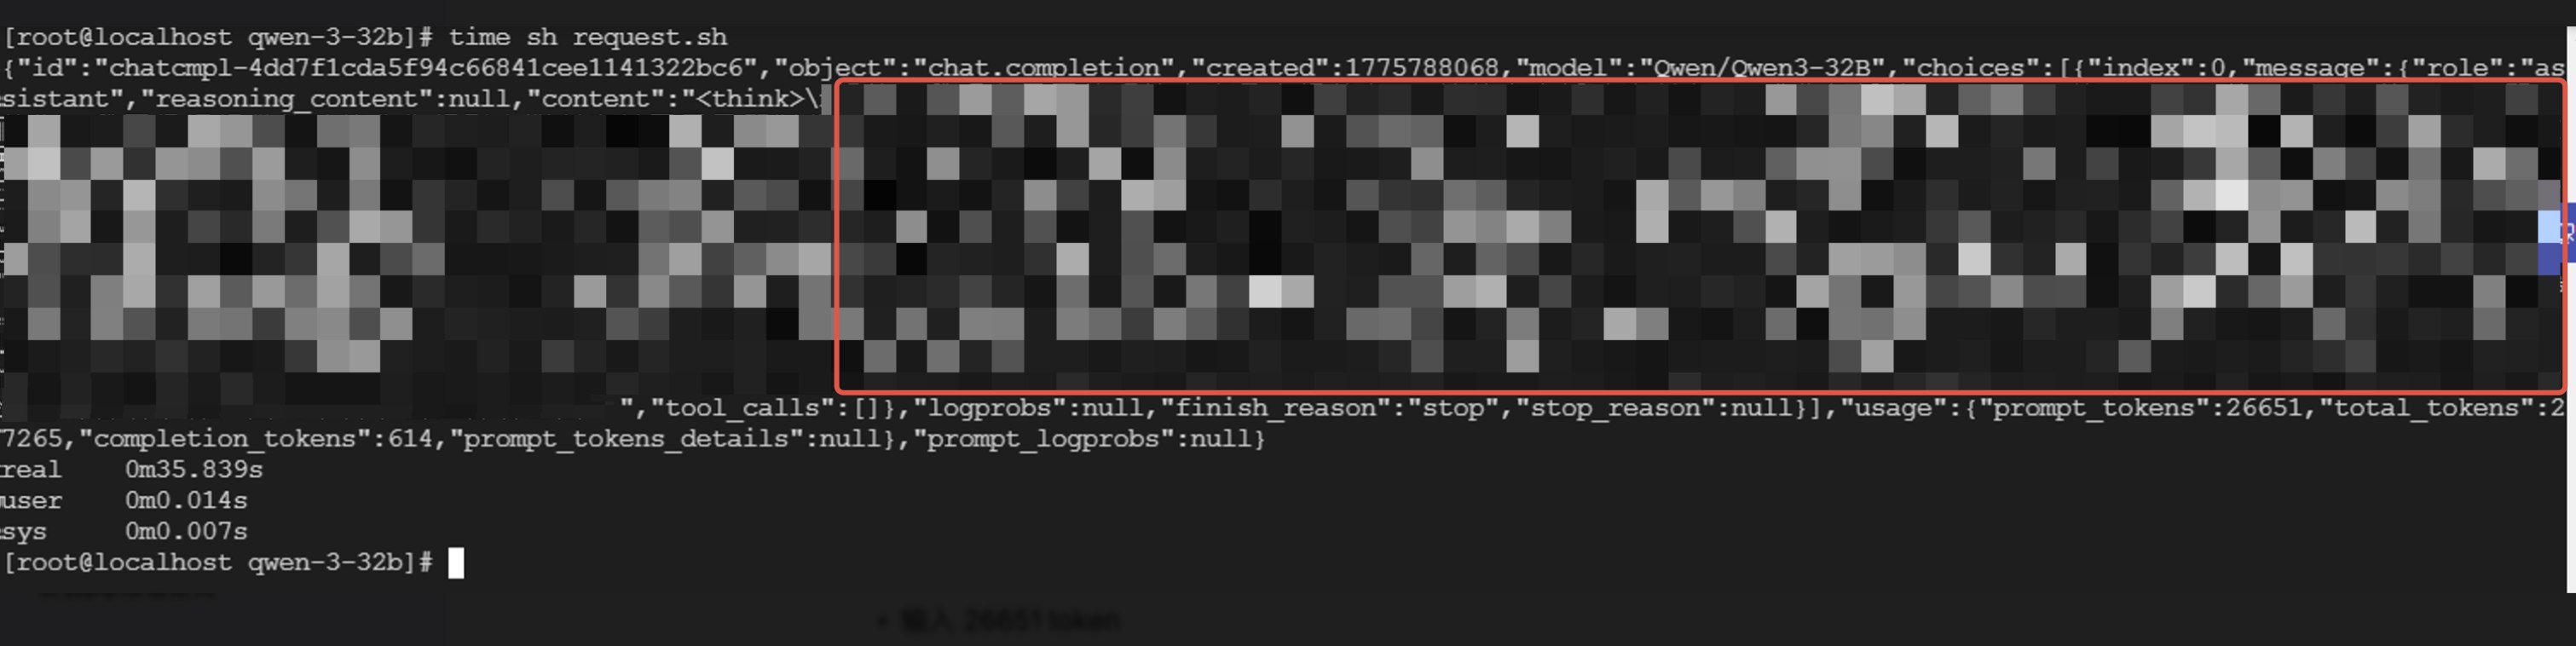
token 输出
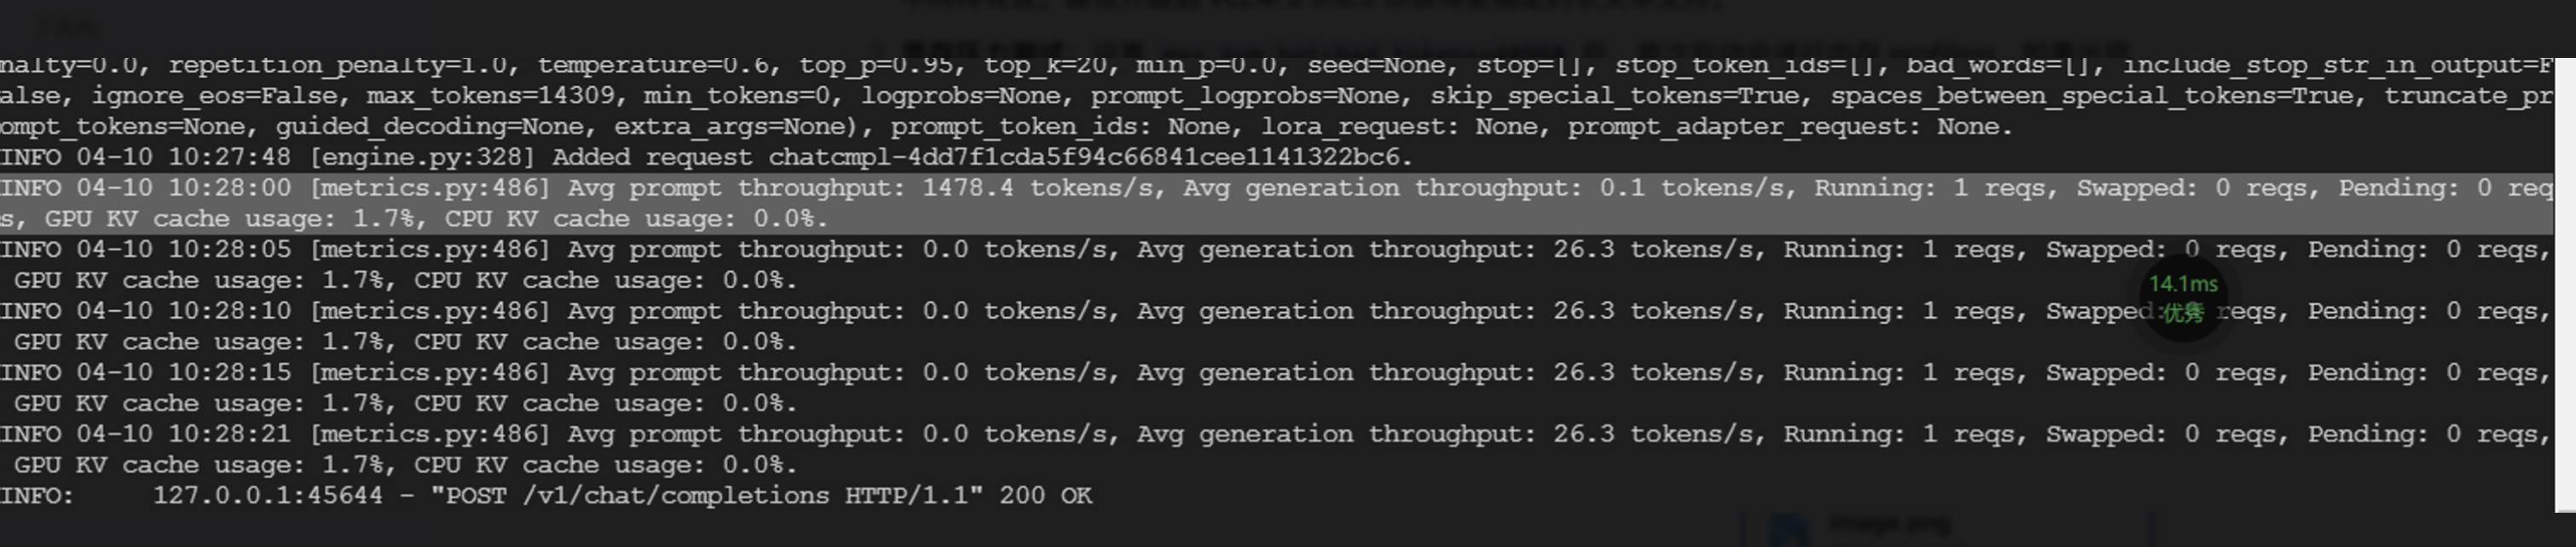
问题:如何能够让我当前请求响应速度提高?
目前看耗时应该主要在 Avg generation throuthput这块的token生成慢,所以是否有参数能够调整
========20260413补充说明==========
1、当前docker镜像:harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.8.5-ubuntu22.04-dtk25.04.1-py3.10
2、尝试开启enable-prefix-caching发现效果更不理想
========20260413补充说明==========
Qwen3.5-27B
Z100L
全部评论(12)
只看楼主
Z
4/13
靳
相似帖子:
1、K100AI Qwen3-14B 16.6 tokens/s 这个性能对么,大佬帮看看(https://forum.sourcefind.cn/thread/a52d42c7-3313-11f1-be6e-0242ac150003)
2、k100用vllm部署qwen3速度太慢,有10token/s(https://forum.sourcefind.cn/thread/b71f79b2-31a6-11f1-b5ad-0242ac150003)
3、Qwen3.5 K100-AI使用问题(https://forum.sourcefind.cn/thread/c74bace2-2859-11f1-8e83-0242ac150003)
4、推理性能测试对比(https://forum.sourcefind.cn/thread/a9ac4d13-160c-11f1-a49f-0242ac150003)
5、使用2张K100_AI部署Qwen3-32B模型,单并发及多并发的情况下,性能大概能达到多少token/s?有没有相关的测试报告分享下,非常感谢!(https://forum.sourcefind.cn/thread/a3a6e4cc-fa62-11f0-a195-0242ac150003)
4/13
K
官方能否出来说明一下,是不是这种8卡K100AI 服务器也就是这样水平,如果是的话大家也不用不瞎折腾了。
4/12
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据