0
1
0
0
DeepSeek-R1_ollama模型部署教程
2025-02-18 17:56:22
2601
DeepSeek-R1_ollama
部署视频见学习路径内页 – 光合开发者社区 ollama部署deepseek
资源说明
该项目包含多个模型,所需的资源8卡*64G。硬件资源为K100-AI.
获取项目代码
git clone -b 0.5.7 http://developer.sourcefind.cn/codes/OpenDAS/ollama.git
环境准备
1、获取docker镜像
docker pull image.sourcefind.cn:5000/dcu/admin/base/pytorch:2.3.0-py3.10-dtk24.04.3-ubuntu20.04
2、创建并运行docker容器
docker run --shm-size 500g --network=host --name=Janus_Pro --privileged --device=/dev/kfd --device=/dev/dri --group-add video --cap-add=SYS_PTRACE --security-opt seccomp=unconfined -v <获取的项目代码地址>:/home/ -v /opt/hyhal:/opt/hyhal:ro -it <上一步获取的docker镜像ID> bash
注意: 可以使用 docker images 获取相应的镜像ID。
3、安装环境依赖
cd ollama

*编译
wget https://go.dev/dl/go1.23.4.linux-amd64.tar.gz
tar -C /usr/local -xzf go1.23.4.linux-amd64.tar.gz
export PATH=$PATH:/usr/local/go/bin

*修改go下载源,提升速度(按需设置)
go env -w GOPROXY=https://goproxy.cn,direct

*运行编译
export LIBRARY_PATH=/opt/dtk/lib:$LIBRARY_PATH
make -j 32
go build .
运行
启用服务端
rocminfo |grep gfx #查询当前机器的gfx参数,确定设备型号
export HSA_OVERRIDE_GFX_VERSION=设备型号(使用上一行命令的输出结果进行声明,通常来说Z100L gfx906对应9.0.6;K100 gfx926对应9.2.6;K100AI gfx928对应9.2.8,具体设备型号以当前机器的rocminfo | grep gfx的结果为准)
export ROCR_VISIBLE_DEVICES=所有设备号(0,1,2,3,4,5,6,...)/选择设备号
./ollama serve
启用chat端
注意:新建终端,进入容器
cd  ollama
./ollama run deepseek-r1:671b
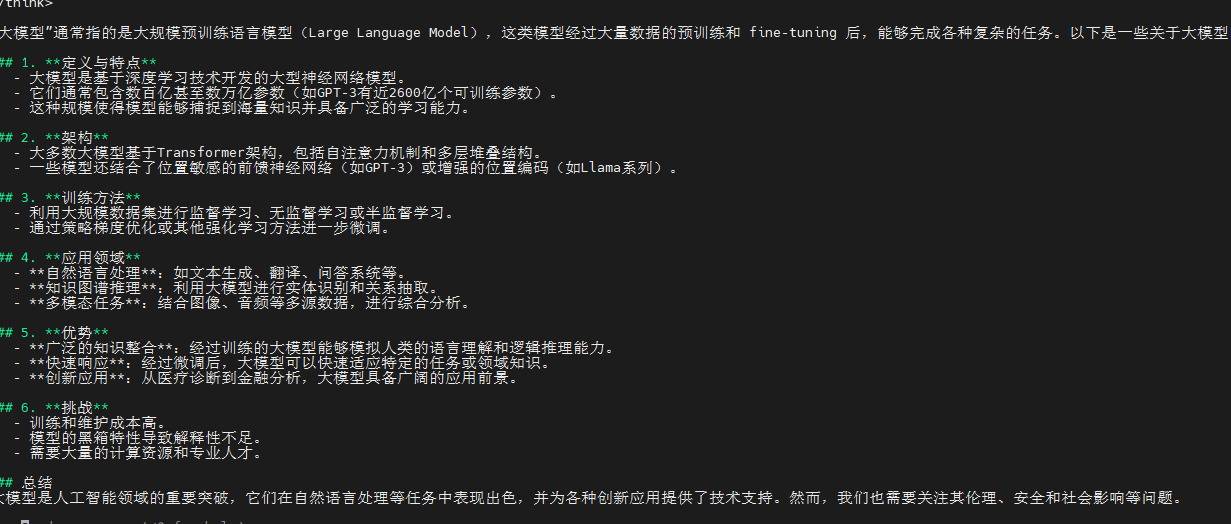
运行效果
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据
现在有个问题。就是ollama serve的进程一直在。然后当使用对话的时候,第一句对话的回复,特别慢。后面就正常了。
经排查发现,是第一句对话,触发ollamaserve,启动了这么一个ollama_llama_serve的进程,进行推理生成回复的。因为有这个启动过程,所以第一句回复很慢
如果长时间没人使用,这个ollama_llama_serve的进程,就掉了,导致下一次再有人使用,又得重新调起,导致回复很慢。
请问这个有方法规避吗?
服务器版本:kylin-v10
系统架构 x86_64
加速卡型号:K100-AI gfx928 * 2张
内存:256G
容器内存200G。容器镜像:pytorch:2.3.0-py3.10-dtk24.04.3-ubuntu20.04(即楼主的这个版本)您好,我的配置是X7340+2xK100AI,dtk版本是24.04.3,按照本教程设置了环境变量:
export HSA_OVERRIDE_GFX_VERSION=9.2.8
export ROCR_VISIBLE_DEVICES=0,1,
在运行./ollama serve时能检测到8张卡。
但运行模型时通过hy-smi看到只有第一张卡有负载波动,请问是什么原因?您好,我的配置是单机8张Z100L,dtk版本是24.04.3,按照本教程设置了环境变量:
export HSA_OVERRIDE_GFX_VERSION=9.0.6
export ROCR_VISIBLE_DEVICES=0,1,2,3,4,5,6,7
在运行./ollama serve时能检测到8张卡。
但运行模型时通过rocm-smi看到只有一张卡有负载,请问是什么原因?