1.环境介绍
基础环境
k8s-dcu-plugin 定制版
K8s v1.28.6
OS Rocky Linux release 8.6
DCU K100_AI
CPU Hg Genuine
2.部署步骤
2.1 部署kuberay-operator
调整为适配hygon.com/dcu资源名称的kuberay-operator版本
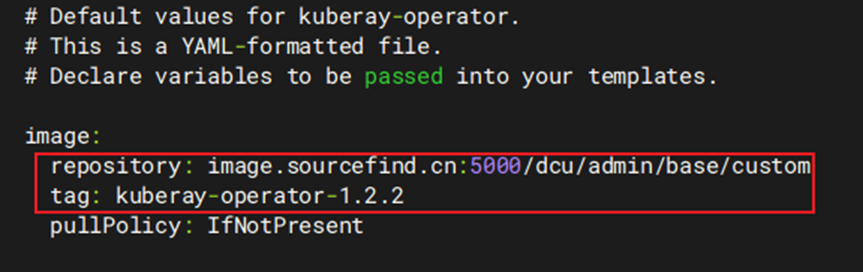
将kuberay项目代码(1.2.2版本)克隆到本地,进入helm-chart/kuberay-operator/values.yaml,修改image-repository和tag为适配hygon.com/dcu资源名称的镜像:image.sourcefind.cn:5000/dcu/admin/base/custom:kuberay-operator-1.2.2
在helm-chart目录下执行安装命令
helm install kuberay-operator kuberay-operator/ --namespace kuberay --create-namespace

kubectl -n kuberay get po
NAME                                READY   STATUS    RESTARTS   AGE
kuberay-operator-7fbdbf8c89-pt8bk   1/1     Running   0          27s
2.2 部署vLLM服务
- 准备模型
离线模型文件(此处为DeepSeek-R1-Distill-Qwen-1.5B)保存至本地/public/models路径。
注意该路径对应yaml部署文件中model-path,该路径将挂载至容器内/models路径。 - 部署脚本ray-service.vllm.dcu.yaml
该部署脚本可实现单vLLM服务实例部署,部署规格为1DCU * 1Pod。请注意,需要为Pod设置HIP_VISIBLE_DEVICES变量,其值和物理节点上所有DCU对齐。这里由于所用节点仅两个DCU,所以设置为"0,1"
apiVersion: ray.io/v1
kind: RayService
metadata:
  name: deepseek-singe
spec:
  serveConfigV2: |
    applications:
    - name: llm
      route_prefix: /
      import_path: serve:model
      deployments:
      - name: VLLMDeployment
        num_replicas: 1
        max_replicas_per_node: 1
        ray_actor_options:
          num_cpus: 8
      runtime_env:
        env_vars:
          MODEL_ID: "/models/DeepSeek-R1-Distill-Qwen-1.5B"
          TENSOR_PARALLELISM: "1"
          PIPELINE_PARALLELISM: "1"
  rayClusterConfig:
    headGroupSpec:
      rayStartParams:
        num-cpus: "8"
        dashboard-host: '0.0.0.0'
      template:
        spec:
          containers:
          - name: ray-head
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            workingDir: /
            resources:
              limits:
                hygon.com/dcu: "1"
              requests:
                hygon.com/dcu: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            ports:
            - containerPort: 6379
              name: gcs-server
            - containerPort: 8265
              name: dashboard
            - containerPort: 10001
              name: client
            - containerPort: 8000
              name: serve
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /public/models
          - name: serve-model
            configMap:
              name: serve-model
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: serve-model
data:
  serve.py: |
    import os

    from typing import Dict, Optional, List
    import logging

    from fastapi import FastAPI
    from starlette.requests import Request
    from starlette.responses import StreamingResponse, JSONResponse, Response

    from ray import serve
    from prometheus_client import generate_latest, CONTENT_TYPE_LATEST, CollectorRegistry, multiprocess

    from vllm.engine.arg_utils import AsyncEngineArgs
    from vllm.engine.async_llm_engine import AsyncLLMEngine
    from vllm.entrypoints.openai.cli_args import make_arg_parser
    from vllm.entrypoints.openai.protocol import (
        ChatCompletionRequest,
        ChatCompletionResponse,
        ErrorResponse,
    )
    from vllm.entrypoints.openai.serving_chat import OpenAIServingChat
    from vllm.entrypoints.openai.serving_engine import LoRAModulePath
    from vllm.utils import FlexibleArgumentParser
    from vllm.entrypoints.openai.serving_engine import BaseModelPath
    BASE_MODEL_PATHS = [BaseModelPath(name=os.environ['MODEL_ID'], model_path=os.environ['MODEL_ID'])]

    logger = logging.getLogger("ray.serve")

    app = FastAPI()

    @serve.deployment(name="VLLMDeployment")
    @serve.ingress(app)
    class VLLMDeployment:
        def __init__(
            self,
            engine_args: AsyncEngineArgs,
            response_role: str,
            lora_modules: Optional[List[LoRAModulePath]] = None,
            chat_template: Optional[str] = None,
        ):
            logger.info(f"Starting with engine args: {engine_args}")
            self.openai_serving_chat = None
            self.engine_args = engine_args
            self.response_role = response_role
            self.lora_modules = lora_modules
            self.chat_template = chat_template
            self.engine = AsyncLLMEngine.from_engine_args(engine_args)

        @app.post("/v1/chat/completions")
        async def create_chat_completion(
            self, request: ChatCompletionRequest, raw_request: Request
        ):
            if not self.openai_serving_chat:
                model_config = await self.engine.get_model_config()
                # Determine the name of the served model for the OpenAI client.
                if self.engine_args.served_model_name is not None:
                    served_model_names = self.engine_args.served_model_name
                else:
                    served_model_names = [self.engine_args.model]
                self.openai_serving_chat = OpenAIServingChat(
                    self.engine,
                    model_config,
                    BASE_MODEL_PATHS,
                    response_role=self.response_role,
                    lora_modules=self.lora_modules,
                    chat_template=self.chat_template,
                    prompt_adapters=None,
                    request_logger=None,
                    chat_template_content_format='auto',
                )
            logger.info(f"Request: {request}")
            generator = await self.openai_serving_chat.create_chat_completion(
                request, raw_request
            )
            if isinstance(generator, ErrorResponse):
                return JSONResponse(
                    content=generator.model_dump(), status_code=generator.code
                )
            if request.stream:
                return StreamingResponse(content=generator, media_type="text/event-stream")
            else:
                assert isinstance(generator, ChatCompletionResponse)
                return JSONResponse(content=generator.model_dump())

        @app.get("/metrics")
        async def metrics(self):
            data = generate_latest()
            return Response(content=data, media_type=CONTENT_TYPE_LATEST)


    def parse_vllm_args(cli_args: Dict[str, str]):
        parser = FlexibleArgumentParser(description="vLLM CLI")
        parser = make_arg_parser(parser)
        arg_strings = []
        for key, value in cli_args.items():
            arg_strings.extend([f"--{key}", str(value)])
        logger.info(arg_strings)
        parsed_args = parser.parse_args(args=arg_strings)
        return parsed_args


    def build_app(cli_args: Dict[str, str]) -> serve.Application:
        parsed_args = parse_vllm_args(cli_args)
        engine_args = AsyncEngineArgs.from_cli_args(parsed_args)
        engine_args.worker_use_ray = True

        return VLLMDeployment.bind(
            engine_args,
            parsed_args.response_role,
            parsed_args.lora_modules,
            parsed_args.chat_template,
        )

    model = build_app({
        "model": os.environ['MODEL_ID'],
        "tensor-parallel-size": os.environ['TENSOR_PARALLELISM'],
        "pipeline-parallel-size": os.environ['PIPELINE_PARALLELISM'],
        "distributed-executor-backend": "ray"
    })
ray dcu镜像为定制版,主要环境依赖描述:
Ray 2.42.0
vllm 0.6.6.post1+das.opt1.cust1.dtk2504
pytorch 2.4.1+das.opt1.dtk2504
ubuntu 22.04
dtk 25.04
python 3.10
3.执行部署
kubectl -n <YOUR-NAMESPACE> apply -f ray-service.vllm.dcu.yaml
部署后,服务需要过几分钟时间才ready。
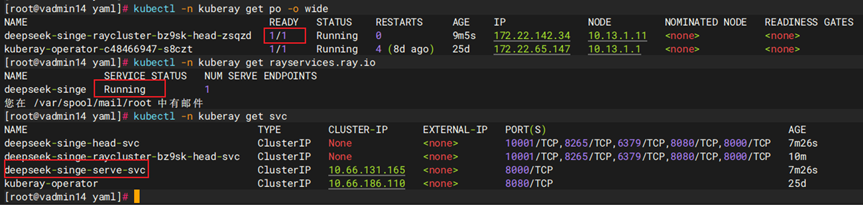
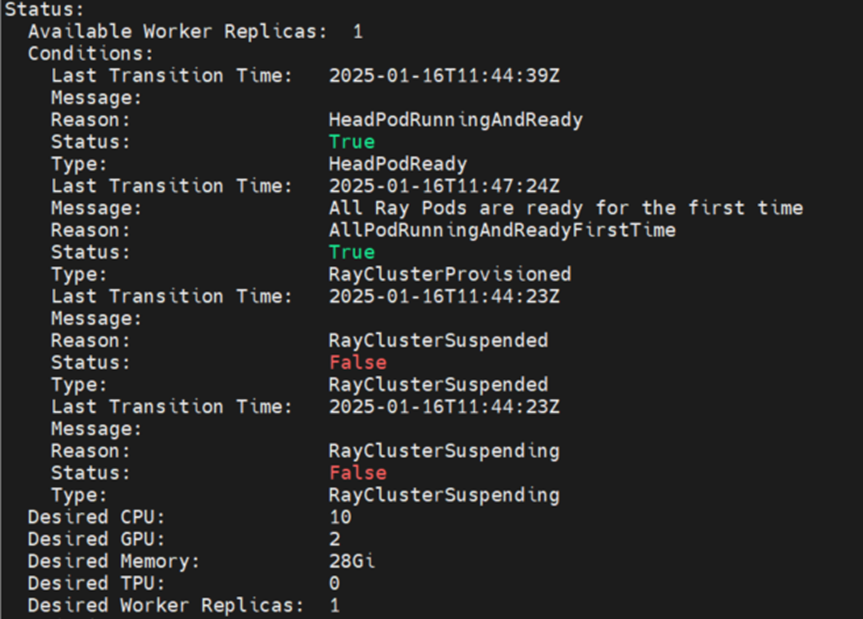
kubectl -n <YOUR-NAMESPACE> describe raycluster
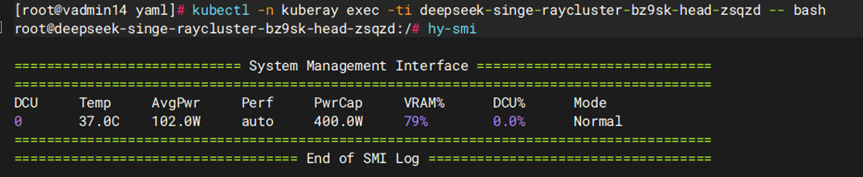
进入Pod查看显存占用
3.推理测试
物理机执行:
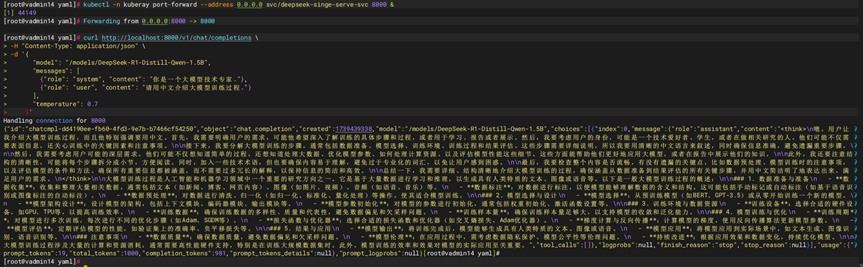
kubectl -n <YOUR-NAMESPACE> port-forward --address 0.0.0.0 svc/deepseek-singe-serve-svc 8000 &
测试命令:
curl http://localhost:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
      "model": "/models/DeepSeek-R1-Distill-Qwen-1.5B",
      "messages": [
        {"role": "system", "content": "你是一个大模型技术专家."},
        {"role": "user", "content": "请用中文介绍大模型训练过程."}
      ],
      "temperature": 0.7
    }'
4.其他模型部署模式
4.1 多实例HA模式
该模式可以实现访问流量的负载均衡,并提供一定的容错能力,在单个实例服务挂掉之后,仍可由其他启动的实例提供服务,且挂掉的实例可自动恢复。
该模式主要配置调整在于serveConfigV2 - applications - deployments - num_replicas和rayClusterConfig - workerGroupSpecs - replicas + 1(head Pod)相等,即存在几个pods,就启动几个vLLM服务。此外,serveConfigV2 - applications - runtime_env - env_vars中的TENSOR_PARALLELISM和PIPELINE_PARALLELISM两个变量用于设置并行方式,在本例中,每一个实例仅使用一个节点(Pod)上的一张卡。
apiVersion: ray.io/v1
kind: RayService
metadata:
  name: deepseek-14b-ha
spec:
  serveConfigV2: |
    applications:
    - name: llm
      route_prefix: /
      import_path: serve:model
      deployments:
      - name: VLLMDeployment
        num_replicas: 2
        max_replicas_per_node: 1
        ray_actor_options:
          num_cpus: 8
      runtime_env:
        env_vars:
          MODEL_ID: "/models/DeepSeek-R1-Distill-Qwen-14B"
          TENSOR_PARALLELISM: "1"
          PIPELINE_PARALLELISM: "1"
  rayClusterConfig:
    headGroupSpec:
      rayStartParams:
        num-cpus: "16"
        dashboard-host: '0.0.0.0'
      template:
        spec:
          containers:
          - name: ray-head
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            workingDir: /
            resources:
              limits:
                hygon.com/dcu: "1"
              requests:
                hygon.com/dcu: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            ports:
            - containerPort: 6379
              name: gcs-server
            - containerPort: 8265
              name: dashboard
            - containerPort: 10001
              name: client
            - containerPort: 8000
              name: serve
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /public/models
          - name: serve-model
            configMap:
              name: serve-model-deepseek-14b-ha
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
    workerGroupSpecs:
    - replicas: 1
      minReplicas: 1
      maxReplicas: 1
      groupName: ha-group
      rayStartParams: {}
      template:
        spec:
          containers:
          - name: llm
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            lifecycle:
              preStop:
                exec:
                  command: [ "/bin/sh","-c","ray stop" ]
            resources:
              limits:
                cpu: "8"
                memory: "20Gi"
                hygon.com/dcu: "1"
              requests:
                cpu: "8"
                memory: "20Gi"
                hygon.com/dcu: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
            securityContext:
              capabilities: {}
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /root/models
          - name: serve-model
            configMap:
              name: serve-model-deepseek-14b-ha
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: serve-model-deepseek-14b-ha
data:
  serve.py: |
    import os

    from typing import Dict, Optional, List
    import logging

    from fastapi import FastAPI
    from starlette.requests import Request
    from starlette.responses import StreamingResponse, JSONResponse, Response

    from ray import serve
    from prometheus_client import generate_latest, CONTENT_TYPE_LATEST, CollectorRegistry, multiprocess

    from vllm.engine.arg_utils import AsyncEngineArgs
    from vllm.engine.async_llm_engine import AsyncLLMEngine
    from vllm.entrypoints.openai.cli_args import make_arg_parser
    from vllm.entrypoints.openai.protocol import (
        ChatCompletionRequest,
        ChatCompletionResponse,
        ErrorResponse,
    )
    from vllm.entrypoints.openai.serving_chat import OpenAIServingChat
    from vllm.entrypoints.openai.serving_engine import LoRAModulePath
    from vllm.utils import FlexibleArgumentParser
    from vllm.entrypoints.openai.serving_engine import BaseModelPath
    BASE_MODEL_PATHS = [BaseModelPath(name=os.environ['MODEL_ID'], model_path=os.environ['MODEL_ID'])]

    logger = logging.getLogger("ray.serve")

    app = FastAPI()


    @serve.deployment(name="VLLMDeployment")
    @serve.ingress(app)
    class VLLMDeployment:
        def __init__(
            self,
            engine_args: AsyncEngineArgs,
            response_role: str,
            lora_modules: Optional[List[LoRAModulePath]] = None,
            chat_template: Optional[str] = None,
        ):
            logger.info(f"Starting with engine args: {engine_args}")
            self.openai_serving_chat = None
            self.engine_args = engine_args
            self.response_role = response_role
            self.lora_modules = lora_modules
            self.chat_template = chat_template
            self.engine = AsyncLLMEngine.from_engine_args(engine_args)

        @app.post("/v1/chat/completions")
        async def create_chat_completion(
            self, request: ChatCompletionRequest, raw_request: Request
        ):
            if not self.openai_serving_chat:
                model_config = await self.engine.get_model_config()
                # Determine the name of the served model for the OpenAI client.
                if self.engine_args.served_model_name is not None:
                    served_model_names = self.engine_args.served_model_name
                else:
                    served_model_names = [self.engine_args.model]
                self.openai_serving_chat = OpenAIServingChat(
                    self.engine,
                    model_config,
                    BASE_MODEL_PATHS,
                    response_role=self.response_role,
                    lora_modules=self.lora_modules,
                    chat_template=self.chat_template,
                    prompt_adapters=None,
                    request_logger=None,
                    chat_template_content_format='auto',
                )
            logger.info(f"Request: {request}")
            generator = await self.openai_serving_chat.create_chat_completion(
                request, raw_request
            )
            if isinstance(generator, ErrorResponse):
                return JSONResponse(
                    content=generator.model_dump(), status_code=generator.code
                )
            if request.stream:
                return StreamingResponse(content=generator, media_type="text/event-stream")
            else:
                assert isinstance(generator, ChatCompletionResponse)
                return JSONResponse(content=generator.model_dump())

        @app.get("/metrics")
        async def metrics(self):
            data = generate_latest()
            return Response(content=data, media_type=CONTENT_TYPE_LATEST)

    def parse_vllm_args(cli_args: Dict[str, str]):
        parser = FlexibleArgumentParser(description="vLLM CLI")
        parser = make_arg_parser(parser)
        arg_strings = []
        for key, value in cli_args.items():
            arg_strings.extend([f"--{key}", str(value)])
        logger.info(arg_strings)
        parsed_args = parser.parse_args(args=arg_strings)
        return parsed_args


    def build_app(cli_args: Dict[str, str]) -> serve.Application:
        parsed_args = parse_vllm_args(cli_args)
        engine_args = AsyncEngineArgs.from_cli_args(parsed_args)
        engine_args.worker_use_ray = True

        return VLLMDeployment.bind(
            engine_args,
            parsed_args.response_role,
            parsed_args.lora_modules,
            parsed_args.chat_template,
        )

    model = build_app({
        "model": os.environ['MODEL_ID'],
        "tensor-parallel-size": os.environ['TENSOR_PARALLELISM'],
        "pipeline-parallel-size": os.environ['PIPELINE_PARALLELISM'],
        "distributed-executor-backend": "ray"
    })
本例部署后,会启动一个head和一个worker节点,发送推理请求,请求由SVC分配到某一个Pod上,由该Pod完成推理。
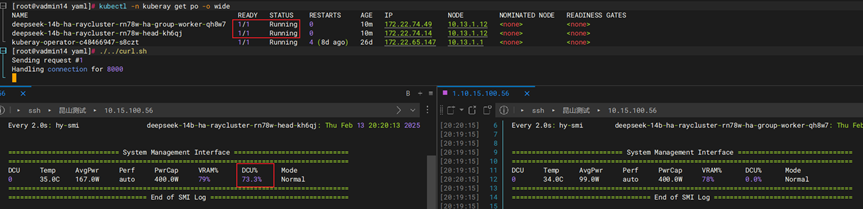
使用Apipost向多实例集群发送并发推理请求,发现请求分散到了两个worker上。
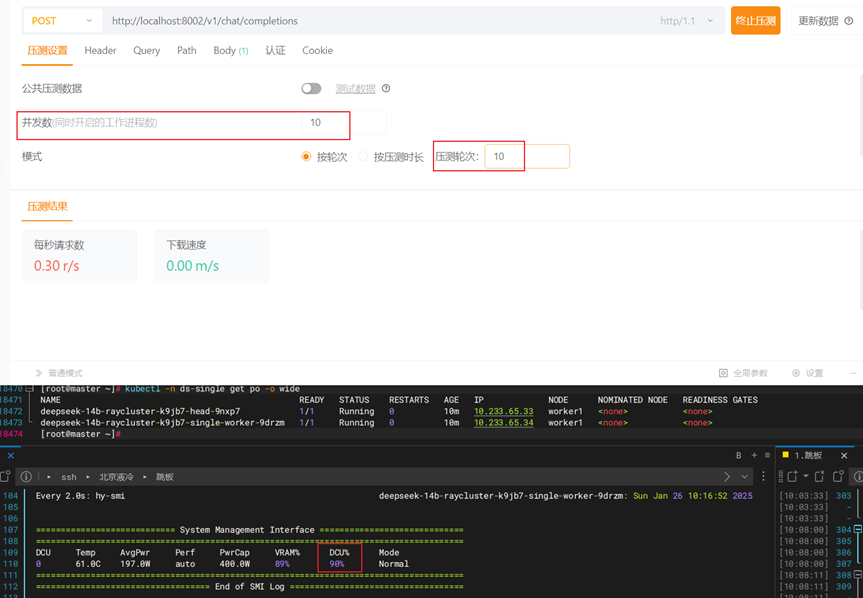
我们同样对单实例发送并发数为10,轮次为10的请求。在该测试中,多实例集群(两个副本)相比单实例,执行时间减少了大约36.3%,每秒请求数提升了约56%,平均响应时间减少了大约35.2%。这表明多实例集群在相同并发数和轮次条件下,能显著减少执行时间并提高吞吐量,提供更好的性能;其并发能力得到充分发挥,能同时处理更多的请求。
4.2 跨节点分布式推理模式
该模式支持DeepSeek 671B模型推理
该模式是基于KubeRay实现的一种特定场景,可以结合跨节点的DCU算力来实现推理需求。
该模式主要配置调整在于serveConfigV2 - applications - deployments - num_replicas指定为1,即仅启动一份vLLM服务;rayClusterConfig - workerGroupSpecs - replicas + head为多副本,即存在几个pods,但对应到一个vLLM服务。在本例中,serveConfigV2 - applications - runtime_env - env_vars中的TENSOR_PARALLELISM设置为1,PIPELINE_PARALLELISM设置为2,即启动的vLLM服务使用两个节点(Pod),每个节点配置一张卡(共使用了跨节点的两张卡)。
apiVersion: ray.io/v1
kind: RayService
metadata:
  name: deepseek-32b-cross-node
spec:
  serveConfigV2: |
    applications:
    - name: llm
      route_prefix: /
      import_path: serve:model
      deployments:
      - name: VLLMDeployment
        num_replicas: 1
        max_replicas_per_node: 1
        ray_actor_options:
          num_cpus: 8
      runtime_env:
        env_vars:
          MODEL_ID: "/models/DeepSeek-R1-Distill-Qwen-32B"
          TENSOR_PARALLELISM: "1"
          PIPELINE_PARALLELISM: "2"
  rayClusterConfig:
    headGroupSpec:
      rayStartParams:
        num-cpus: "16"
        dashboard-host: '0.0.0.0'
      template:
        spec:
          containers:
          - name: ray-head
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            workingDir: /
            securityContext:
              capabilities:
                add: ["IPC_LOCK"]
            resources:
              limits:
                hygon.com/dcu: "1"
                rdma/rdma_shared_devices_a: "1"
              requests:
                hygon.com/dcu: "1"
                rdma/rdma_shared_devices_a: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            ports:
            - containerPort: 6379
              name: gcs-server
            - containerPort: 8265
              name: dashboard
            - containerPort: 10001
              name: client
            - containerPort: 8000
              name: serve
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /root/models
          - name: serve-model
            configMap:
              name: serve-model
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
    workerGroupSpecs:
    - replicas: 1
      minReplicas: 1
      maxReplicas: 1
      groupName: dcu-group
      rayStartParams: {}
      template:
        spec:
          containers:
          - name: llm
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            lifecycle:
              preStop:
                exec:
                  command: [ "/bin/sh","-c","ray stop" ]
            securityContext:
              capabilities:
                add: ["IPC_LOCK"]
            resources:
              limits:
                hygon.com/dcu: "1"
                rdma/rdma_shared_devices_a: "1"
              requests:
                hygon.com/dcu: "1"
                rdma/rdma_shared_devices_a: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
            securityContext:
              capabilities: {}
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /root/models
          - name: serve-model
            configMap:
              name: serve-model
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: serve-model
data:
  serve.py: |
    import os

    from typing import Dict, Optional, List
    import logging

    from fastapi import FastAPI
    from starlette.requests import Request
    from starlette.responses import StreamingResponse, JSONResponse, Response

    from ray import serve
    from prometheus_client import generate_latest, CONTENT_TYPE_LATEST, CollectorRegistry, multiprocess

    from vllm.engine.arg_utils import AsyncEngineArgs
    from vllm.engine.async_llm_engine import AsyncLLMEngine
    from vllm.entrypoints.openai.cli_args import make_arg_parser
    from vllm.entrypoints.openai.protocol import (
        ChatCompletionRequest,
        ChatCompletionResponse,
        ErrorResponse,
    )
    from vllm.entrypoints.openai.serving_chat import OpenAIServingChat
    from vllm.entrypoints.openai.serving_engine import LoRAModulePath
    from vllm.utils import FlexibleArgumentParser
    from vllm.entrypoints.openai.serving_engine import BaseModelPath
    BASE_MODEL_PATHS = [BaseModelPath(name=os.environ['MODEL_ID'], model_path=os.environ['MODEL_ID'])]

    logger = logging.getLogger("ray.serve")

    app = FastAPI()


    @serve.deployment(name="VLLMDeployment")
    @serve.ingress(app)
    class VLLMDeployment:
        def __init__(
            self,
            engine_args: AsyncEngineArgs,
            response_role: str,
            lora_modules: Optional[List[LoRAModulePath]] = None,
            chat_template: Optional[str] = None,
        ):
            logger.info(f"Starting with engine args: {engine_args}")
            self.openai_serving_chat = None
            self.engine_args = engine_args
            self.response_role = response_role
            self.lora_modules = lora_modules
            self.chat_template = chat_template
            self.engine = AsyncLLMEngine.from_engine_args(engine_args)

        @app.post("/v1/chat/completions")
        async def create_chat_completion(
            self, request: ChatCompletionRequest, raw_request: Request
        ):
            if not self.openai_serving_chat:
                model_config = await self.engine.get_model_config()
                # Determine the name of the served model for the OpenAI client.
                if self.engine_args.served_model_name is not None:
                    served_model_names = self.engine_args.served_model_name
                else:
                    served_model_names = [self.engine_args.model]
                self.openai_serving_chat = OpenAIServingChat(
                    self.engine,
                    model_config,
                    BASE_MODEL_PATHS,
                    response_role=self.response_role,
                    lora_modules=self.lora_modules,
                    chat_template=self.chat_template,
                    prompt_adapters=None,
                    request_logger=None,
                    chat_template_content_format='auto',
                )
            logger.info(f"Request: {request}")
            generator = await self.openai_serving_chat.create_chat_completion(
                request, raw_request
            )
            if isinstance(generator, ErrorResponse):
                return JSONResponse(
                    content=generator.model_dump(), status_code=generator.code
                )
            if request.stream:
                return StreamingResponse(content=generator, media_type="text/event-stream")
            else:
                assert isinstance(generator, ChatCompletionResponse)
                return JSONResponse(content=generator.model_dump())

        @app.get("/metrics")
        async def metrics(self):
            data = generate_latest()
            return Response(content=data, media_type=CONTENT_TYPE_LATEST)


    def parse_vllm_args(cli_args: Dict[str, str]):
        parser = FlexibleArgumentParser(description="vLLM CLI")
        parser = make_arg_parser(parser)
        arg_strings = []
        for key, value in cli_args.items():
            arg_strings.extend([f"--{key}", str(value)])
        logger.info(arg_strings)
        parsed_args = parser.parse_args(args=arg_strings)
        return parsed_args


    def build_app(cli_args: Dict[str, str]) -> serve.Application:
        parsed_args = parse_vllm_args(cli_args)
        engine_args = AsyncEngineArgs.from_cli_args(parsed_args)
        engine_args.worker_use_ray = True

        return VLLMDeployment.bind(
            engine_args,
            parsed_args.response_role,
            parsed_args.lora_modules,
            parsed_args.chat_template,
        )

    model = build_app({
        "model": os.environ['MODEL_ID'],
        "tensor-parallel-size": os.environ['TENSOR_PARALLELISM'],
        "pipeline-parallel-size": os.environ['PIPELINE_PARALLELISM'],
        "distributed-executor-backend": "ray"
    })
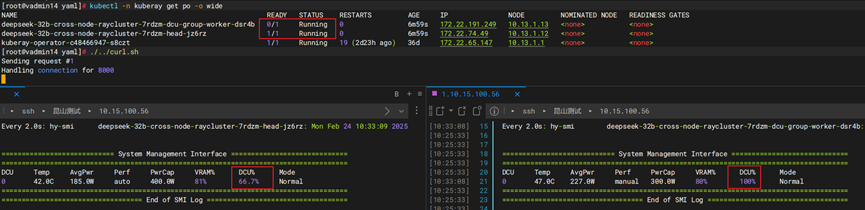
本例部署后,会启动一个head和一个worker节点。发送推理请求,请求落到vLLM服务所在的节点上,但两个节点会共同提供算力完成推理。
以下示例是部署vLLM 0.6.6 + DeepSeek-V3-bf16(671B)的编排信息,使用了8DCU * 4Pod(head参与模型加载与推理)跨节点分布式部署。
相比较上个跨节点分布式部署示例,该示例由于本地模型的变更,配置vllm serve --trust-remote-code参数(engine_args.trust_remote_code = True);为避免引发OOM,vllm serve设置max-model-len参数为较小值 ("max-model-len": "4096")。在本例中,serveConfigV2 - applications - runtime_env - env_vars中的TENSOR_PARALLELISM设置为8,PIPELINE_PARALLELISM设置为4,即启动的vLLM服务使用4个节点(Pod),每个节点配置8张卡(共使用了跨节点的32张卡)。
apiVersion: ray.io/v1
kind: RayService
metadata:
  name: deepseek-v3-cross-node
spec:
  serveConfigV2: |
    applications:
    - name: llm
      route_prefix: /
      import_path: serve:model
      deployments:
      - name: VLLMDeployment
        num_replicas: 1
        max_replicas_per_node: 1
        ray_actor_options:
          num_cpus: 8
      runtime_env:
        env_vars:
          MODEL_ID: "/models/DeepSeek-V3-bf16"
          TENSOR_PARALLELISM: "8"
          PIPELINE_PARALLELISM: "4"
  rayClusterConfig:
    headGroupSpec:
      rayStartParams:
        num-cpus: "16"
        dashboard-host: '0.0.0.0'
      template:
        spec:
          containers:
          - name: ray-head
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            workingDir: /
            securityContext:
              capabilities:
                add: ["IPC_LOCK"]
            resources:
              limits:
                hygon.com/dcu: "8"
                rdma/rdma_shared_devices_a: "1"
              requests:
                hygon.com/dcu: "8"
                rdma/rdma_shared_devices_a: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2,3,4,5,6,7"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            ports:
            - containerPort: 6379
              name: gcs-server
            - containerPort: 8265
              name: dashboard
            - containerPort: 10001
              name: client
            - containerPort: 8000
              name: serve
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models/DeepSeek-V3-bf16
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /public/opendas/DL_DATA/llm-models/deepseek-v3/DeepSeek-V3-bf16
          - name: serve-model
            configMap:
              name: serve-model
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
    workerGroupSpecs:
    - replicas: 3
      minReplicas: 3
      maxReplicas: 3
      groupName: cross-node-group
      rayStartParams: {}
      template:
        spec:
          containers:
          - name: llm
            image: image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10
            lifecycle:
              preStop:
                exec:
                  command: [ "/bin/sh","-c","ray stop" ]
            securityContext:
              capabilities:
                add: ["IPC_LOCK"]
            resources:
              limits:
                hygon.com/dcu: "8"
                rdma/rdma_shared_devices_a: "1"
              requests:
                hygon.com/dcu: "8"
                rdma/rdma_shared_devices_a: "1"
            env:
            - name: HIP_VISIBLE_DEVICES
              value: "0,1,2,3,4,5,6,7"
            - name: NCCL_DEBUG
              value: "INFO"
            - name: NCCL_IB_DISABLE
              value: "0"
            volumeMounts:
            - name: hyhal-volume
              mountPath: /opt/hyhal
              readOnly: true
            - name: model-path
              mountPath: /models/DeepSeek-V3-bf16
            - name: serve-model
              mountPath: /serve.py
              subPath: serve.py
            securityContext:
              capabilities: {}
          volumes:
          - name: hyhal-volume
            hostPath:
              path: /opt/hyhal
          - name: model-path
            hostPath:
              path: /public/opendas/DL_DATA/llm-models/deepseek-v3/DeepSeek-V3-bf16
          - name: serve-model
            configMap:
              name: serve-model
              defaultMode: 0777
              items:
              - key: serve.py
                path: serve.py
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: serve-model
data:
  serve.py: |
    import os

    from typing import Dict, Optional, List
    import logging

    from fastapi import FastAPI
    from starlette.requests import Request
    from starlette.responses import StreamingResponse, JSONResponse, Response

    from ray import serve
    from prometheus_client import generate_latest, CONTENT_TYPE_LATEST, CollectorRegistry, multiprocess

    from vllm.engine.arg_utils import AsyncEngineArgs
    from vllm.engine.async_llm_engine import AsyncLLMEngine
    from vllm.entrypoints.openai.cli_args import make_arg_parser
    from vllm.entrypoints.openai.protocol import (
        ChatCompletionRequest,
        ChatCompletionResponse,
        ErrorResponse,
    )
    from vllm.entrypoints.openai.serving_chat import OpenAIServingChat
    from vllm.entrypoints.openai.serving_engine import LoRAModulePath
    from vllm.utils import FlexibleArgumentParser
    from vllm.entrypoints.openai.serving_engine import BaseModelPath
    BASE_MODEL_PATHS = [BaseModelPath(name=os.environ['MODEL_ID'], model_path=os.environ['MODEL_ID'])]

    logger = logging.getLogger("ray.serve")

    app = FastAPI()


    @serve.deployment(name="VLLMDeployment")
    @serve.ingress(app)
    class VLLMDeployment:
        def __init__(
            self,
            engine_args: AsyncEngineArgs,
            response_role: str,
            lora_modules: Optional[List[LoRAModulePath]] = None,
            chat_template: Optional[str] = None,
        ):
            logger.info(f"Starting with engine args: {engine_args}")
            self.openai_serving_chat = None
            self.engine_args = engine_args
            self.response_role = response_role
            self.lora_modules = lora_modules
            self.chat_template = chat_template
            self.engine = AsyncLLMEngine.from_engine_args(engine_args)

        @app.post("/v1/chat/completions")
        async def create_chat_completion(
            self, request: ChatCompletionRequest, raw_request: Request
        ):
            if not self.openai_serving_chat:
                model_config = await self.engine.get_model_config()
                # Determine the name of the served model for the OpenAI client.
                if self.engine_args.served_model_name is not None:
                    served_model_names = self.engine_args.served_model_name
                else:
                    served_model_names = [self.engine_args.model]
                self.openai_serving_chat = OpenAIServingChat(
                    self.engine,
                    model_config,
                    BASE_MODEL_PATHS,
                    response_role=self.response_role,
                    lora_modules=self.lora_modules,
                    chat_template=self.chat_template,
                    prompt_adapters=None,
                    request_logger=None,
                    chat_template_content_format='auto',
                )
            logger.info(f"Request: {request}")
            generator = await self.openai_serving_chat.create_chat_completion(
                request, raw_request
            )
            if isinstance(generator, ErrorResponse):
                return JSONResponse(
                    content=generator.model_dump(), status_code=generator.code
                )
            if request.stream:
                return StreamingResponse(content=generator, media_type="text/event-stream")
            else:
                assert isinstance(generator, ChatCompletionResponse)
                return JSONResponse(content=generator.model_dump())

        @app.get("/metrics")
        async def metrics(self):
            data = generate_latest()
            return Response(content=data, media_type=CONTENT_TYPE_LATEST)


    def parse_vllm_args(cli_args: Dict[str, str]):
        parser = FlexibleArgumentParser(description="vLLM CLI")
        parser = make_arg_parser(parser)
        arg_strings = []
        for key, value in cli_args.items():
            arg_strings.extend([f"--{key}", str(value)])
        logger.info(arg_strings)
        parsed_args = parser.parse_args(args=arg_strings)
        return parsed_args


    def build_app(cli_args: Dict[str, str]) -> serve.Application:
        parsed_args = parse_vllm_args(cli_args)
        engine_args = AsyncEngineArgs.from_cli_args(parsed_args)
        engine_args.worker_use_ray = True
        engine_args.trust_remote_code = True

        return VLLMDeployment.bind(
            engine_args,
            parsed_args.response_role,
            parsed_args.lora_modules,
            parsed_args.chat_template,
        )

    model = build_app({
        "model": os.environ['MODEL_ID'],
        "tensor-parallel-size": os.environ['TENSOR_PARALLELISM'],
        "pipeline-parallel-size": os.environ['PIPELINE_PARALLELISM'],
        "distributed-executor-backend": "ray",
        "max-model-len": "4096"
    })

 暂无数据 暂无数据
kubectl logs raycluster.ray.io/deepseek-singe-raycluster-rz96k -n dcu
error: no kind "RayCluster" is registered for version "ray.io/v1" in scheme "pkg/scheme/scheme.go:28"
这个是什么错误?怎么解决还有个问题,我用的还是这个镜像image.sourcefind.cn:5000/dcu/admin/base/custom:ray-2.42.0-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10, 起了一个DeepSeek-R1-Distill-Qwen-32B,用了两张k100-ai的卡,显存GPU-MEMORY-UTILIZATION设置的是0.8,
在进行并发测试时,发现ray限制了并发请求数max_ongoing_requests默认是5,后来增大到1024了,
但是在测试大并发如32,64,128,256时,遇到的情况是刚开始两张卡显存占用正常都是74%左右,请求的max_token是512,单次请求不会出现异常,当并发数大后,出现某个卡显存占用突然变成0,rayservice状态还是正常的。
看 events/event_RAYLET.log
有个报错:
A worker died or was killed while executing a task by an unexpected system error. To troubleshoot the problem, check the logs for the dead worker. RayTask ID: ffffffffffffffffcc6776207407837d4e8ad28101000000 Worker ID: bdde70368c437f858b41e15d27db3b3728134f7b8412b58472f32ff6 Node ID: 143f37340ffacce30a5e0012c59a8fa854dde0d0c922e35de4a3a11a Worker IP address: 10.0.0.232 Worker port: 10027 Worker PID: 9925 Worker exit type: SYSTEM_ERROR Worker exit detail: Worker unexpectedly exits with a connection error code 2. End of file. There are some potential root causes. (1) The process is killed by SIGKILL by OOM killer due to high memory usage. (2) ray stop --force is called. (3) The worker is crashed unexpectedly due to SIGSEGV or other unexpected errors.
然后又添加了不让ray做内存监测的参数,
env:
- name: RAY_memory_monitor_refresh_ms
value: "0"
但是也没有生效,不知道您那边有遇到这样的问题没感谢分享,不过按文档 4.2 跨节点分布式推理模式 操作之后,ray的worker pod 一直处于 0/1 Running状态,参考kuberay官方的说法,https://docs.ray.io/en/master/cluster/kubernetes/user-guides/rayservice-no-ray-serve-replica.html
大体上意思是,kuberay在v1.0.0以后,会对worker节点添加一个readiness的探针,探测8000 的ProxyActor端口,但ray在2.8以后,只有在部署serve replica的节点上才会启动ProxyActor服务。但此配置内spec.serveConfigV2.applications.deployments.num_replicas为1,而serve服务在head节点上启动了,因此worker节点并没有启动serve服务,进而不会启动ProxyActor,进而readiness探针失败,造成worker的pod一直处于0/1状态,同时通过dashboard可以看到,app部署失败.
从您这边的截图,也可以看到worker节点(pod)实际并不是真正的运行中状态,也是0/1
参考官方的修改,比如增加num_replicas,或比如给header的rayStartParams.num-cpus设置 0(官方说这样serve就不会在header这边启动.
但不管哪一种修改,实际依然在header这边启动serve服务,而worker节点不会启动.
不清楚是否是dcu这边的定制镜像做了什么调整导致的?这个image.sourcefind.cn:5000/dcu/admin/base/custom:kuberay-operator-1.2.2镜像适配了k8s的v1.30.1版本了吗。
报错:{"level":"error","ts":"2025-03-13T08:25:13.142Z","logger":"setup","msg":"Unable to set flag gates for known features","error":"unrecognized feature gate: RayJobDeletionPolicy","stacktrace":"main.exitOnError\n\t/workspace/main.go:270\nmain.main\n\t/workspace/main.go:181\nruntime.main\n\t/usr/local/go/src/runtime/proc.go:271"}