1
0
0
0
使用GPUfusion编译的Cuda程序,寄存器数量的溢出问题
2025-03-12 11:26:09
135
用DTK里的dccobjdump反汇编工具来查看我的CUDA核函数的寄存器的分配情况,分析了分子动力学模拟中两种不同计算复杂度的力计算核函数。
命令如下
dccobjdump --inputs=DpdForce.u.o --show-resource-usage
dccobjdump --inputs=AniForce.u.o --show-resource-usage
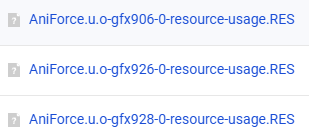
会生成对应三个不同架构(gfx906、gfx926、gfx928)的RES文件,结果没啥区别。如图
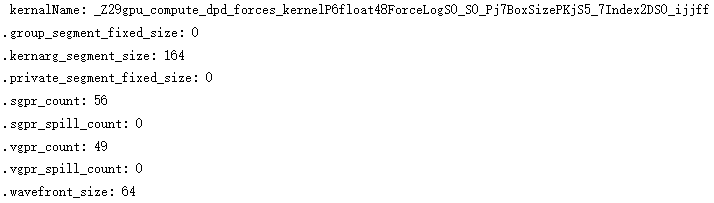
打开后寄存器数量如下:
相对简单的DpdForce核函数的反汇编结果:
相对复杂的AniForce核函数的反汇编结果:
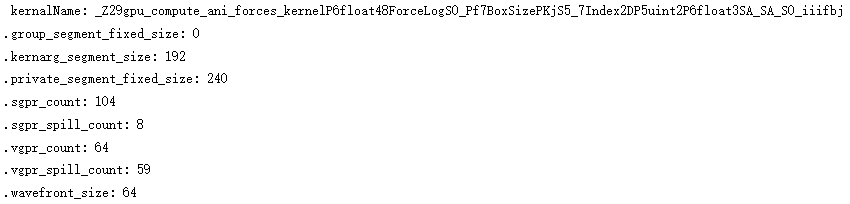 可以看出vgpr超过64、多的就会成为溢出的寄存器数量。可是vgpr的数量不是上限256个的吗,难道是通过GPUfusion编译时会默认设置个寄存器数量啥的吗,反正我并没有在Makefile中主动设置这个选项。而且似乎程序的性能也受到了影响,相对简单的DpdForce运行耗时在移植后就还行,但相对复杂的AniForce性能特别的差。就是不知道为什么这里的vgpr的限制为啥只有64个,存在编译参数可以调控吗,CUDA程序适配手册中并没有看到,望路过大神解答
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据
每个线程可以用到的寄存器数量 与每个block 下面的线程数目有关,请看下这个kernel配置的block下面的线程数目