2
1
DeepSeek
【已解决】deepseek-distill&QWQ使用vllm部署经验分享
2025-03-14 18:50:46
225

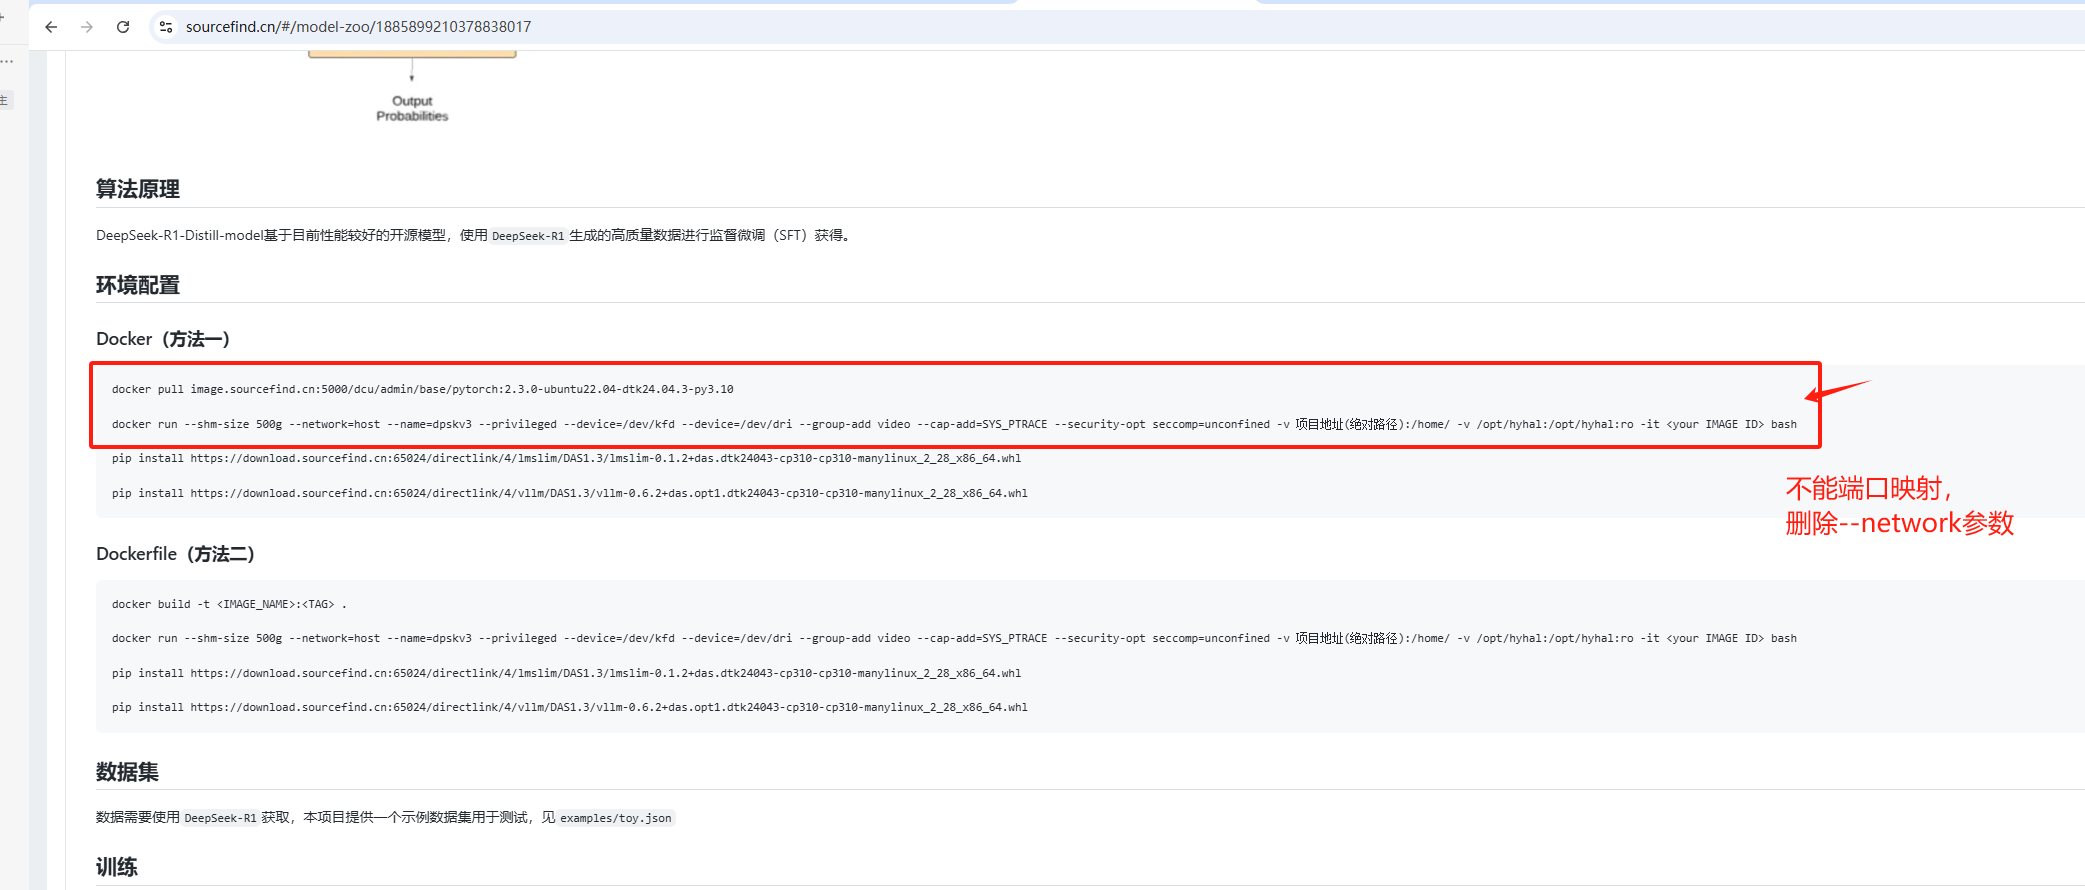
1、直接使用光源的容器命令无法实现端口映射,需要去掉--network参数再加-p 端口号就可以解决。
attachmentId-image.png

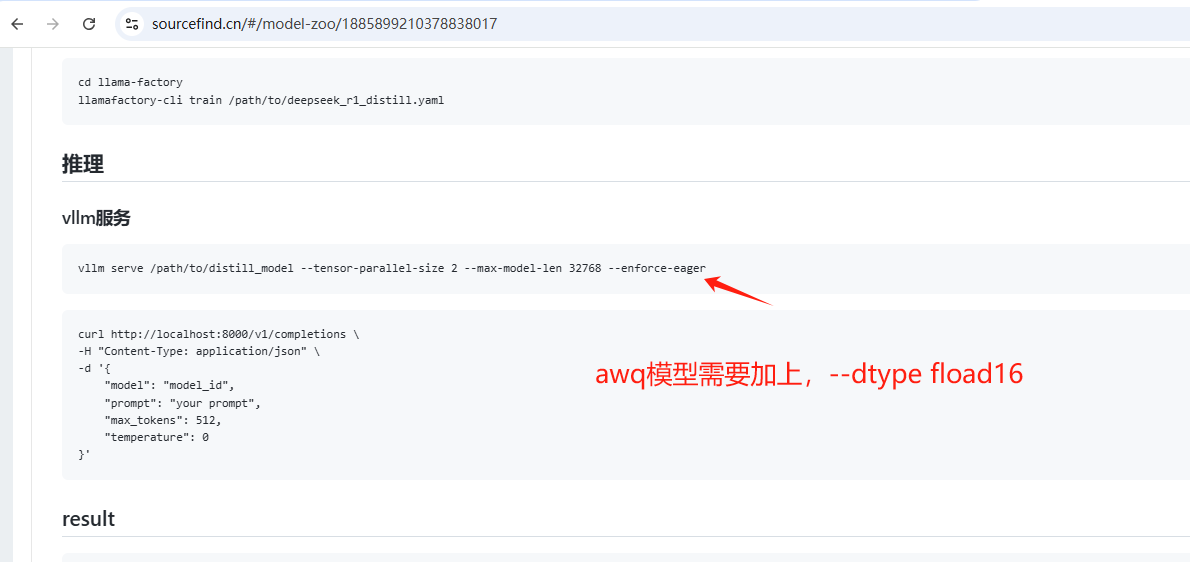
2、vllm0.6.2可以跑awq模型需要加上--dtype float16,不然会报错 bf16不支持的错误
attachmentId-image.png

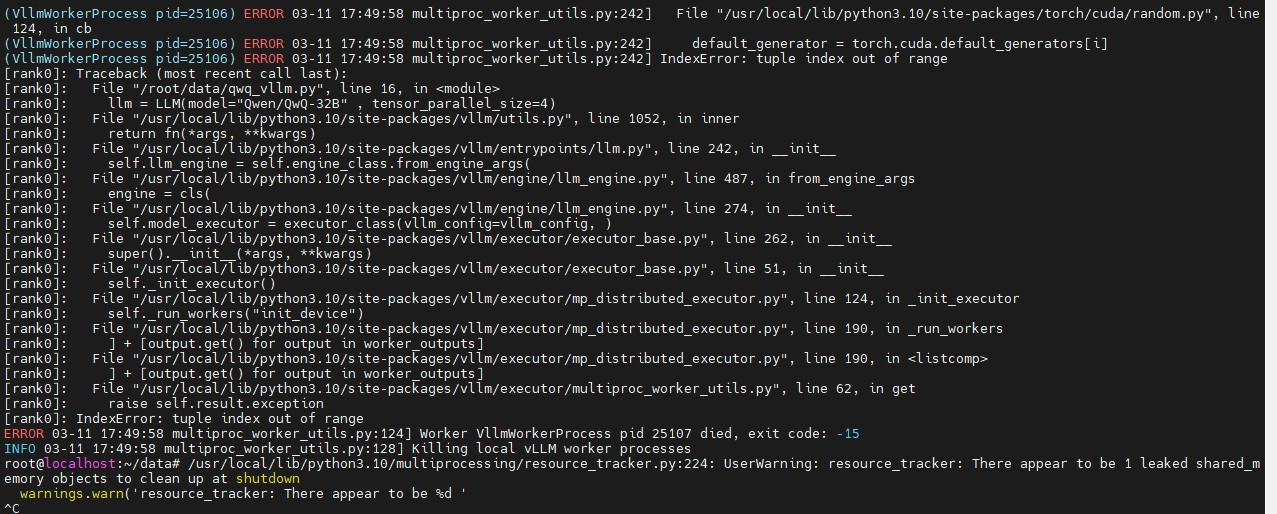
3、跑QWQ的infer_vllm脚本的话 不添加export HIP_VISIBLE_DEVICES=0,1,2,3,4,5,6,7的话,执行会报错,用vllm0.7.2和0.6.2都是这样。但transformer直接跑没问题。
attachmentId-image.png

全部评论(6)
只看楼主
网
网友TZwsSF
2楼
您好请教一下,同问一下qwq部署报错tuple index out of range,用transformer跑是怎么操作解决的呢
2025/4/3
索
索大喝旺仔
回复 @网友TZwsSF
具体的命令和报错截图可以贴一下
2025/4/3
网
网友TZwsSF
回复 @网友TZwsSF
不好意思才看到消息,报错信息跟您最后一张图片一样,docker镜像vllm0.6.2和0.7.2都试了,执行代码为CUDA_VISIBLE_DEVICES=0,5,6,7 python -m vllm.entrypoints.openai.api_server --model /model/qwq32B --enforce-eager --gpu-memory-utilization 0.9 --served-model-name qwq32b --trust-remote-code --tensor-parallel-size 4 --host 0.0.0.0 --port 8800。想问一下最后怎么成功运行的呢
2025/4/9
Y
yangzhong
回复 @网友TZwsSF
CUDA_VISIBLE_DEVICES=0,5,6,7换成HIP_VISIBLE_DEVICES=0,5,6,7可以解决
2025/4/23
网
网友8iBePU
1楼

请问vllm0.7.2镜像在哪里找呢?

2025/3/17
索
索大喝旺仔
回复 @网友8iBePU
0.7.2的目前还没正式发布,我是找技术同事要到的内测版本。:ciya:emoji
2025/3/21
没有更多内容了
--
楼主
Level.1
0 帖子
楼主热帖
暂无数据

