把启动方式,输入输出长度的信息都贴一下吧
0
1
0
1
求一个提升推理速度的方法
2025-03-19 15:07:16
336
操作系统版本:Ubuntu 22.04.5
DTK版本:dtk-25.04
驱动版本:/
DCU类型:K100_ai *2卡
模型:qwq_32b
vllm:pytorch2.4.1-ubuntu22.04-dtk25.04-rc4-vllm0.6.6-py3.10.tar.gz
推理问题token数:809
推理耗时 107.69168257713318
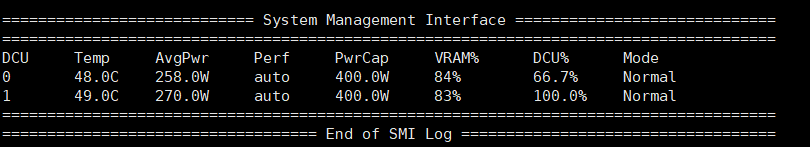
下面是推理时的资源占用情况
全部评论(7)
只看楼主
R
2025/3/19
T
当前推理速度是多少?预期提升到多少呢?
2025/3/19
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据