能接受镜像的方式部署么
0
4
0
0
vllm 启动 DeepSeek-R1-Distill-Qwen-32B 模型的处理速度问题
2026-05-09 15:27:55
209
KylinSP3的操作系统,海光K100_AI 64GB * 4卡,conda创建的是python==3.10的虚拟环境,虚拟环境里面加载torch-2.4.1、vllm-0.6.2的依赖,模型启动时,如果不加--enforce-eager选项则会有以下的报错:
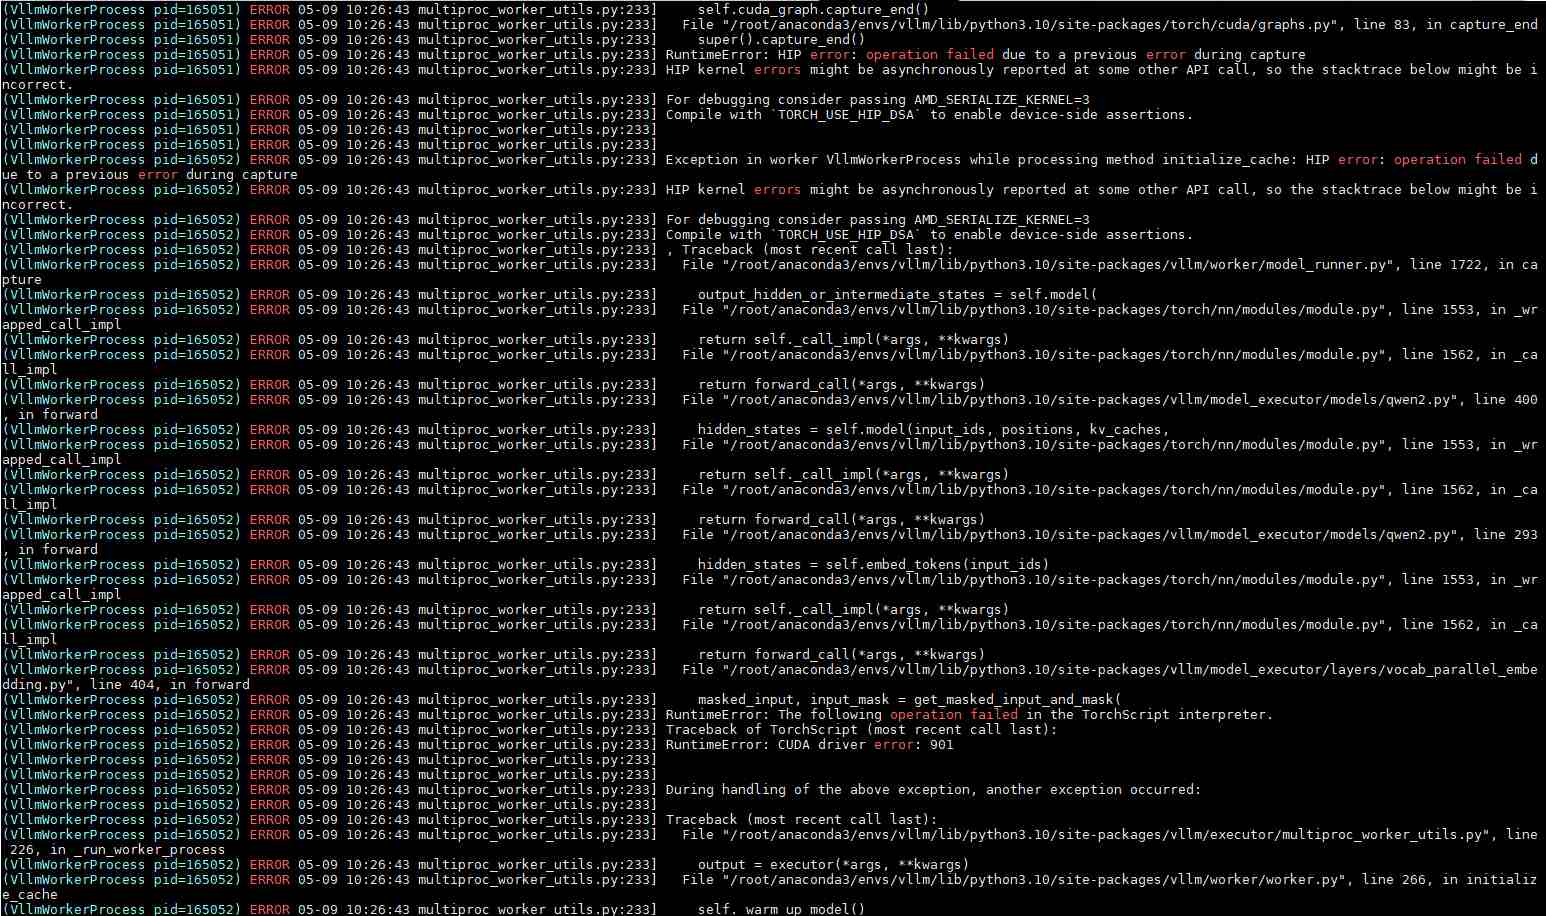
增加选项后目前模型启动方式为:python3 -m vllm.entrypoints.openai.api_server --model '/root/models/DeepSeek-R1-Distill-Qwen-32B' --served-model-name 'DeepSeek-R1-32B' --host 0.0.0.0 --port 8000 --max-model-len 8192 --tensor-parallel-size 4 --enforce-eager --block-size 32 --max-num-seqs 256 ,但是问答时测试速度大概在 10token/s,截图如下:
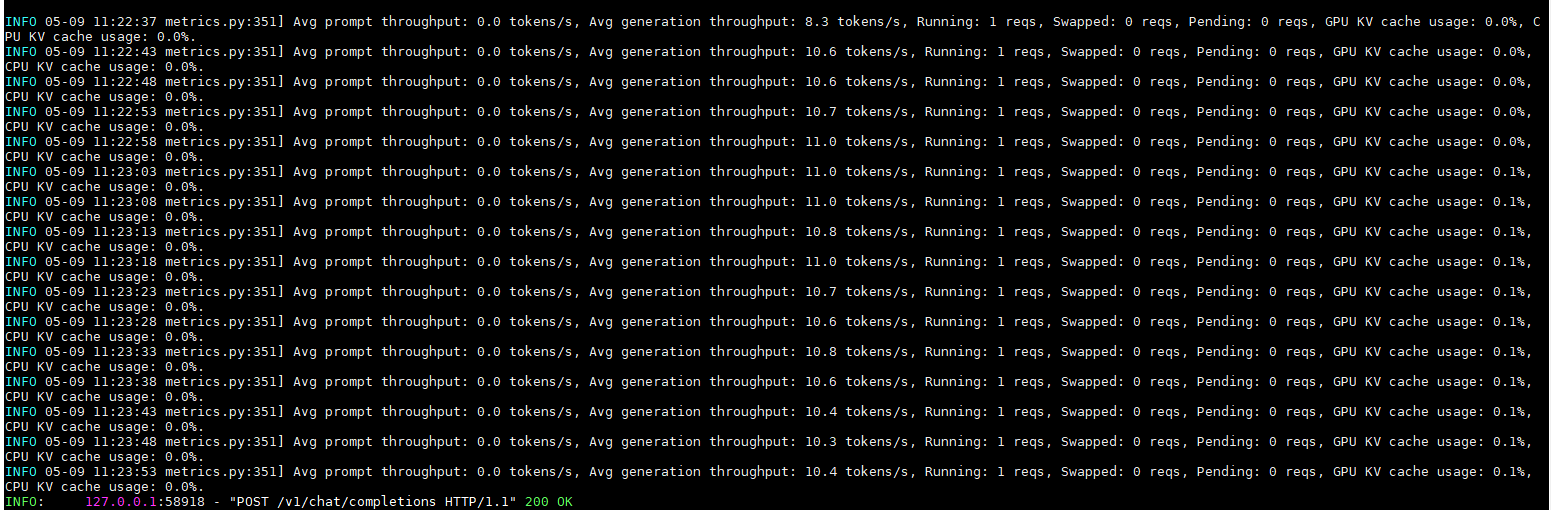
并且用两卡测试速度也是10token/s,与四卡速度区别不大,请问该如何优化提升处理速度?
全部评论(8)
只看楼主
5/14
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据