请问你是用z100跑通了单卡的qwen3 dense吗
0
1
0
0
vLLM 在 Z100 服务器使用两卡推理报错问题
2025-10-09 17:09:03
156
您好,我遇到这样一个问题,vLLM 在 Z100 服务器使用两卡推理报错(单卡是正常的)
镜像:image.sourcefind.cn:5000/dcu/admin/base/pytorch:2.4.1-ubuntu22.04-dtk25.04.1-py3.10
启动命令:vllm.entrypoints.openai.api_server --trust-remote-code --enable-prefix-caching --disable-log-requests --model /data --gpu-memory-utilization 0.95 -tp 2 -pp 1 --port 8000 --served-model-name Qwen3-0.6B --max-model-len 8192 --enforce-eager
主要报错内容:
loc("/tmp/torchinductor_root/j7/cj7i2ufjklqjvwrzc6gp6tlzycbkjghd3ni3isd3tkv33hs7xcon.py":18:0): error: unsupported target: 'gfx906'
[rank0]:E1009 16:41:34.128000 140217662408512 torch/_inductor/runtime/triton_heuristics.py:433] [0/0] Triton compilation failed: triton_poi_fused_add_bitwise_and_bitwise_not_bitwise_or_ge_lt_mul_sub_0
报错截图如下:
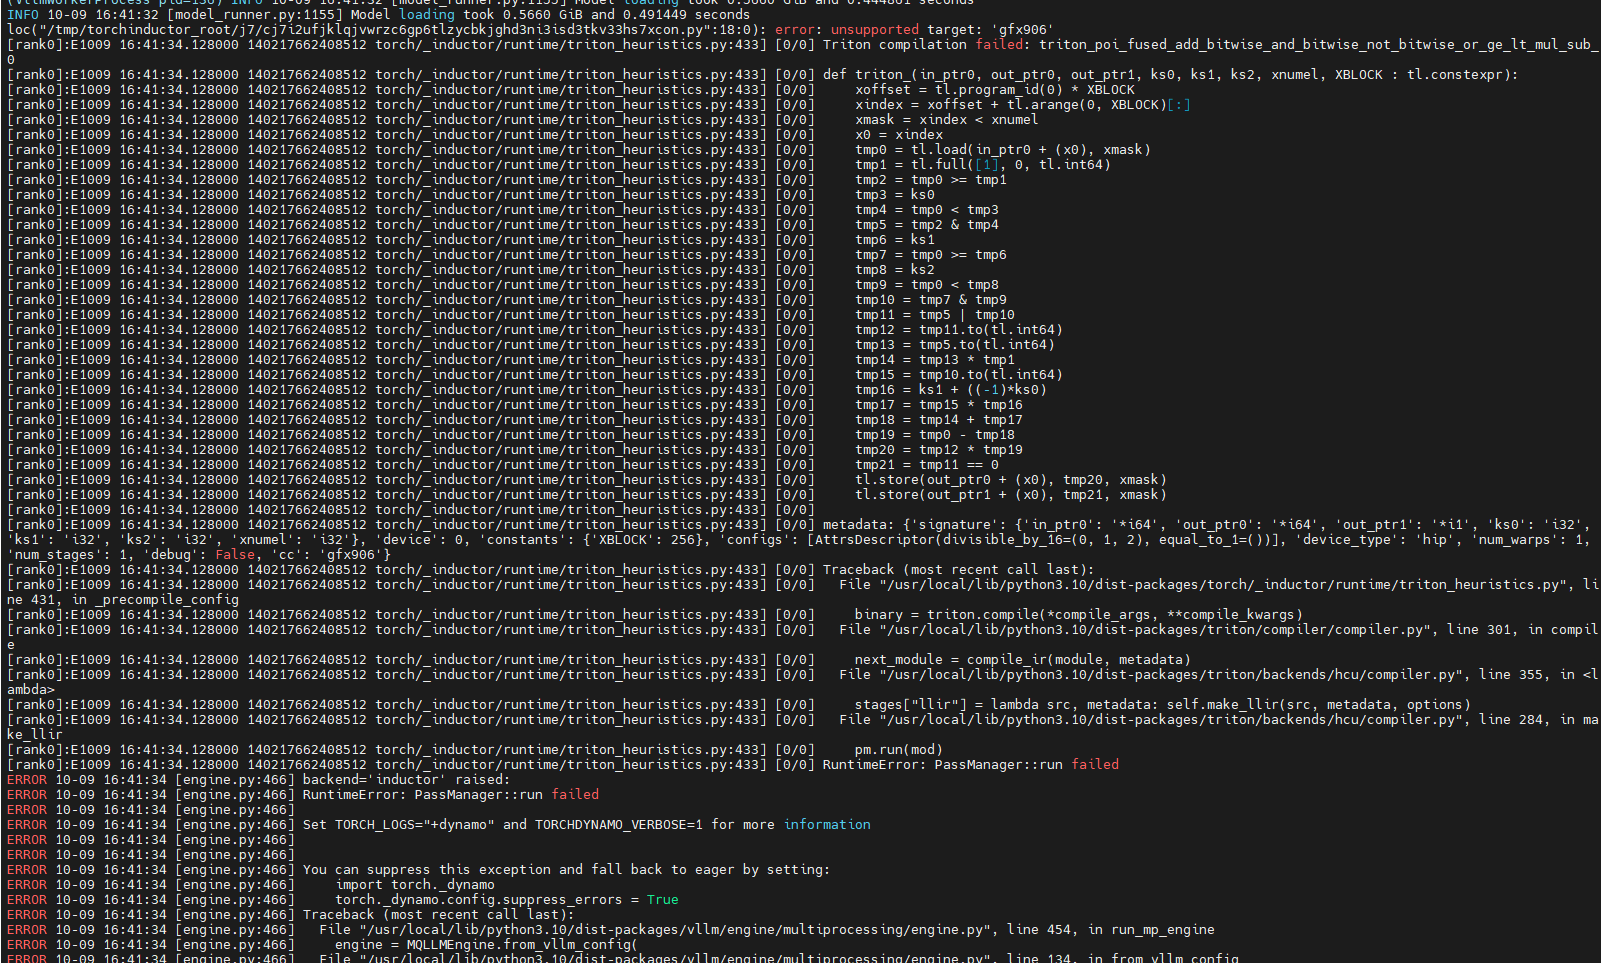
通过AI分析错误日志,结论是:
vllm 使用了Inductor 后端及其依赖的 Triton 编译器,不支持AMD GPU 硬件(架构代号 gfx906)
做过的尝试(都没有效果):
1)环境变量 export TORCH_COMPILE_BACKEND=eager
2)环境变量 export TORCH_COMPILE=0
3)启动命令增加参数 --enforce-eager
请问是否有其他方式绕过这个问题
SAM3适配
模型部署
全部评论(3)
只看楼主
S
2025/12/29
Y
Z100L上 如果用vllm085只能跑单卡dense的推理,多卡的会用到torch indcutor,这个在Z100L上没支持
2025/10/9
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据