0
0
0
0
海光 DCU 能直接跑 CUDA?底层技术大放送!
2026-07-07 11:23:07
44
引言
因工作性质决定,时常与 ISV、整机伙伴、客户及行业专家交流探索国产芯片的实践与探索。在讨论海光 DCU 如何实现平滑迁移原先基于 CUDA 编程框架开发的应用程序时,缺少一些系统性的材料,直观展示实现的技术路径、底层原理以及相关细节。
通过已有资料、自己的理解并借用 AI 工具提供的补充知识,形成了这篇文章,可以很好地解答上述问题。在深入了解底层原理和实践后,有助于用户树立了对海光 DCU 加速芯片的信心。
本文相关内容均为整理汇总所得,受限于笔者专业认知与实践深度,内容若有失实、疏漏之处,敬请各位专家同仁不吝赐教。
---
海光深算系列人工智能芯片 —— DCU(Deep Computing Unit)采用GPGPU架构,与 NVIDIA 隶属同一架构,能够实现CUDA代码平滑迁移,无需修改代码即可运行。那么,海光 DCU 是如何实现兼容 CUDA 应用程序的呢?当前,海光 DCU 兼容 CUDA 应用程序有两种可行技术路径:
方式一、通过 DTK 软件栈提供的 GPUFusion 层实现兼容
海光 DTK (DCU Toolkit) 提供面向 DCU 的开发工具链和核心数学库(如 :BLAS、FFT),提供了一套全面的 CUDA 替代方案,高效支撑上层复杂应用,全面覆盖 AI 大模型训练推理和材料、生命科学、物理仿真等领域的算法创新需求。
GPUFusion 兼容层是海光 DTK 软件栈的重要组成部分,兼容 CUDA/ROCm 双生态。最新的DTK 26.04 提供的 GPUFusion 兼容层可对标 CUDA 12.6 版本。
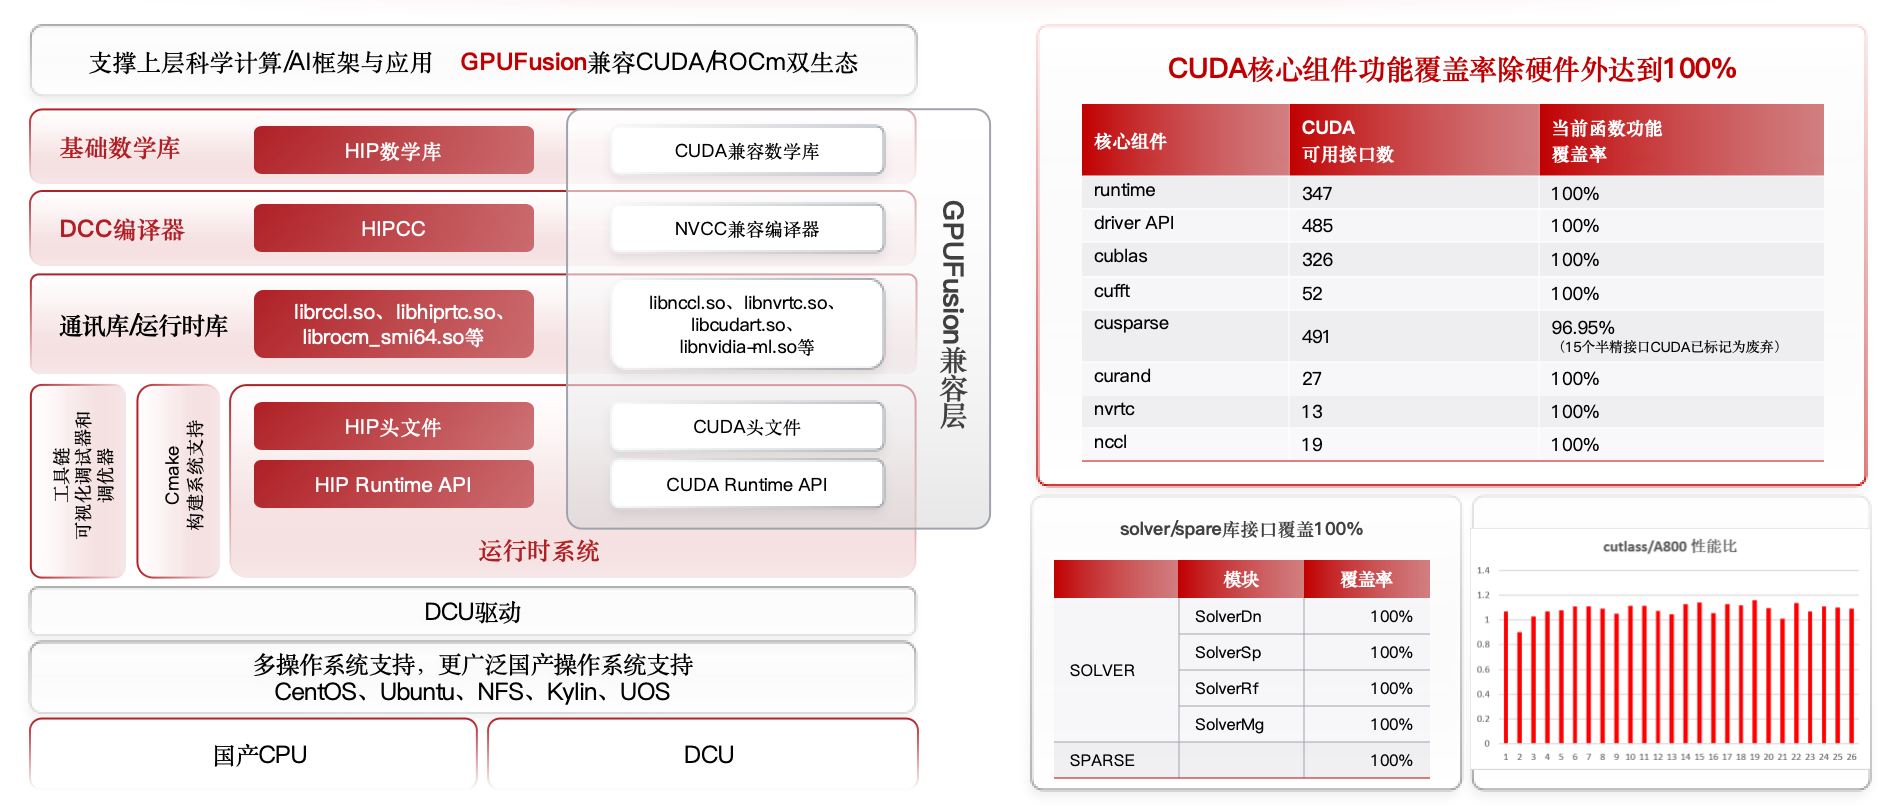
图:GPUFusion 兼容层框架图
GPUFusion 兼容层实现 CUDA 兼容属于 Runtime 运行时翻译,API 级别兼容,源码基本不用修改。底层主要从以下3个方面实现:
* API 层:拦截 cuda\_\* 调用,映射为 hip\_\*;
* 指令层:将 PTX 翻译为在海光 DCU 可执行的 HSACO (Heterogeneous System Architecture Object Code)异构系统架构目标代码);
* 性能层:通过 Kernel Fusion 抵消翻译带来的性能损耗。
|
| CUDA | 海光 DTK | | ----- | ---------------------------------------------- | ------------------------------------------- | | 上层 | cuda\_runtime.h、cudaMalloc/cudaLaunchKernel等 | hip\_runtime.h、hipMalloc/hipLaunchKernel等 | | 中层 | PTX 虚拟指令集、nvcc 编译链 | LLVM IR、hipcc/hip-clang 编译器 | | 底层 | Thread、Warp、Block、Grid | Thread、Wavefront、Block、Grid | 图:海光DTK与CUDA对应关系 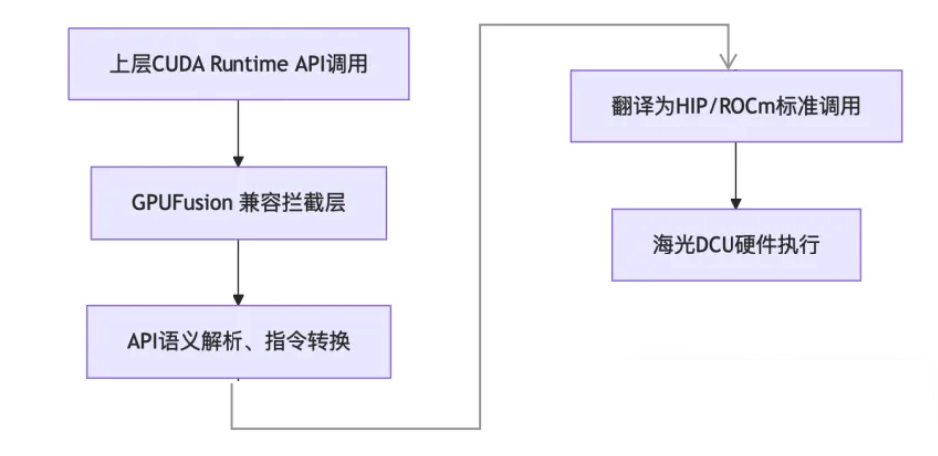 图:GPUFusion 兼容层运行原理工作流程 方式二、通过 HIPfiy 转码工具实现兼容 HIPify 转码工具的核心思想是“主动迁移”,在运行之前完成 “CUDA 代码 -> HIP 代码”的转换,即将 CUDA 源码主动转换为 DCU 原生 HIP 代码,然后再编译。 海光 DTK 软件栈内置 HIPify 自动化转译工具,包含 hipify-perl 和 hipify-clang ,其核心作用是自动扫描全部CUDA 源码文件批量将 CUDA 专属 API、数据类型、宏定义、内核调度语法一键替换为海光 DCU 兼容的 HIP 对应接口,无需人工逐行修改代码,大幅降低 CUDA 程序向海光 DCU 迁移成本。 1、工具区分与场景定位 **1)hipify-perl:轻量化脚本工具,纯文本正则替换,适配简单小型 CUDA 应用程序,处理基础 API、常量和宏转换;** **2)hipify-clang:基于 Clang 编译器前端,语法级精准解析,支持复杂模板、重载函数、头文件嵌套、多文件大型项目,转换准确率高,企业级迁移首选。** 2、API 函数替换示例 | CUDA 原生接口 | HIPify 转换后的接口 | 功能说明 | | ------------------------ | ---------------------- | -------------------- | | cudaMalloc( ) | hipMalloc() | 设备显存分配 | | cudaFree( ) | hipFree() | 释放设备显存 | | cudaMemcpy() | hipMemcpy() | 主机/设备内存互拷 | | cudaMemset( ) | hipMemset( ) | 显存批量赋值 | | cudaGetDevice( ) | hipGetDevice() | 获取当前运行设备ID | | cudaSetDevice() | hipSetDevice() | 指定运算DCU设备 | | cudaDeviceSynchronize( ) | hipDeviceSynchronize() | 同步等待设备任务完成 | | cudaStreamCreate( ) | hipStreamCreate() | 创建异步计算流 | | cudaStreamSynchronize( ) | hipStreamSynchronize() | 单流同步等待 | | cudaEventCreate( ) | hipEventCreate() | 创建性能计时事件 | | cudaEventRecord( ) | hipEventRecord() | 记录流执行时间戳 | 3、数据类型替换示例 1)设备指针类型 ``` cudaDeviceProp→ hipDeviceProp ``` 2)函数返回值枚举 ``` cudaError_t→ hipError_t ``` 3)内存拷贝方向枚举 ``` cudaMemcpyHostToDevice→ hipMemcpyHostToDevice cudaMemcpyDeviceToHost→ hipMemcpyDeviceToHost cudaMemcpyDeviceToDevice→ hipMemcpyDeviceToDevice ``` 4)流、事件句柄 ``` cudaStream_t→ hipStream_tcudaEvent_t→ hipEvent_t ``` 4、内核启动语法转换示例 ``` // 原始CUDA调用 vectorAdd<<>>(d_A, d_B, d_C, N);
// HIPify转换后(语法不变,仅头文件、底层API变更)
vectorAdd<<>>(d_A, d_B, d_C, N);
```
配套头文件自动替换
```
// 原头文件
#include
// 转换后
#include
```
5、完整代码示例
原始 cuda 代码如下:
```
#include
#include
int main() {
float* dev_ptr;
cudaError_t ret = cudaMalloc(&dev_ptr, 1024 * sizeof(float));
if(ret != cudaSuccess) {
printf("显存分配失败\n");
return -1;
}
float host_buf[1024] = {0.5f};
cudaMemcpy(dev_ptr, host_buf, 1024*sizeof(float), cudaMemcpyHostToDevice);
cudaDeviceSynchronize();
cudaFree(dev_ptr);
return 0;
}
```
通过 HIPify 转码工具之后,得到的 hip 代码如下:
```
int main() {
float* dev_ptr;
hipError_t ret = hipMalloc(&dev_ptr, 1024 * sizeof(float));
if(ret != hipSuccess) {
printf("显存分配失败\n");
return -1;
}
float host_buf[1024] = {0.5f};
hipMemcpy(dev_ptr, host_buf, 1024*sizeof(float), hipMemcpyHostToDevice);
hipDeviceSynchronize();
hipFree(dev_ptr);
return 0;
}
```
总结
无论是通过海光 DTK 软件栈提供的 HIPify 转码工具还是通过 GPUFusion 兼容层,都可以实现在海光 DCU 加速器运行 CUDA 应用程序。不同的是,HIPify 转码工具属于静态编译,即在程序运行之前完成编码;而 GPUFusion 兼容层属于运行时编译,在应用程序运行的过程中通过“拦截 CUDA API 调用 -> 翻译为 hip 对应调用 -> 返回应用程序”,整个过程对上层应用程序完全透明。
通过 HIPify 转码工具或 GPUFusion兼容层实现在海光国产 DCU 加速卡运行原先基于 CUDA 编码框架开发的应用程序是过渡阶段的手段,目的是减少不必要的重复开发、降低应用迁移难度,使用户的AI应用能够快速在海光国产 DCU 跑起来。
算力生态的壮大离不开每一位国内开发者的参与,诚邀全国开发者共筑海光国产算力软件生态,以 DTK 编程框架为基础开展 DCU 原生应用开发,摆脱 CUDA 程序迁移适配带来的繁琐改造与性能损耗。期待各界开发者同心聚力,打造一批自主可控、性能顶尖的原生算力应用,早日实现国产算力软件比肩国际一流水平。
| CUDA | 海光 DTK | | ----- | ---------------------------------------------- | ------------------------------------------- | | 上层 | cuda\_runtime.h、cudaMalloc/cudaLaunchKernel等 | hip\_runtime.h、hipMalloc/hipLaunchKernel等 | | 中层 | PTX 虚拟指令集、nvcc 编译链 | LLVM IR、hipcc/hip-clang 编译器 | | 底层 | Thread、Warp、Block、Grid | Thread、Wavefront、Block、Grid | 图:海光DTK与CUDA对应关系  图:GPUFusion 兼容层运行原理工作流程 方式二、通过 HIPfiy 转码工具实现兼容 HIPify 转码工具的核心思想是“主动迁移”,在运行之前完成 “CUDA 代码 -> HIP 代码”的转换,即将 CUDA 源码主动转换为 DCU 原生 HIP 代码,然后再编译。 海光 DTK 软件栈内置 HIPify 自动化转译工具,包含 hipify-perl 和 hipify-clang ,其核心作用是自动扫描全部CUDA 源码文件批量将 CUDA 专属 API、数据类型、宏定义、内核调度语法一键替换为海光 DCU 兼容的 HIP 对应接口,无需人工逐行修改代码,大幅降低 CUDA 程序向海光 DCU 迁移成本。 1、工具区分与场景定位 **1)hipify-perl:轻量化脚本工具,纯文本正则替换,适配简单小型 CUDA 应用程序,处理基础 API、常量和宏转换;** **2)hipify-clang:基于 Clang 编译器前端,语法级精准解析,支持复杂模板、重载函数、头文件嵌套、多文件大型项目,转换准确率高,企业级迁移首选。** 2、API 函数替换示例 | CUDA 原生接口 | HIPify 转换后的接口 | 功能说明 | | ------------------------ | ---------------------- | -------------------- | | cudaMalloc( ) | hipMalloc() | 设备显存分配 | | cudaFree( ) | hipFree() | 释放设备显存 | | cudaMemcpy() | hipMemcpy() | 主机/设备内存互拷 | | cudaMemset( ) | hipMemset( ) | 显存批量赋值 | | cudaGetDevice( ) | hipGetDevice() | 获取当前运行设备ID | | cudaSetDevice() | hipSetDevice() | 指定运算DCU设备 | | cudaDeviceSynchronize( ) | hipDeviceSynchronize() | 同步等待设备任务完成 | | cudaStreamCreate( ) | hipStreamCreate() | 创建异步计算流 | | cudaStreamSynchronize( ) | hipStreamSynchronize() | 单流同步等待 | | cudaEventCreate( ) | hipEventCreate() | 创建性能计时事件 | | cudaEventRecord( ) | hipEventRecord() | 记录流执行时间戳 | 3、数据类型替换示例 1)设备指针类型 ``` cudaDeviceProp→ hipDeviceProp ``` 2)函数返回值枚举 ``` cudaError_t→ hipError_t ``` 3)内存拷贝方向枚举 ``` cudaMemcpyHostToDevice→ hipMemcpyHostToDevice cudaMemcpyDeviceToHost→ hipMemcpyDeviceToHost cudaMemcpyDeviceToDevice→ hipMemcpyDeviceToDevice ``` 4)流、事件句柄 ``` cudaStream_t→ hipStream_tcudaEvent_t→ hipEvent_t ``` 4、内核启动语法转换示例 ``` // 原始CUDA调用 vectorAdd<<
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据