请问这个镜像是在哪些找的,在https://developer.sourcefind.cn/servicelist下面没有啊
0
0
0
0
qwen3.5-35b-a3b 死循环,不输出。
2026-04-23 15:47:41
410
基础:
k100-ai显卡 64*8
镜像:harbor.sourcefind.cn:5443/dcu/admin/base/custom:vllm018-ubuntu22.04-dtk26.04-gemma4-0413
环境变量:export HIP_VISIBLE_DEVICES=0,1
export HSA_FORCE_GRAIN_PCIE=1
export VLLM_RPC_TIMEOUT=1800000
export ALLREDUCE_STREAM_WITH_COMPUTE=1
export NCCL_MIN_NCHANNELS=16
export NCCL_MAX_NCHANNELS=16
export NCCL_P2P_LEVEL=SYS
export NCCL_LAUNCH_MODE=GROUP
export VLLM_WORKER_MULTIPROC_METHOD=spawn
export VLLM_ATTENTION_BACKEND=FLASHINFER
export HSA_ENABLE_SDMA=0
export VLLM_USE_OPT_SPLIT=1
启动命令:vllm serve /workspace/models/Qwen3.5-35B-A3B
--host 0.0.0.0
--port 8102
--trust-remote-code
--dtype float16
--tensor-parallel-size 2
--disable-custom-all-reduce
--gpu-memory-utilization 0.8
--max-model-len 60000
--served-model-name Qwen3.5-35B-A3B
--api-key 'xxxx@2026'
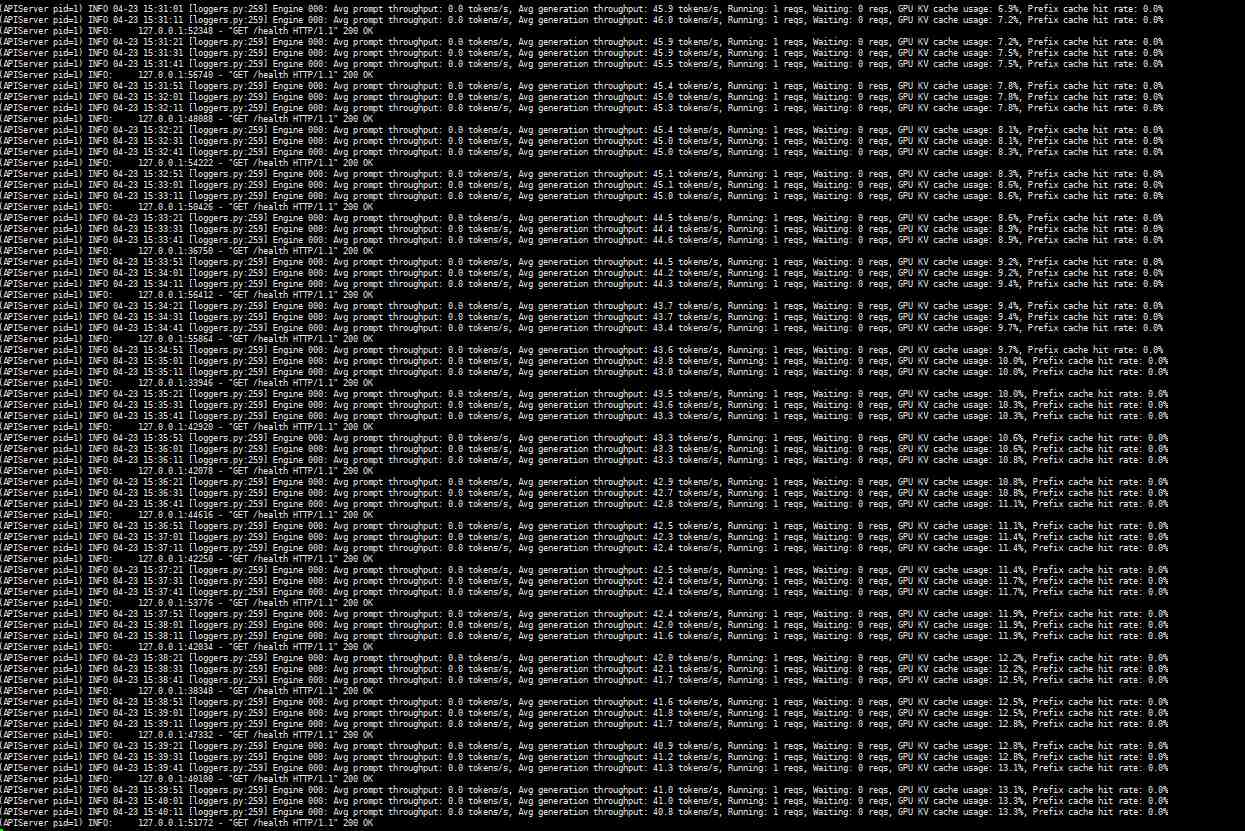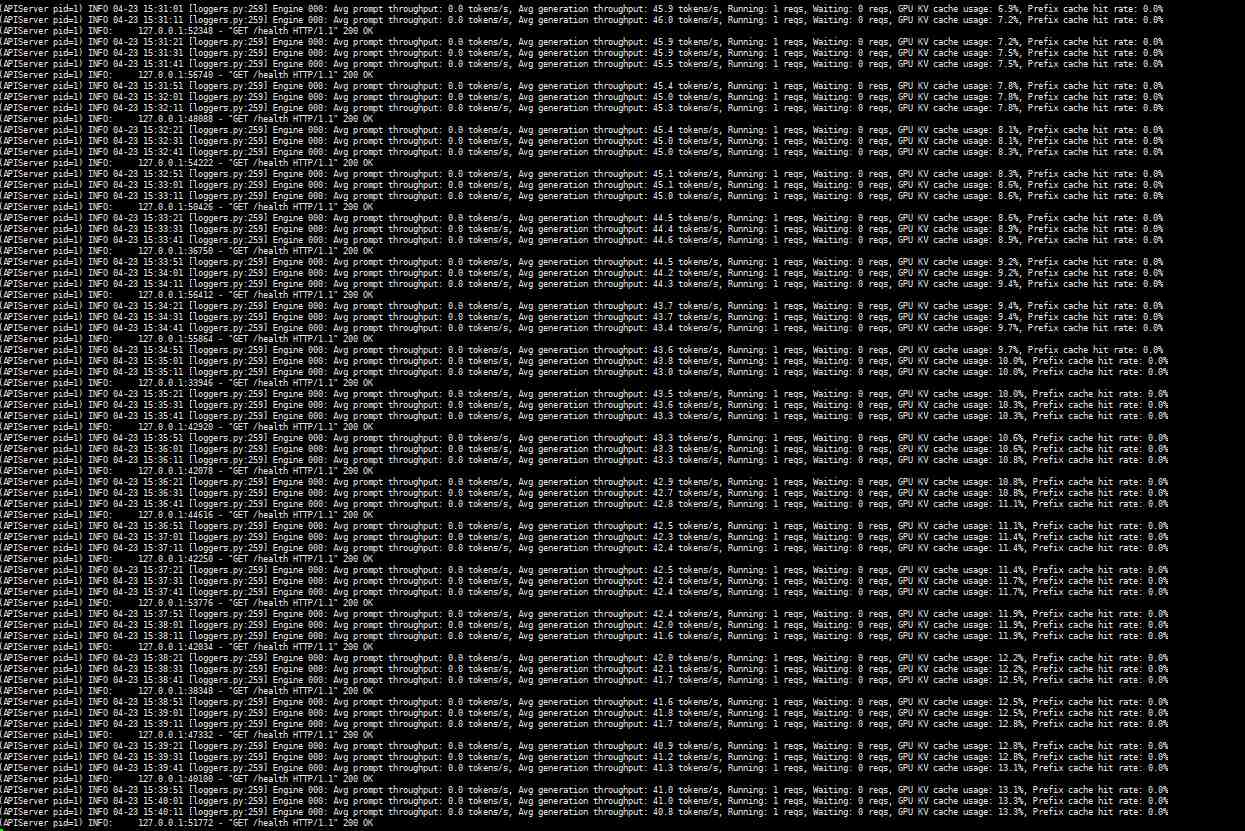
第一个:token输出时40tokens/s,但是返回内容非常少,并且无深度思考;
第二个:顺序请求,代码里面第一个请求结果拿到后,马上调用第二次,第二次调用就会陷入如上图所示的死循环,ai搜索,就提示海光不支持多卡部署;
第三个:并发请求,五个并发请求,会有一个任务挂起,另外4个任务能成功;
求解:是不是目前的镜像部署后根本无法满足开发使用?海光的售后工程师感觉也是懵逼的。根本说不出一二三。乱踢皮球;啥问题都解决不了;
全部评论(11)
只看楼主
H
4/24
K
和你用同一种镜像,发现送小图片识别(小于1000X1000像素的)就会流式返回一堆“!!!!!” 感叹号,送大图片识别就不会有这个问题,如果用claude code在这个情况下按esc键就能看到很多感叹号返回的。
4/23
Y
vllm-018镜像不需要加环境变量,也不用 --disable-custom-all-reduce 参数,重新修改后启动试试。
4/23
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据