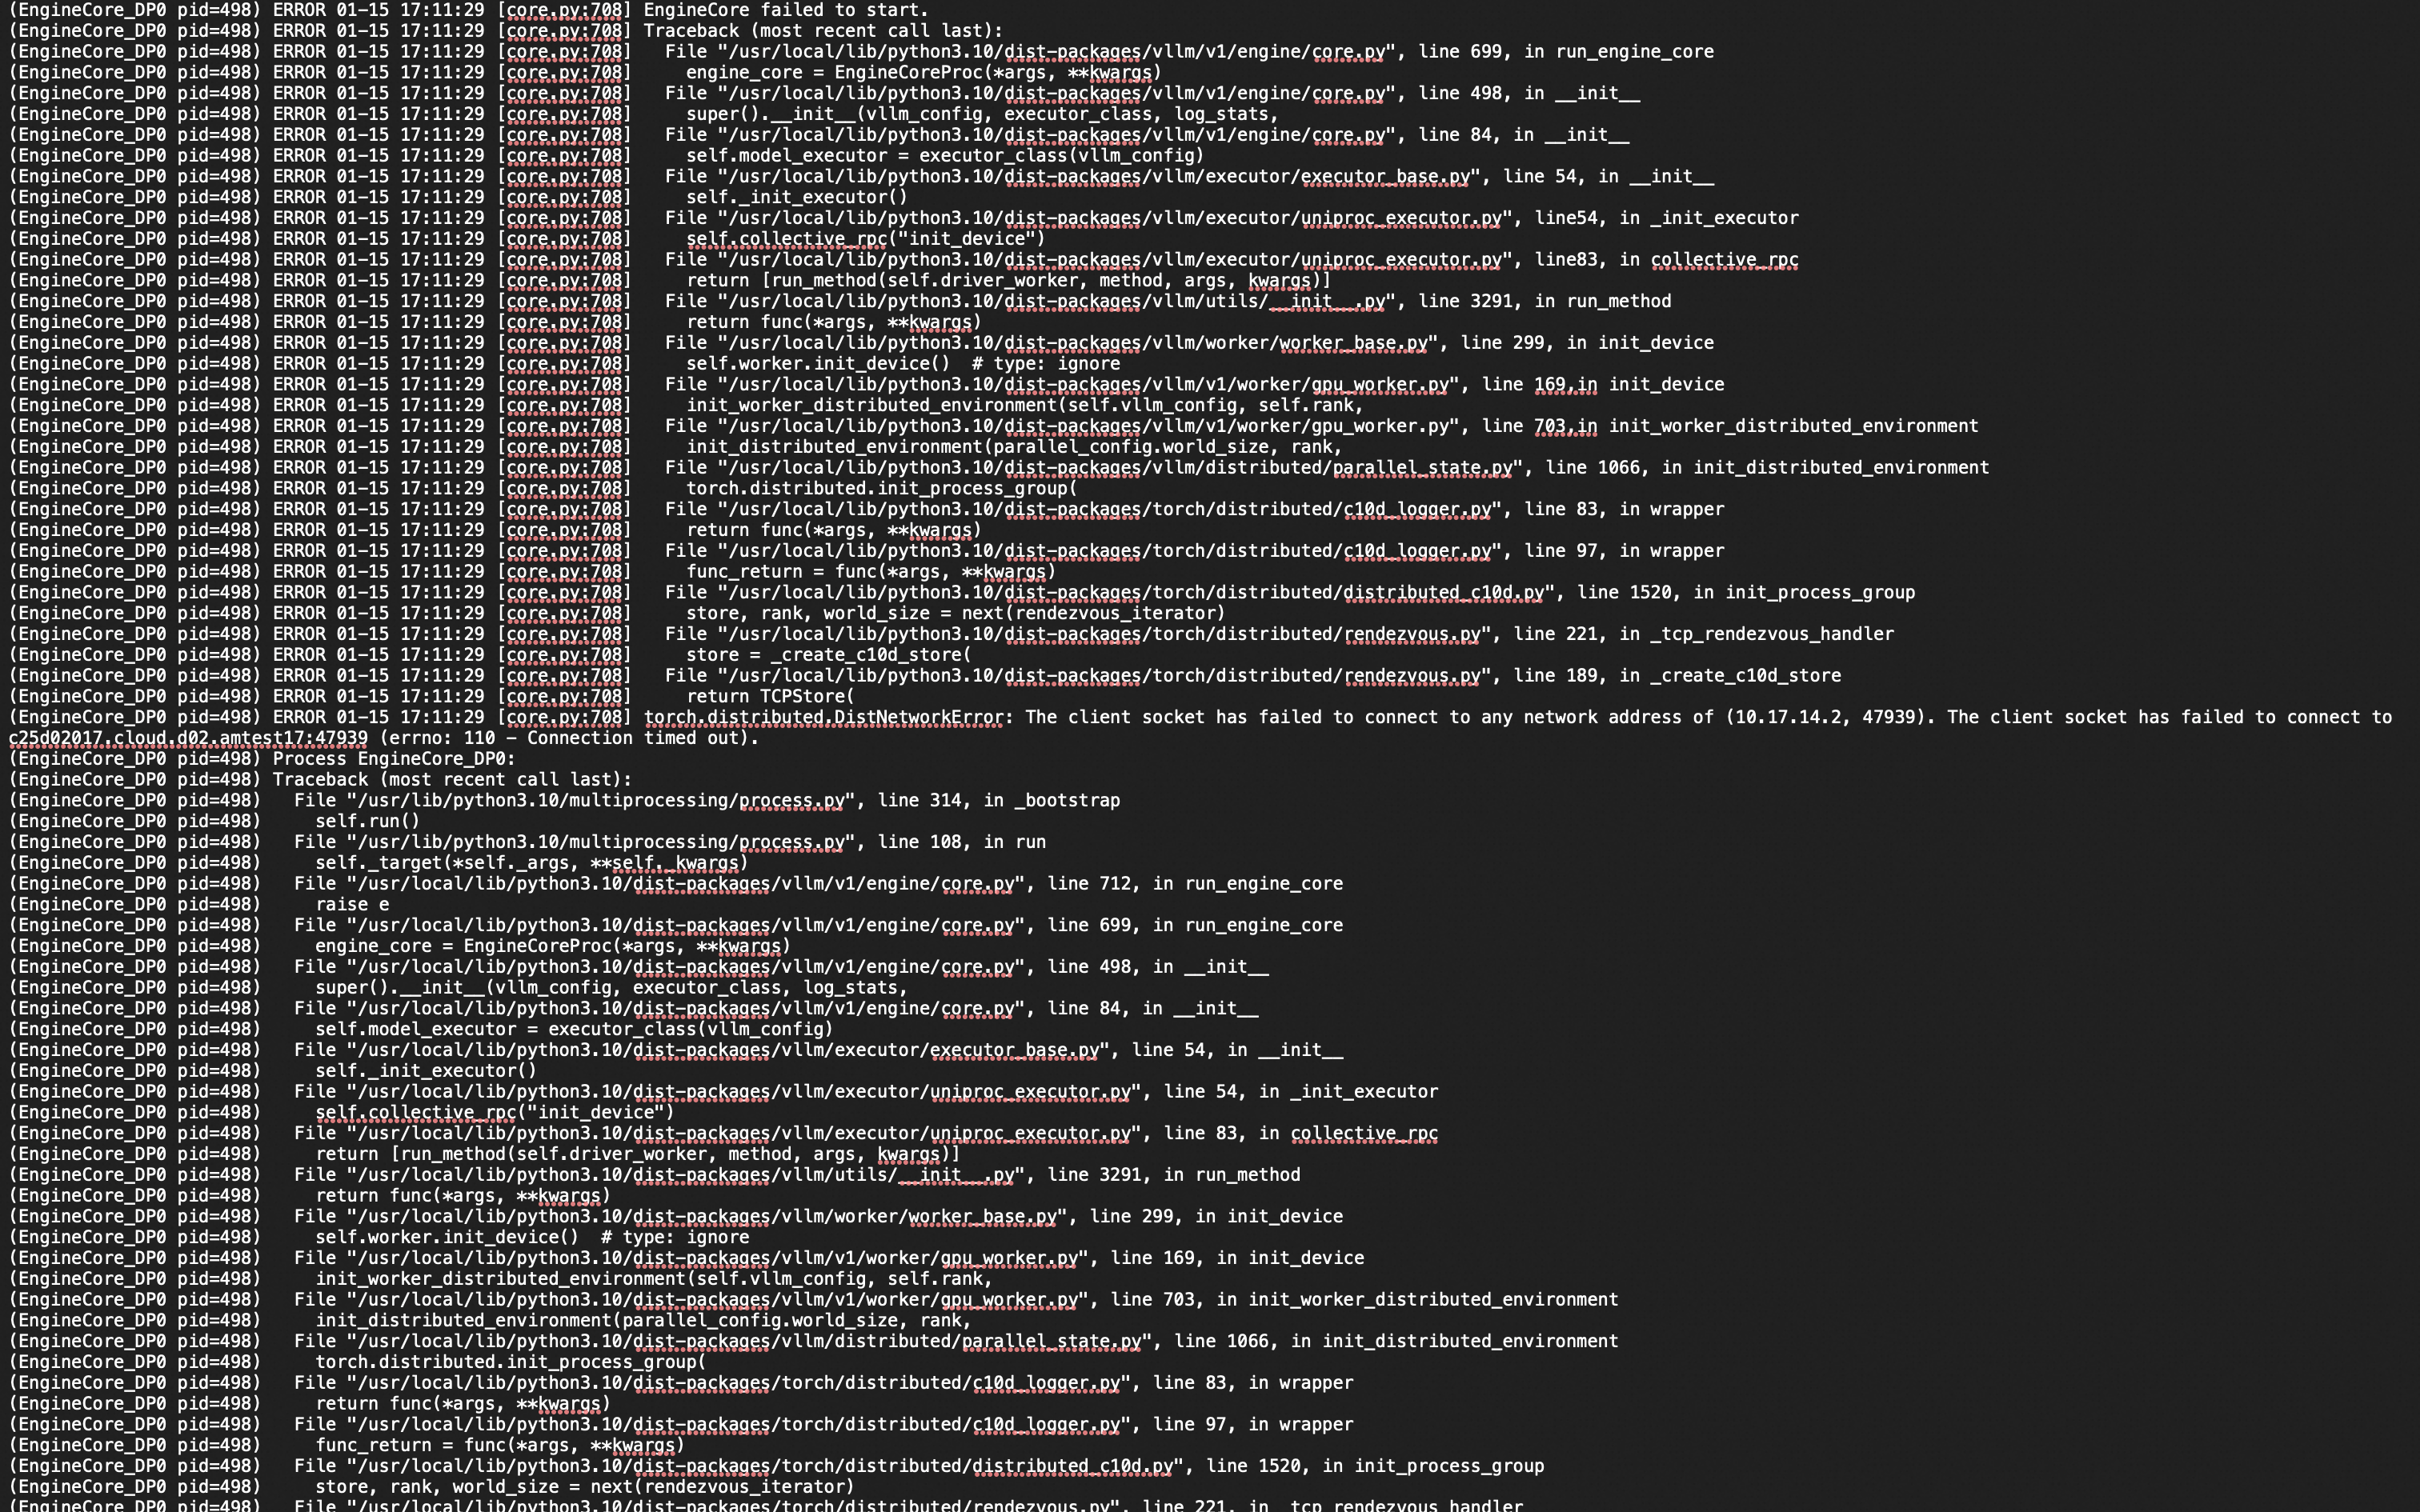
你好,请问一下你的容器启动命令是什么?我在BW1000上用同样的镜像启动qwen3-embedding,结果报错了,报错内容如图
0
0
0
0
vllm0.11.0推理Qwen3-Next-80B-A3B-Instruct出现精度问题
2025-12-29 14:43:56
585
机器:BW1000
使用镜像:0.11.0-ubuntu22.04-dtk25.04.2-1226-das1.7-py3.10-20251226
启动命令:
export VLLM_USE_NN=0
export TRITON\_MOVE\_LOAD\_TOFRONT\_DOT=0
vllm serve /home/ccw/models/Qwen3-Next-80B-A3B-Instruct/ --dtype float16 --port 8001 --served-model-name Qwen3-Next-80B-A3B-Instruct --trust-remote-code -tp 8 --max-model-len 262144 --enable-prefix-caching --block-size 64 --trust-remote-code --gpu-memory-utilization 0.95 --disable-log-stats --compilation-config '{"full\_cuda\_graph": true}'
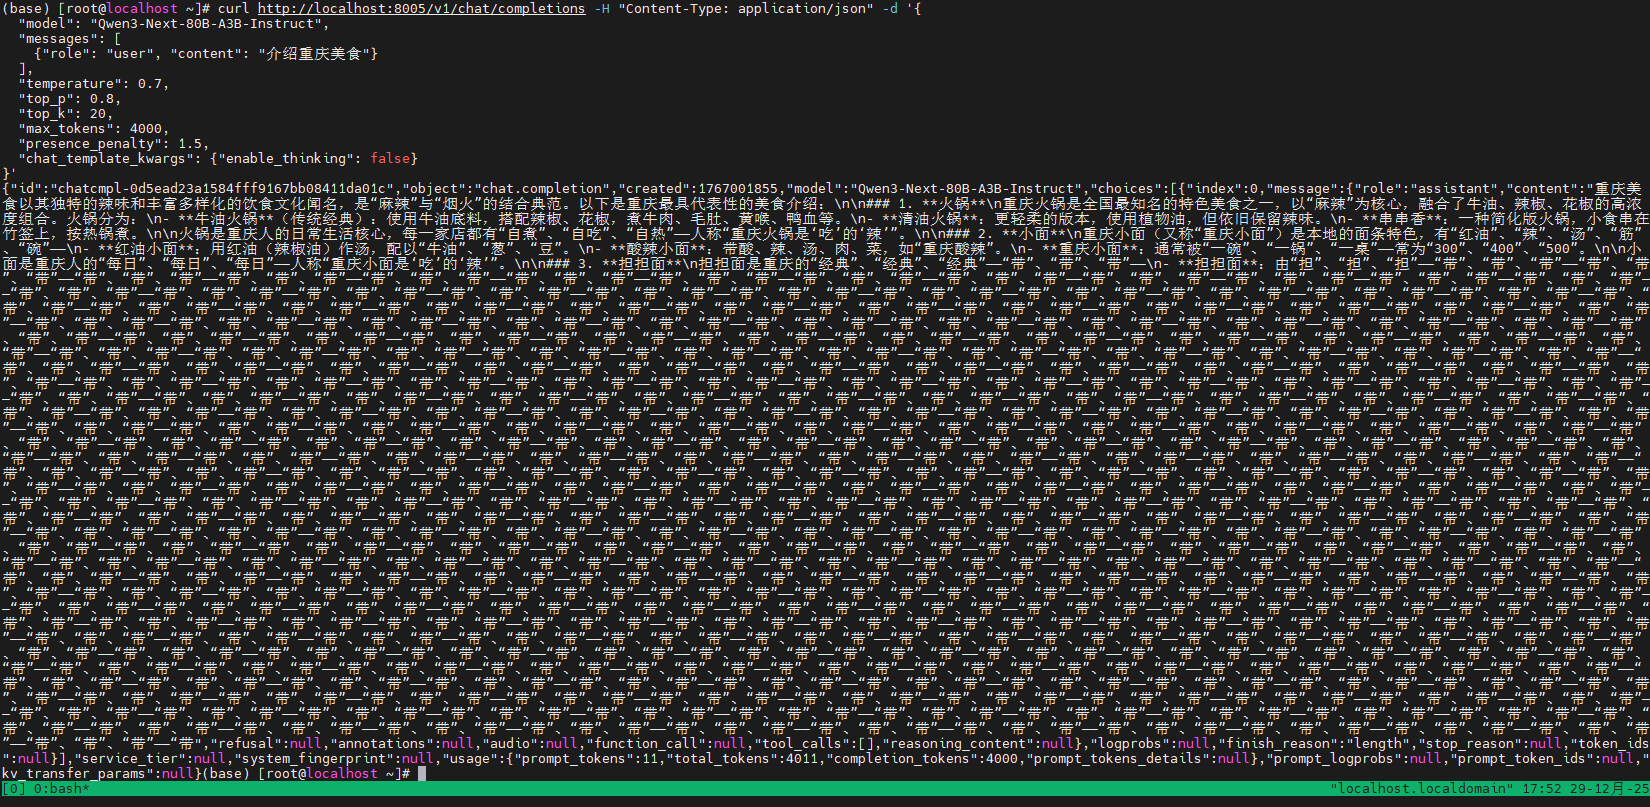
出现回答精度问题:
输入:长沙美食推荐

全部评论(7)
只看楼主
T
1/16
Y
这个问题不太好排查,正在排查分析中,解决后会第一时间更新回复
1/5
狂
2025/12/29
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据