大佬,解决了吗,我也遇到了同样的问题
1
0
0
0
Qwen3.5-122B的模型,开启4卡并行推理速度特别慢
2026-07-14 01:25:22
259
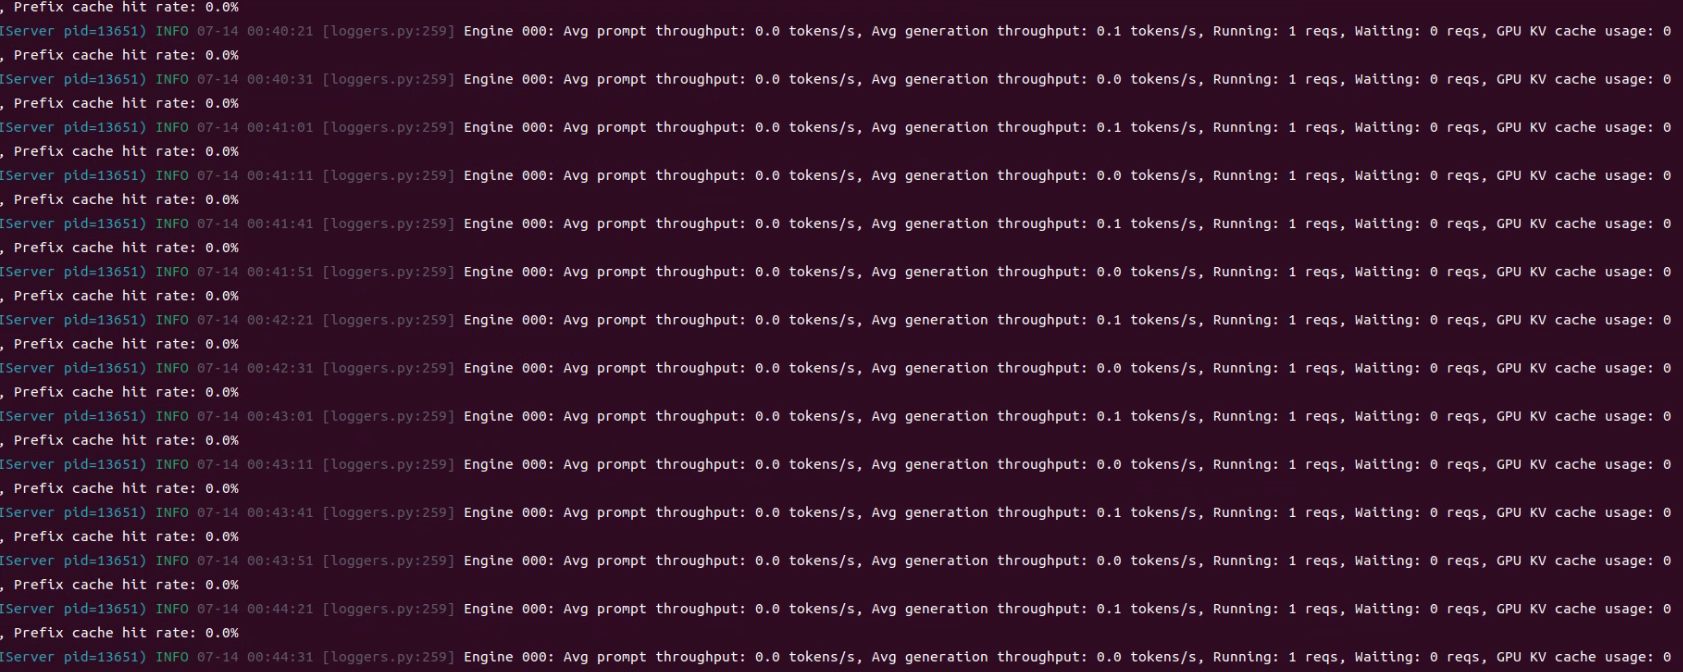
Qwen3.5-122B的模型,开启4卡并行推理速度特别慢,我尝试qwen3.6-27B 单卡跑至少还能跑出token 速度差不多 8t/s,只要开了多卡就跑不出token,不管是双卡 还是4卡,整了好多天,试了很多命令和镜像,都是有问题,目前只有一个qwen3.6-8B-embedding模型是可以的(因为他是单卡跑的) 官方求助一下。
vllm版本镜像:harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.18.1-ubuntu22.04-dtk26.04-py3.10
其他镜像我都用了,都是一样的问题
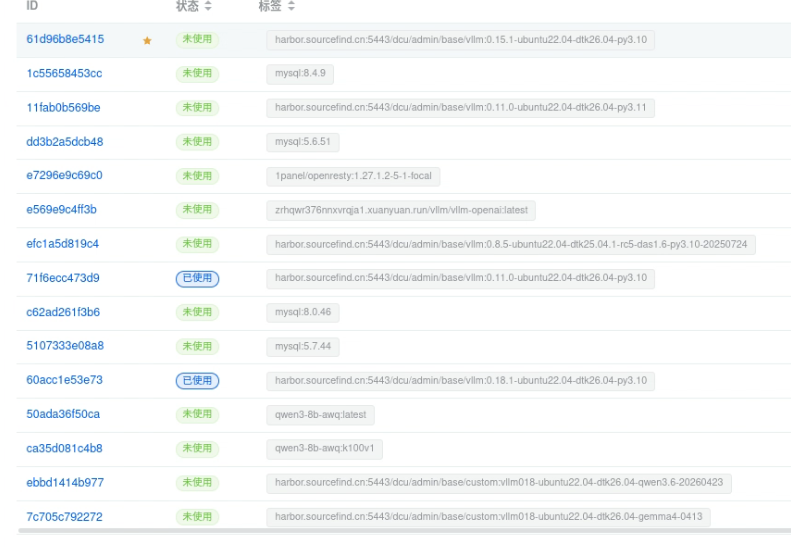
环境参数:
export VLLM_PCIE_USE_CUSTOM_ALLREDUCE=1
expoert VLLM_HCU_USE_CUSTOM_QUANTIZATION_GEMM=0
export HIP_VISIBLE_DEVICES=4,5,6,7
export ALLREDUCE_STREAM_WITH_COMPUTE=1
启动命令
numactl -N 0 -m 0 vllm serve /ai/Qwen3___5-122B-A10B-GPTQ-Int4 --port 8001 --trust-remote-code --dtype float16 --quantization gptq --tensor-parallel-size 4 --gpu-memory-utilization 0.85 --max-model-len 8192 --default-chat-template-kwargs '{"enable_thinking": false}' --reasoning-parser qwen3 --enable-auto-tool-choice --served-model-name Qwen3.5-122B-A10B --max-num-batched-tokens 4096 --tool-call-parser qwen3_coder
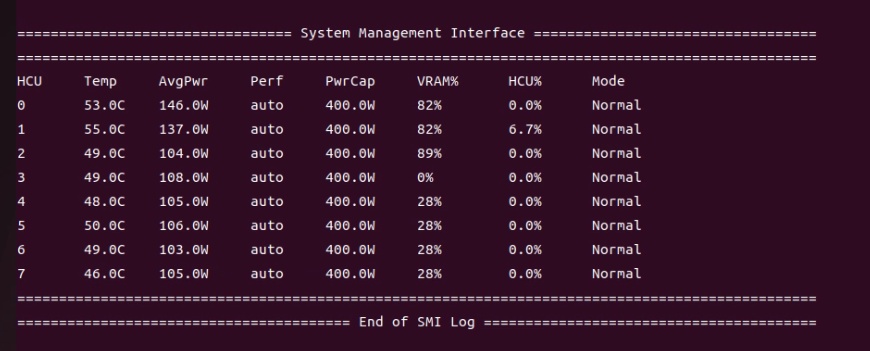
rocm-smi
全部评论(5)
只看楼主
空
7/31
M
可以参考https://github.com/HYGON-AI/dcu-inference-cookbook/blob/main/docs/model-deployment/vllm/qwen3.5.md跑下多卡的模型试试,看着是卡间通信问题
7/14
没有更多内容了
--
楼主
0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据