系列第一篇 · 硬件架构 本系列共三篇:①硬件架构 → ②编程与优化基础 → ③Qwen3.5 推理优化实战 本文面向零基础读者,不预设 GPU 或并行编程经验。所有概念都会从头解释。
引言
要在一块加速卡上写出高性能的程序,前提是理解这块卡是怎么组织起来的。加速卡的性能特征与 CPU 差异极大:很多在 CPU 上天经地义的写法,搬到加速卡上会慢得离谱;而加速卡上的性能瓶颈,也往往出现在初学者意想不到的地方。
本文从最基本的问题讲起——为什么需要加速卡——然后自外向内,逐层拆解海光 DCU 的硬件架构:从它在整个计算机系统中的位置,到卡内部的计算单元、存储层次,再到多卡、多节点的互连方式,最后介绍配套的软件栈。
阅读本文不需要任何 GPU 编程基础。文中出现的每一个术语,都会在首次出现时解释清楚。
第一章 为什么需要 DCU:异构计算的基本思路
1.1 CPU 与加速器的分工
现代计算机系统中,CPU 是通用处理器,它的设计目标是把单个任务尽可能快地完成。为此,CPU 投入了大量晶体管去做分支预测、乱序执行、多级大容量缓存——这些机制的共同目的,是降低单条指令流的延迟。
代价是:这些复杂的控制逻辑很占面积,所以 CPU 上能放下的计算核心并不多,通常只有十几个。
但有一类任务的特征完全不同:它们的计算量巨大,却高度并行——同一套运算要在海量数据上重复执行,而且彼此独立。典型的例子是矩阵乘法、图像处理、物理仿真、深度学习。对这类任务,CPU 那套"把单个任务做快"的思路收益有限,更有效的做法是同时开动成百上千个简单的核心一起算。
这就是加速器存在的意义。DCU(Deep Computing Unit)正是这样一款加速器:它通过 PCI-E 总线与 CPU 相连,作为主机系统的一个硬件扩展存在,目的是为程序中某些模块或函数提供加速。
于是形成了异构计算的基本分工:
- CPU 负责逻辑控制、数据处理、与外部世界交互,以及调度 DCU;
- DCU 负责计算密集、高度并行的部分。
值得注意的是,DCU 虽然接受 CPU 的调度指挥,但在运行程序时保持相对独立——它有自己的计算单元、内存控制器、线程调度器,硬件构造相当完整,可以视为一个独立的小系统。
此外,一台主机的 PCI-E 总线上可以插入多张 DCU,这使得一台主机的算力具有可扩展性;合理利用多 DCU 的程序可以获得更好的加速效果。
1.2 两种截然不同的"并行"
这是理解 DCU 最关键的一个观念,必须在一开始就澄清。
CPU 也能"并行"——你可以在一颗 CPU 上开出几百个线程。但这是一种假象:当运行的线程数多于物理核心数时,CPU 依靠时间片轮换,让每个线程轮流获得计算资源,给人一种众多线程同时运行的错觉。任一时刻,真正在跑的线程数不超过核心数。
DCU 的并行则是真正的众核同时并发:所有线程都会被分配到真实的计算核心(ALU)上,是物理意义上的同时执行。
这个差别的根源在数量:
| 计算核心数量 | 并行方式 | |
|---|---|---|
| CPU | 通常十几个 | 时间片轮换(逻辑并行) |
| DCU | 数百到数千个 | 众核同时并发(物理并行) |
一块 DCU 卡上可以有几千个流处理单元,因此 DCU 也被称为流处理器。核心数量决定了吞吐能力:只要任务具有足够的并行性,DCU 就能更快地完成它。
反过来说,如果一个任务本质上是串行的、或者充满复杂的依赖与分支,那它就不适合 DCU——这类任务应该留给 CPU。
这一硬件特点决定了:DCU 适合做计算密集型任务,CPU 负责数据处理以及与外部交互的任务。
第二章 DCU 整体硬件架构
2.1 DCU 的组成
下图展示了 DCU 的整体架构。图中左侧是一块 DCU(DCU #0)的内部结构,右侧表示同一条 PCI-E 总线上还可以挂接多块 DCU。
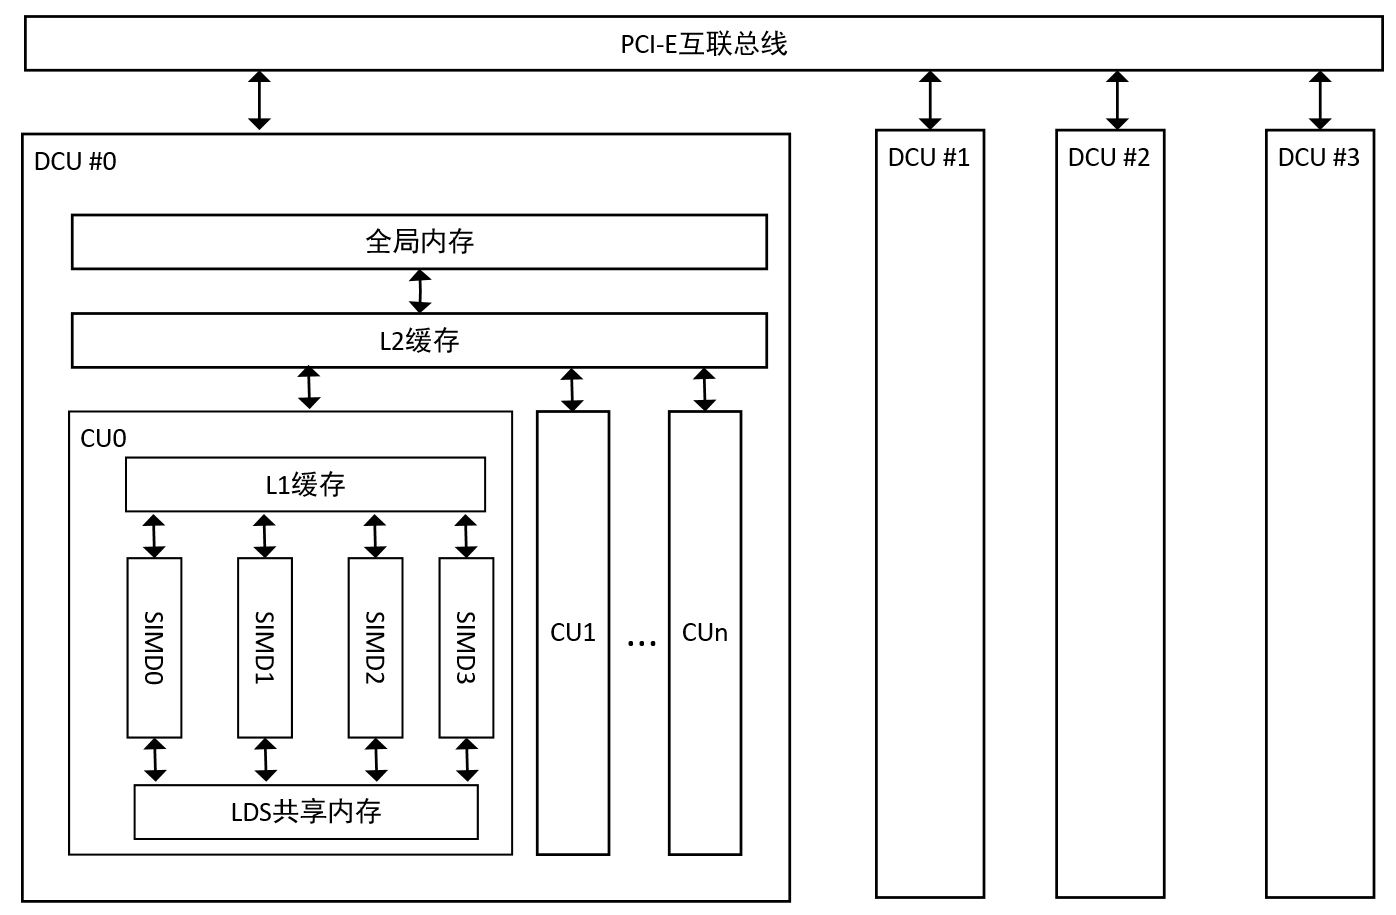
图 2-1 DCU 架构逻辑图
从图中可以看到,DCU 由以下几个关键模块组成:
- 计算单元阵列:图中的 CU0、CU1 …… CUn;
- 缓存系统:L1 一级缓存、L2 二级缓存;
- 全局内存(global memory);
- CPU 和 DCU 数据通路(DMA)。
DCU 内部有很多个计算单元(Compute Unit,简称 CU)。每个 CU 又包含 4 个 SIMD 单元,每个 SIMD 单元里则有很多加、减、乘等流式计算部件。这些部件层层累加,构成了一块卡上数以千计的流处理单元。
CU 的内部结构是本文第三章的重点,这里先建立整体印象。
2.2 缓存系统:透明,但不能忽视
DCU 拥有相对完整的 cache(缓存)系统:
- 每个 CU 有自己的 L1 cache(私有);
- L2 cache 是全局一致的(所有 CU 共享,并保证数据一致性)。
缓存的作用是数据重用:当同一份数据被反复访问时,它可以留在离计算单元更近的缓存里,避免每次都去远处的全局内存取。这减少了开发者手动控制数据搬运的难度,提升了开发效率。
需要强调的是:cache 对用户是编程透明的——你不需要写代码去管理它,硬件会自动完成。但"不需要管"不等于"可以忽视":在做极致性能优化时,缓存命中率对性能的影响可以超过 50%。因此在优化阶段,仍需要通过调整数据排布、访问顺序等方法来提升命中率。
2.3 全局内存:容量最大,但距离最远
DCU 有独立于主机内存的全局内存单元,用于存储 CU 计算时要访问的数据。
为满足高吞吐需求,它采用相对高速的存储介质。作为对比:普通显卡常采用 GDDR 内存,带宽可达 500 GB/s;而 DCU 可支持更为先进的 HBM2 存储,单卡容量可达 16 GB 以上,最高带宽可达 1 TB/s。
这里有一个关键的物理事实必须记住:全局内存是 DCU 上的片外存储。
所谓"片外",是指它位于计算单元阵列的外面。而在芯片设计中有一条朴素的规律:距离计算单元越远,存储延迟越高。
所以全局内存虽然是 DCU 上空间最大的存储,但它的延迟也相对最高。这导致了一个初学者常常预料不到的结论:
DCU 程序的瓶颈,往往不在于计算,而在于数据读取。
这个判断会贯穿整个系列。加速卡上摆着几千个计算核心,算力通常不是短板;真正卡住程序的,是数据从全局内存搬到计算单元的这段路。因此,如何优化全局内存的访问,是 DCU 编程中最值得思考的问题之一。
2.4 DMA:让传输与计算并行
DMA(Direct Memory Access,直接内存访问)的作用,是把"数据传输控制"与"指令执行控制"分离开。
它的工作方式是这样的:当 CPU 接到"把数据拷贝到 DCU"的指令时,并不需要自己一直盯着这个过程——DMA 单元会接管这次传输。CPU 交出控制权后即可继续执行后续指令;与此同时,在 DCU 一侧,DMA 控制的数据传输也不会中断正在进行的计算过程。
DCU 中共有两个 DMA 控制单元,分别管理 CPU 与 DCU 之间、以及 DCU 与 DCU 之间的数据传输。
使用 DMA 时有一点必须注意:DMA 传输不能保证你读取数据时,数据一定已经传输完毕。因此在应用中需要通过查询传输是否完成,来保证数据使用的安全性。
合理使用 DMA(让数据传输与计算重叠进行)可以显著提高程序的并行度。
2.5 CPU 与 DCU 的互连通路
DCU 上另一个重要组件,是 CPU 与 DCU 之间的互连通路。
当前 CPU 和 DCU 之间通过 PCI-E 互连,双向最高带宽可达 28 GB/s。DCU 之间也支持快速互连。DMA 引擎负责 CPU↔DCU、DCU↔DCU 的数据搬迁工作。
此外,DCU 上还有相对完整的存储页表管理系统,可以实现 DCU 直接访问 CPU 地址上的数据。
这里值得把两个带宽数字放在一起看,因为它们的差距决定了一条重要的编程原则:
| 通路 | 带宽量级 |
|---|---|
| 全局内存(HBM2,片上) | 最高可达 ~1000 GB/s |
| PCI-E(CPU ↔ DCU) | 最高 ~28 GB/s |
两者相差三十倍以上。这意味着:把一份数据从主机内存搬到 DCU,其代价远远高于在 DCU 内部反复读取同样大小的数据。由此得出异构编程的一条基本原则:
尽量减少主机与设备之间的数据搬运;必须搬运时,尽量让它与计算重叠。
2.6 互连技术的发展趋势
随着节点内互连技术的快速发展,出现了 xGMI、NVLink、CXL 等快速互连技术。CPU 和 DCU 的融合趋势越来越明显,已经可以实现 CPU 和 DCU 之间的 cache 一致性访问。业界预计,在未来 3–5 年内,有可能实现 CPU 和 DCU 在存储编程上的统一。
届时,上一节提到的那道"PCI-E 悬崖"会显著平缓,异构编程的心智负担也会随之下降。
第三章 DCU 核心架构:计算单元 CU
计算单元 CU 是贯穿 DCU 架构的核心部件,也是开发者直接操控的对象。本章逐一拆解它的内部构造。
下图是 CU 的架构逻辑图(为简化起见,图中只画出了关键部件):
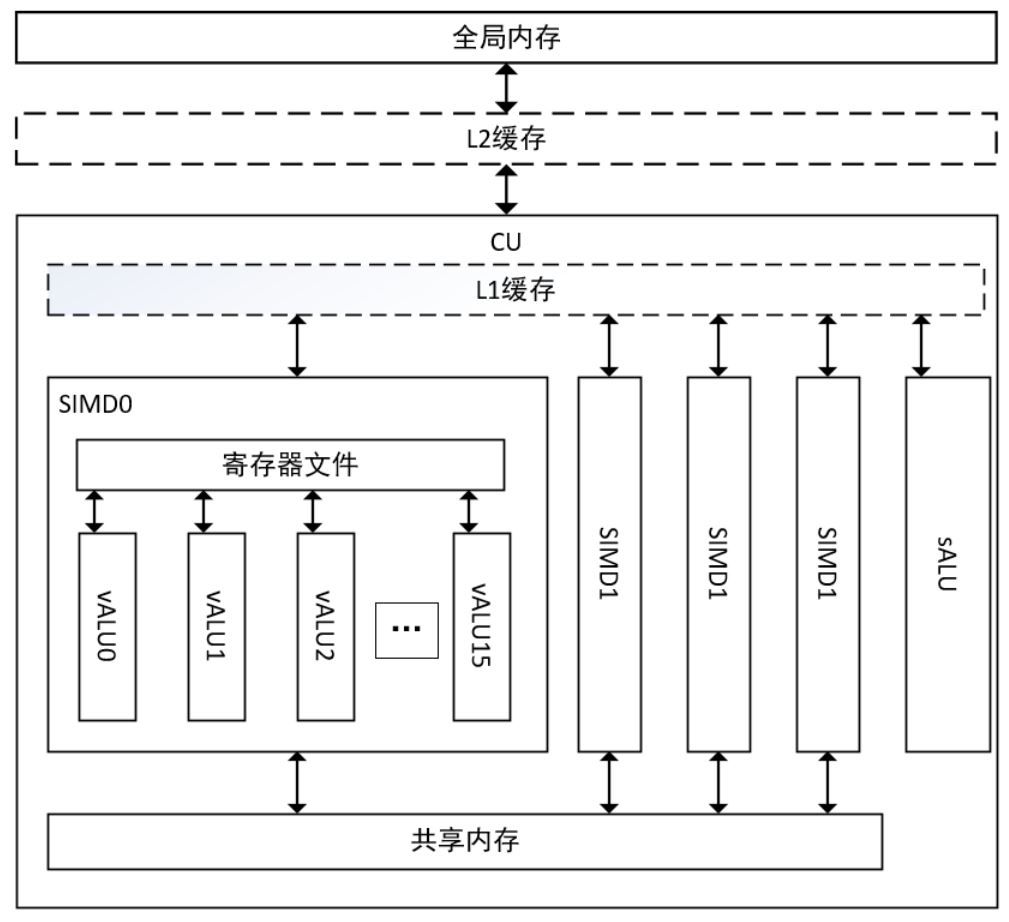
图 2-2 DCU 核心架构逻辑图
一个 CU 包含:
- 4 个 SIMD 单元(图中 SIMD0 ~ SIMD3);
- 每个 SIMD 内含多个矢量计算单元(vALU,DCU2 上是 16 个)与一个寄存器文件;
- 一个被多个 SIMD 共用的标量计算单元(sALU);
- 一块 共享内存(LDS);
- 一个私有的 L1 缓存。
3.1 什么是 SIMD
SIMD 是 Single Instruction / Multiple Data 的缩写,意为"单指令、多数据"。
它描述的是这样一种执行模式:一条指令,同时作用在多个数据上。举例来说,如果你要把 64 个数字各自加 1,CPU 的传统做法是循环 64 次、执行 64 条加法指令;而 SIMD 的做法是发射一条加法指令,让 64 个数据同时完成加 1。
SIMD 是 CU 的计算核心部件,每个 CU 包含 4 个 SIMD。这种"一条指令喂饱一大批数据"的模式,正是 DCU 能提供极高吞吐的根本原因——它省下了大量重复的取指、译码开销,把晶体管都用在了真正的计算上。
同时这也解释了 DCU 的适用边界:SIMD 擅长的是"对大量数据做同样的事"。如果你的数据各自需要做不同的事,SIMD 的优势就发挥不出来。
3.2 wavefront:线程是成组调度的
在 DCU 上,线程不是一个一个被调度的,而是打包成组。这个组叫做 wavefront。
关键参数:
每个 SIMD 有 10 个 wavefront,每个 wavefront 的大小是 64。 (作为对照,NVIDIA GPU 中对应的概念叫 warp,大小是 32。)
也就是说,64 个线程被绑成一束,一起被调度、一起执行同一条指令。这是 SIMD 模式在硬件调度层面的直接体现。
理解 wavefront = 64 这个数字,有三个实际影响:
第一,线程数量最好是 64 的整数倍。 如果你启动了 65 个线程,硬件会分配 2 个 wavefront(128 个线程槽位),其中 63 个槽位是空转的。凑不满一个 wavefront,就是在浪费执行资源。
第二,同一个 wavefront 内的线程必须走同一条指令路径。 这带来了 分支发散(branch divergence)的问题:当你的代码里出现 if (条件) { A } else { B },而同一个 wavefront 里有的线程满足条件、有的不满足时,硬件无法让它们真正同时执行两条不同的路径——只能先让满足条件的线程执行 A(其余线程闲置),再让不满足的线程执行 B(前者闲置)。两条分支被串行化了,执行时间变成两者之和。
因此在 DCU 编程中,应尽量避免同一个 wavefront 内出现分支分歧。理想情况是让分支的粒度与 wavefront 对齐——比如让整个 wavefront 都走 A,另一个 wavefront 都走 B,这样就不会串行化。
第三,跨线程的数据交换以 wavefront 为单位。 诸如求和归约这类需要线程间协作的操作,其协作范围通常就是一个 wavefront。
3.3 计算核心:矢量单元与标量单元
当 DCU 进行并行计算时,线程会被分配到计算单元 ALU 上执行,因此 ALU 是相当重要的部件。ALU 分为两类:
矢量计算单元(vALU) —— 主要用于复杂计算,也就是你程序里真正的数值运算。每个 SIMD 上有多个(DCU2 上是 16 个)。
标量计算单元(sALU) —— 主要用于地址计算、分支跳转等,被多个 SIMD 共用。
为什么要单独设计一个标量单元?原因在于:在一个 wavefront 的 64 个线程中,有相当一部分计算的结果对所有线程都是相同的。比如某个数组的基地址、某个循环的边界值、某个分支的判断条件——这些量与线程编号无关。
如果把这类计算交给矢量单元,就意味着 64 个线程各算一遍同样的结果,是 64 份重复劳动。而交给标量单元,算一次就够了,宝贵的矢量单元便可以省下来做真正的并行计算。
需要注意的是:当很多线程同时启动时,会出现同一个计算单元被多个线程共用的情况,使用时需要考虑资源的分配情况,合理地将线程进行分配。
3.4 寄存器:最快的存储,也是最紧俏的资源
寄存器是 DCU 上访问速度最快的存储。和 CPU 相比,DCU 上的寄存器数量非常多,分为两类:
| 类型 | 归属 | 数量 |
|---|---|---|
| 矢量寄存器 | 每个线程私有 | 每个线程最多可用 256 个 |
| 标量寄存器 | 被线程组共用 | 每个线程组可分配 16 ~ 102 个 |
寄存器的访问等待时间很短,因此在进行密集计算时,可以把常用的数据保存在寄存器中,减少数据读取的开销。不同线程之间也可以通过寄存器进行数据交互。
这里还引出了一个 DCU 隐藏延迟的核心机制,官方表述是:
"数据读取延迟就可以通过多个线程来回切换来掩藏掉。"
这句话很重要,3.7 节会专门展开。
同时请记住一个前提:寄存器是有限资源。你每个线程用得越多,同一时刻能容纳的线程就越少——这是 3.7 节的伏笔。
3.5 共享内存 LDS:开发者可控的高速缓存
共享内存(LDS,Local Data Share)的作用是数据重用。
每个 CU 单元设计了一块只供自己使用的 64 KB 共享内存。线程可以通过它交换数据,或者把常用数据放进去,以减少对全局内存的读取次数。
它和 cache 的本质区别在于:cache 由硬件自动管理,而共享内存的使用完全由开发者控制。你可以把它理解为"一块程序可控的高速缓存"。
典型用法是这样的:如果 CU 上的多个线程都要用到同一批数据,那么
- 先由这些线程协作,把数据从全局内存读一次到共享内存;
- 之后 CU 上的所有线程都从共享内存读取。
通过这种数据重用,原本需要多次的全局内存读取被压缩成了一次,开销显著下降。
bank 与 bank conflict
共享内存有一个必须掌握的细节:
共享内存有 32 个 bank,每个 bank 有 4 字节(Byte)。
bank(存储体) 可以理解为 32 条能够并行工作的独立通道。共享内存的地址是按 bank 交错排布的:第 0~3 字节属于 bank0,第 4~7 字节属于 bank1,以此类推,到 bank31 之后再回到 bank0 循环。
- 如果同一时刻,多个线程访问的地址落在不同的 bank 上 → 这些访问可以并行完成,速度最快;
- 如果多个线程访问同一个 bank 的不同地址 → 硬件只能让它们排队串行执行,速度成倍下降。这就是 bank conflict(bank 冲突)。
举一个经典的例子:假设你在共享内存里开了一个二维数组 data[N][32],每个元素 4 字节。现在让 32 个线程分别读取同一列的元素,即 data[0][0]、data[1][0]、data[2][0] ……
由于每行正好占 32 个 bank(32 × 4 字节),data[0][0] 和 data[1][0] 的地址相差整整一行——它们会落在同一个 bank 上。于是 32 个线程全部撞进 bank0,访问被完全串行化,性能降到 1/32。
解决办法叫 padding(填充):把数组声明为 data[N][33],人为地让每行多出一个元素。这样一来,相邻两行的同列元素地址就错开了一个 bank,冲突随之消失。
因此在使用共享内存时,必须考虑 bank 冲突的问题。
一个与 NVIDIA 架构的不同点
官方教材特别指出了这一点,值得留意:
DCU 的共享内存与 L1 cache 是完全分离的。
在 NVIDIA 的架构中,共享内存和 L1 cache 通常共用同一块物理存储,可以配置两者的容量比例。而在 DCU 上,它们是两块独立的硬件——你把 64 KB 共享内存用满,并不会挤占 L1 缓存的容量。
3.6 CU 与全局内存之间的数据通路
对于全局内存,每个 CU 都通过全局内存总线对其进行访问。每个 CU 有自己的 L1 cache,L2 做到 cache 一致性。cache 的存在增加了数据的重用性,提高了效率。
如前所述,cache 对程序员是不可控的,但它的命中率对性能影响很大。因此在编程时需要通过数据重排、预取等方法来提高命中率。
3.7 资源、并行度与延迟隐藏
这一节把前面的线索收拢,讲清楚 DCU 性能的核心机制。官方教材中有这样一句总结:
"共享内存和寄存器都是比较重要的资源,这些资源会被分配给 CU 上的线程,而这些资源是有限的,所以这些有限的资源就决定了 CU 上可以活跃的线程数,也就是并行性。"
这句话背后的完整逻辑链条是这样的:
第一步:全局内存很慢。 如 2.3 节所述,片外的全局内存延迟很高。一个线程发出读取请求后,要等待相当长的时间才能拿到数据。
第二步:DCU 靠"换人"来掩盖等待。 CPU 应对延迟的办法是堆大缓存、做乱序执行,想尽办法让这一条指令流别停。DCU 的思路完全不同:当一个 wavefront 卡住等数据时,SIMD 立刻切换到另一个已经准备好的 wavefront 去执行。
只要手头随时有足够多的 wavefront 可以切换,SIMD 就永远不会空转,访存的延迟就被完全"藏"在了其他 wavefront 的计算时间里。这正是"数据读取延迟可以通过多个线程来回切换来掩藏掉"的含义。
第三步:能切换多少 wavefront,取决于资源。 每个 SIMD 有 10 个 wavefront 槽位,但实际能同时驻留几个,取决于每个 wavefront 消耗多少资源:
- 每个线程使用的矢量寄存器越多 → 能同时驻留的 wavefront 越少;
- 每个线程块使用的共享内存越多 → 能同时驻留的线程块越少。
第四步:并行度不足,延迟就藏不住。 如果可切换的 wavefront 太少,当它们全都卡在等数据时,SIMD 就只能干等着——延迟暴露出来,性能随之下降。
把这条链条连起来:
    每线程寄存器用量 ↑         每块共享内存用量 ↑
             ↘                    ↙
           能同时驻留的 wavefront 数量 ↓
                        ↓
            可供切换的 wavefront 不足
                        ↓
                访存延迟无法被掩藏
                        ↓
                     性能下降
这条链条给出了 DCU 优化中一个反直觉但极其重要的结论:
多用资源(寄存器、共享内存)未必更快。 使用更多寄存器可以减少读取、使用更大的数据块可以提升访存效率,但它们都会降低并行度。收益与损失在打架,存在一个最优点,而且通常需要实测才能找到。
这也是为什么在 DCU 上,"把分块开得更大"这类看似显然的优化,常常在超过某个尺寸后反而变慢。
第四章 DCU 节点架构
前三章讨论的都是一块卡内部的事。本章把视野放大到整台机器,以及机器与机器之间。
4.1 异构计算节点的互连结构
常见的异构计算节点主要由四个部分组成:主存、多核处理器、I/O Hub 和 DCU 加速器。
图 2-3 常见异构计算节点内部互连结构
它们的连接关系如下:
- 主存(System Memory) 与多核处理器之间通过 Memory Bus 互连,常用的物理接口有 SIMM、DIMM、RIMM 等;
- 多核处理器借助 I/O Hub 链接多种外部设备;
- I/O Hub 通过 PCI-E 总线,以树状结构链接各种功能设备。在异构计算节点中,主要的设备就是 DCU 加速器。
由于处理器直接支持的 PCI-E 链路有最大数量限制,因此在 I/O Hub 与 DCU 加速器之间还会增加 PCI-E Switch,从而扩展 PCI-E 链路、链接更多的设备。
高级的 PCI-E Switch 支持多种链接结构,并可以在其内部完成数据转发而无需多核处理器参与——这种情况下,数据传输往往可以获得更高的效率。
4.2 NUMA:多处理器带来的陷阱
如果一个异构计算节点拥有多个多核处理器,那么这些处理器之间将通过 GMI、QPI 等专用总线互连。
此时会出现一个容易被忽视的问题:与不同处理器对应的 I/O Hub 所连接的外部设备,在进行数据传输时将会受到协议的影响。最糟糕的情况是,分属于不同多核处理器的外部设备之间无法通信。
因此需要合理选择多核处理器、主存、DCU 加速器之间的使用关系。这种结构在计算机体系结构中被定义为 NUMA(Non-Uniform Memory Access,非一致内存访问)。
实践中的含义很直接:应当让 CPU 线程、它使用的内存、以及它要驱动的那块 DCU 尽量位于同一个 NUMA 域内,否则会出现难以解释的带宽损失,甚至遇到设备间无法直接通信的情况。
4.3 DCU 加速器的内部结构
DCU 加速器根据其主要功能,可以划分为四个主要组件:
- 执行引擎(Execution Engine)—— 负责计算;
- 一个或多个 DMA 拷贝引擎(Copy Engine)—— 负责搬运数据;
- 内存控制器(Memory Controller);
- DCU 显存(DCU Memory)。
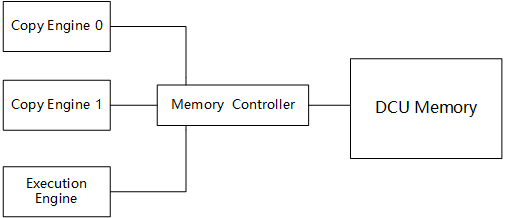
图 2-4 DCU 内部互连结构
DMA 拷贝引擎可以接收内存控制器的数据传输请求,处理系统内存与 DCU 显存之间、以及 DCU 显存之间的数据传输。
由于 PCI-E 是全双工的互连协议(即两个方向可以同时通信),DCU 加速器拥有 2 个拷贝引擎,可以同时进行数据传入和数据传出的双向通信。
从图 2-4 可以看出一个值得注意的结构特征:执行引擎与两个拷贝引擎,最终都要经过同一个内存控制器去访问 DCU 显存。这意味着计算与数据传输虽然可以并行进行,但它们在访问显存时是共享同一条通路的。因此在设计程序时,既要利用好三者的重叠以提升性能,也要意识到它们之间存在资源竞争。
合理利用 DCU 加速器各组件的执行特点,将大幅度提高程序的性能。
4.4 DCU 之间的互连
DCU 之间通过 PCI-E 互连并完成数据传输。在高级 DCU 加速器上,同时还支持 xGMI 链路。
xGMI(inter-chip global memory interconnect)是一种开放标准全局内存互连协议的点对点高速互连。通过 xGMI 链路互连的 DCU 加速器可以获得高带宽、低延时的传输性能,并且可以支持 DCU 加速器之间的缓存一致性,从而实现共享显存。
这对多卡程序意义重大:卡间通信不再需要绕道主机内存,可以直接、高效地交换数据。
4.5 节点之间的互连
在一个给定的服务器里,每个节点都借由一个高速交换机连接到所有其他节点。这种连接开关与以太网一样简单——大多数节点的主板附带两个以太网端口:一个负责内部连接,另一个负责外部连接。所有的外部连接通向一个共同交换机,而交换机本身处在诸如 InfiniBand 的高速主干网上。
InfiniBand 是一种网络通信协议,它提供了一种基于交换的架构,由处理器节点和输入/输出节点(如磁盘或存储)之间的点对点双向串行链路构成。
它通过交换机在节点之间直接创建一个私有的、受保护的通道,用于数据和消息的传输。适配器通过 PCI-E 接口一端连接到 CPU,另一端通过 InfiniBand 网络端口连接到 InfiniBand 子网。
与其他网络通信协议相比,InfiniBand 提供了明显的优势,包括更高的带宽、更低的延迟和增强的可伸缩性。
第五章 DCU 软件栈
硬件讲完了,最后介绍配套的软件生态。
5.1 HIP 软件栈
DCU 拥有自己的软件栈——HIP 软件栈,也叫生态系统或软件层,用来支持基于 HIP 的异构计算应用程序。
它是一种轻量级、模块化的软件开发环境,提供多种开发工具和运行时环境,同时拥有丰富的系统关键功能组件支持。每个组件根据其功能自底向上构建出完整的平台功能,可适用于大规模应用程序计算、编译器及程序运行时组件开发。
在软件栈中,每个组件对下层功能进行封装,并对上层提供必需的功能支持。自底向上分别为:HIP 并行编程模型、基础数学库、管理工具、优化和调试工具。 同时,还提供对 OpenCL、SYCL、OpenMP 等的支持。
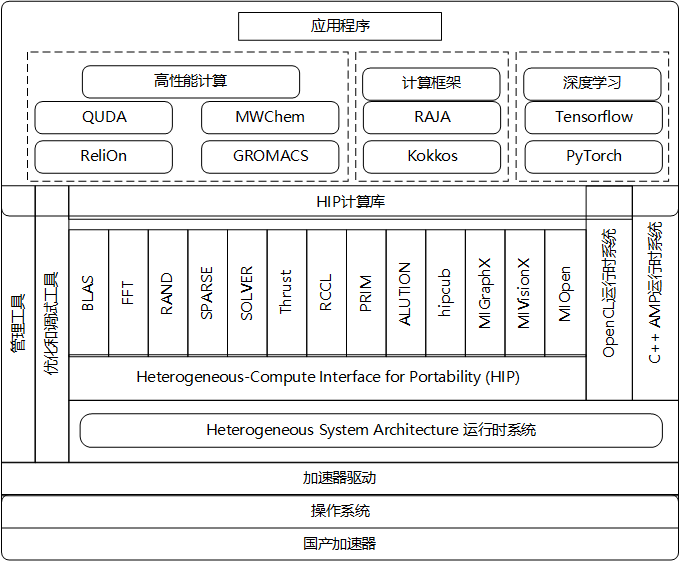
图 2-5 Toolkit 软件栈架构图
从图 2-5 可以看到完整的分层结构,自下而上依次是:
- 国产加速器(硬件)
- 操作系统
- 加速器驱动
- Heterogeneous System Architecture 运行时系统(HSA 运行时)
- HIP(Heterogeneous-Compute Interface for Portability,面向可移植性的异构计算接口)—— 核心的并行编程模型
- HIP 计算库 —— BLAS、FFT、RAND、SPARSE、SOLVER、Thrust、RCCL、PRIM、ALUTION、hipcub、MIGraphX、MIVisionX、MIOpen 等
- 应用程序层 —— 高性能计算(QUDA、MWChem、ReliOn、GROMACS)、计算框架(RAJA、Kokkos)、深度学习(TensorFlow、PyTorch)
5.2 编译工具链
DCU 的编译工具链以 HIP 编译器为核心,支持从源码到可执行文件的完整编译流程。
HIPCC 编译器是 HIP 编程模型的主要编译入口。它本质上是一个编译驱动脚本,根据目标平台自动选择合适的后端编译器。当目标平台为 DCU 时,HIPCC 会调用 AMD ROCm 编译器栈中的 clang 作为前端,将 HIP 代码(.hip 或 .cpp 文件)编译为 DCU 可执行的二进制代码。
编译流程大致分为以下几个阶段:
- 预处理:处理宏定义、头文件包含等预处理指令;
- 编译前端:将 HIP 源码解析为 LLVM 中间表示(IR);
- 设备代码编译:将设备端(在 DCU 上执行的)代码编译为 DCU 指令集架构(ISA)的二进制码;
- 主机代码编译:将主机端(在 CPU 上执行的)代码编译为 x86 或 ARM 等目标架构的二进制码;
- 链接:将设备代码和主机代码链接为最终的可执行文件。
常用的编译命令示例如下:
hipcc -o my_program my_program.hip
# 或指定优化级别
hipcc -O3 -o my_program my_program.hip
# 链接数学库
hipcc -o my_program my_program.hip -lhipblas -lhipfft
除了 HIPCC,DCU 软件栈还提供了 HIPIFY 工具,用于将现有的 CUDA 代码自动转换为 HIP 代码。HIPIFY 支持大部分 CUDA API 和内置函数的自动转换,大大降低了从 NVIDIA GPU 迁移到 DCU 的工作量。
5.3 性能分析工具
性能分析是 DCU 编程优化中不可或缺的一环。DCU 软件栈提供了多种性能分析工具,帮助开发者定位性能瓶颈。
rocprof 是 DCU 上的主要性能分析工具,它可以收集 DCU 内核执行时的硬件计数器数据,包括:
- 内核执行时间(kernel execution time);
- 全局内存访问次数与带宽利用率;
- L1/L2 缓存命中率;
- 共享内存 bank 冲突次数;
- 分支发散统计;
- wavefront 占用率等。
使用 rocprof 的基本方式如下:
# 收集默认性能计数器
rocprof --stats ./my_program
指定输出文件
rocprof --stats --output-dir ./profiling_results ./my_program
收集特定计数器
rocprof --counters "L2CacheHitRate,MemWrites" ./my_program
rocprof 的输出通常包含一个 CSV 文件,记录了每个内核的性能数据。开发者可以通过这些数据快速定位哪些内核耗时最长、哪些资源成为瓶颈。
此外,rocprof-compute 是一个更高层次的分析工具,它提供了更友好的可视化界面,可以将性能数据以火焰图、时间线等形式展示,帮助开发者直观地理解程序的执行行为。
5.4 调试工具
DCU 软件栈提供了多种调试工具,用于排查程序中的逻辑错误、内存访问越界、数据竞争等问题。
rocgdb 是 DCU 上的调试器,它基于 GDB(GNU Debugger)扩展而来,支持对 DCU 设备代码进行断点调试、单步执行、变量查看等操作。使用方式与标准 GDB 类似:
# 启动调试
rocgdb ./my_program
在 GDB 中设置断点
(gdb) break my_kernel
(gdb) run
(gdb) continue
rocgdb 支持以下常用调试功能:
- 在设备代码中设置断点;
- 查看设备端变量的值;
- 查看 wavefront 的执行状态;
- 检查全局内存和共享内存的内容;
- 回溯调用栈。
rocprof-compute 中的 rocprofv3 也提供了调试辅助功能,包括内存错误检测和线程同步检查。
此外,HIP 内存检查器(hip-memcheck)可以检测常见的 GPU 内存错误,如:
- 越界访问(out-of-bounds access);
- 未初始化内存读取;
- 内存泄漏;
- API 调用错误。
使用方式非常简单:
hip-memcheck ./my_program5.5 总结与展望
本章介绍了 DCU 的软件生态,包括 HIP 编程模型、编译工具链、性能分析工具和调试工具。这些工具共同构成了 DCU 的完整开发环境,使开发者能够高效地编写、调试和优化 DCU 程序。
从软件栈的发展趋势来看,有以下几个值得关注的方向:
- 工具链的持续完善:随着 DCU 硬件的迭代,编译器优化、性能分析工具和调试工具也在不断升级,提供更精准的分析能力和更友好的用户体验。
- 与主流框架的深度集成:DCU 对 PyTorch、TensorFlow 等深度学习框架的支持越来越完善,使得 AI 开发者可以无缝使用 DCU 进行模型训练和推理。
- 开源生态的繁荣:HIP 作为开源标准,吸引了越来越多的社区贡献,计算库的种类和功能都在快速扩展。
- 跨平台兼容性:HIP 的设计目标之一就是跨平台兼容,同一份 HIP 代码可以编译运行在 DCU、AMD GPU 甚至 NVIDIA GPU(通过 HIP-CUDA 后端)上,这为开发者提供了极大的灵活性。
至此,本系列第一篇——硬件架构篇——全部结束。从下一篇文章开始,我们将进入编程与优化基础篇,介绍如何在 DCU 上编写高效的 HIP 程序。
 暂无数据
 暂无数据 暂无数据