长上下文,多轮对话有概率触发崩溃重启
0
1
0
0
4卡k100AI,qwen3.8 27b w8a8跑出120tok/s
2026-09-02 10:49:04
1625
### 速度表
| 目标上下文 | TP1 TTFT | TP1 Decode | TP2 TTFT | TP2 Decode | TP4 实测点 | TP4 TTFT | TP4 Decode |
| ---------: | -------: | --------------------: | --------------: | ----------: | ---------: | ----------------: | ---------------------: |
| \~512 | 4.99s | 23.91 tok/s | **0.36s** | 68.79 tok/s | 597 | 0.63s | **118.18 tok/s** |
| \~2K | 2.72s | 28.37 tok/s | **0.95s** | 81.82 tok/s | 2,399 | 1.18s | **126.80 tok/s** |
| \~4K | 6.84s | 24.45 tok/s | 2.04s | 85.13 tok/s | 3,793 | **1.40s** | **119.07 tok/s** |
| \~8K | 8.40s | 27.46 tok/s | 3.83s | 81.75 tok/s | 9,562 | **3.21s** | **131.30 tok/s** |
| \~12K | 13.73s | 27.82 tok/s | 6.99s | 84.75 tok/s | 10,200 | **3.41s** | **126.37 tok/s** |
| 16K | 16.57s | **48.24 tok/s** | 9.64s | 77.68 tok/s | 16,384 | **4.60s** | **113.10 tok/s** |
| 32K | 34.03s | 27.12 tok/s | 22.59s | 79.15 tok/s | 32,768 | **18.97s** | **124.96 tok/s** |
| 64K | 72.88s | 31.42 tok/s | 40.45s | 66.63 tok/s | 65,536 | **29.74s** | **96.38 tok/s** |
| 128K | 175.32s | 32.16 tok/s | 90.86s | 63.48 tok/s | 131,072 | **49.32s** | **90.24 tok/s** |
| \~257.9K | 470.29s | 22.76 tok/s | 235.74s | 59.03 tok/s | 256,375 | **190.15s** | **76.24 tok/s** |
### TP4 短上下文专项优化效果
TP4 的短上下文已经不是旧表里“4K 只有 95 tok/s 左右”的状态。v30 随机真实长度扫描中,短上下文大量点已经稳定在** 110~130 tok/s**:
| 实际 Prompt | TTFT | Decode |
| ----------: | ----: | ---------------------: |
| 597 | 0.63s | 118.18 tok/s |
| 2,399 | 1.18s | 126.80 tok/s |
| 3,287 | 1.30s | 118.82 tok/s |
| 3,793 | 1.40s | 119.07 tok/s |
| 6,928 | 2.36s | 119.06 tok/s |
| 9,562 | 3.21s | **131.30 tok/s** |
| 10,200 | 3.41s | 126.37 tok/s |
32 点随机扫描覆盖** 597 → 256,375 tokens**。按区间看,TP4 Decode 中位数约为:
| 区间 | 样本数 | Decode 中位数 |
| --------- | -----: | ---------------------: |
| <4K | 12 | **111.96 tok/s** |
| 4K~16K | 8 | **110.11 tok/s** |
| 16K~64K | 6 | **108.17 tok/s** |
| 64K~128K | 4 | **91.50 tok/s** |
| >=128K | 2 | 62.19 tok/s |
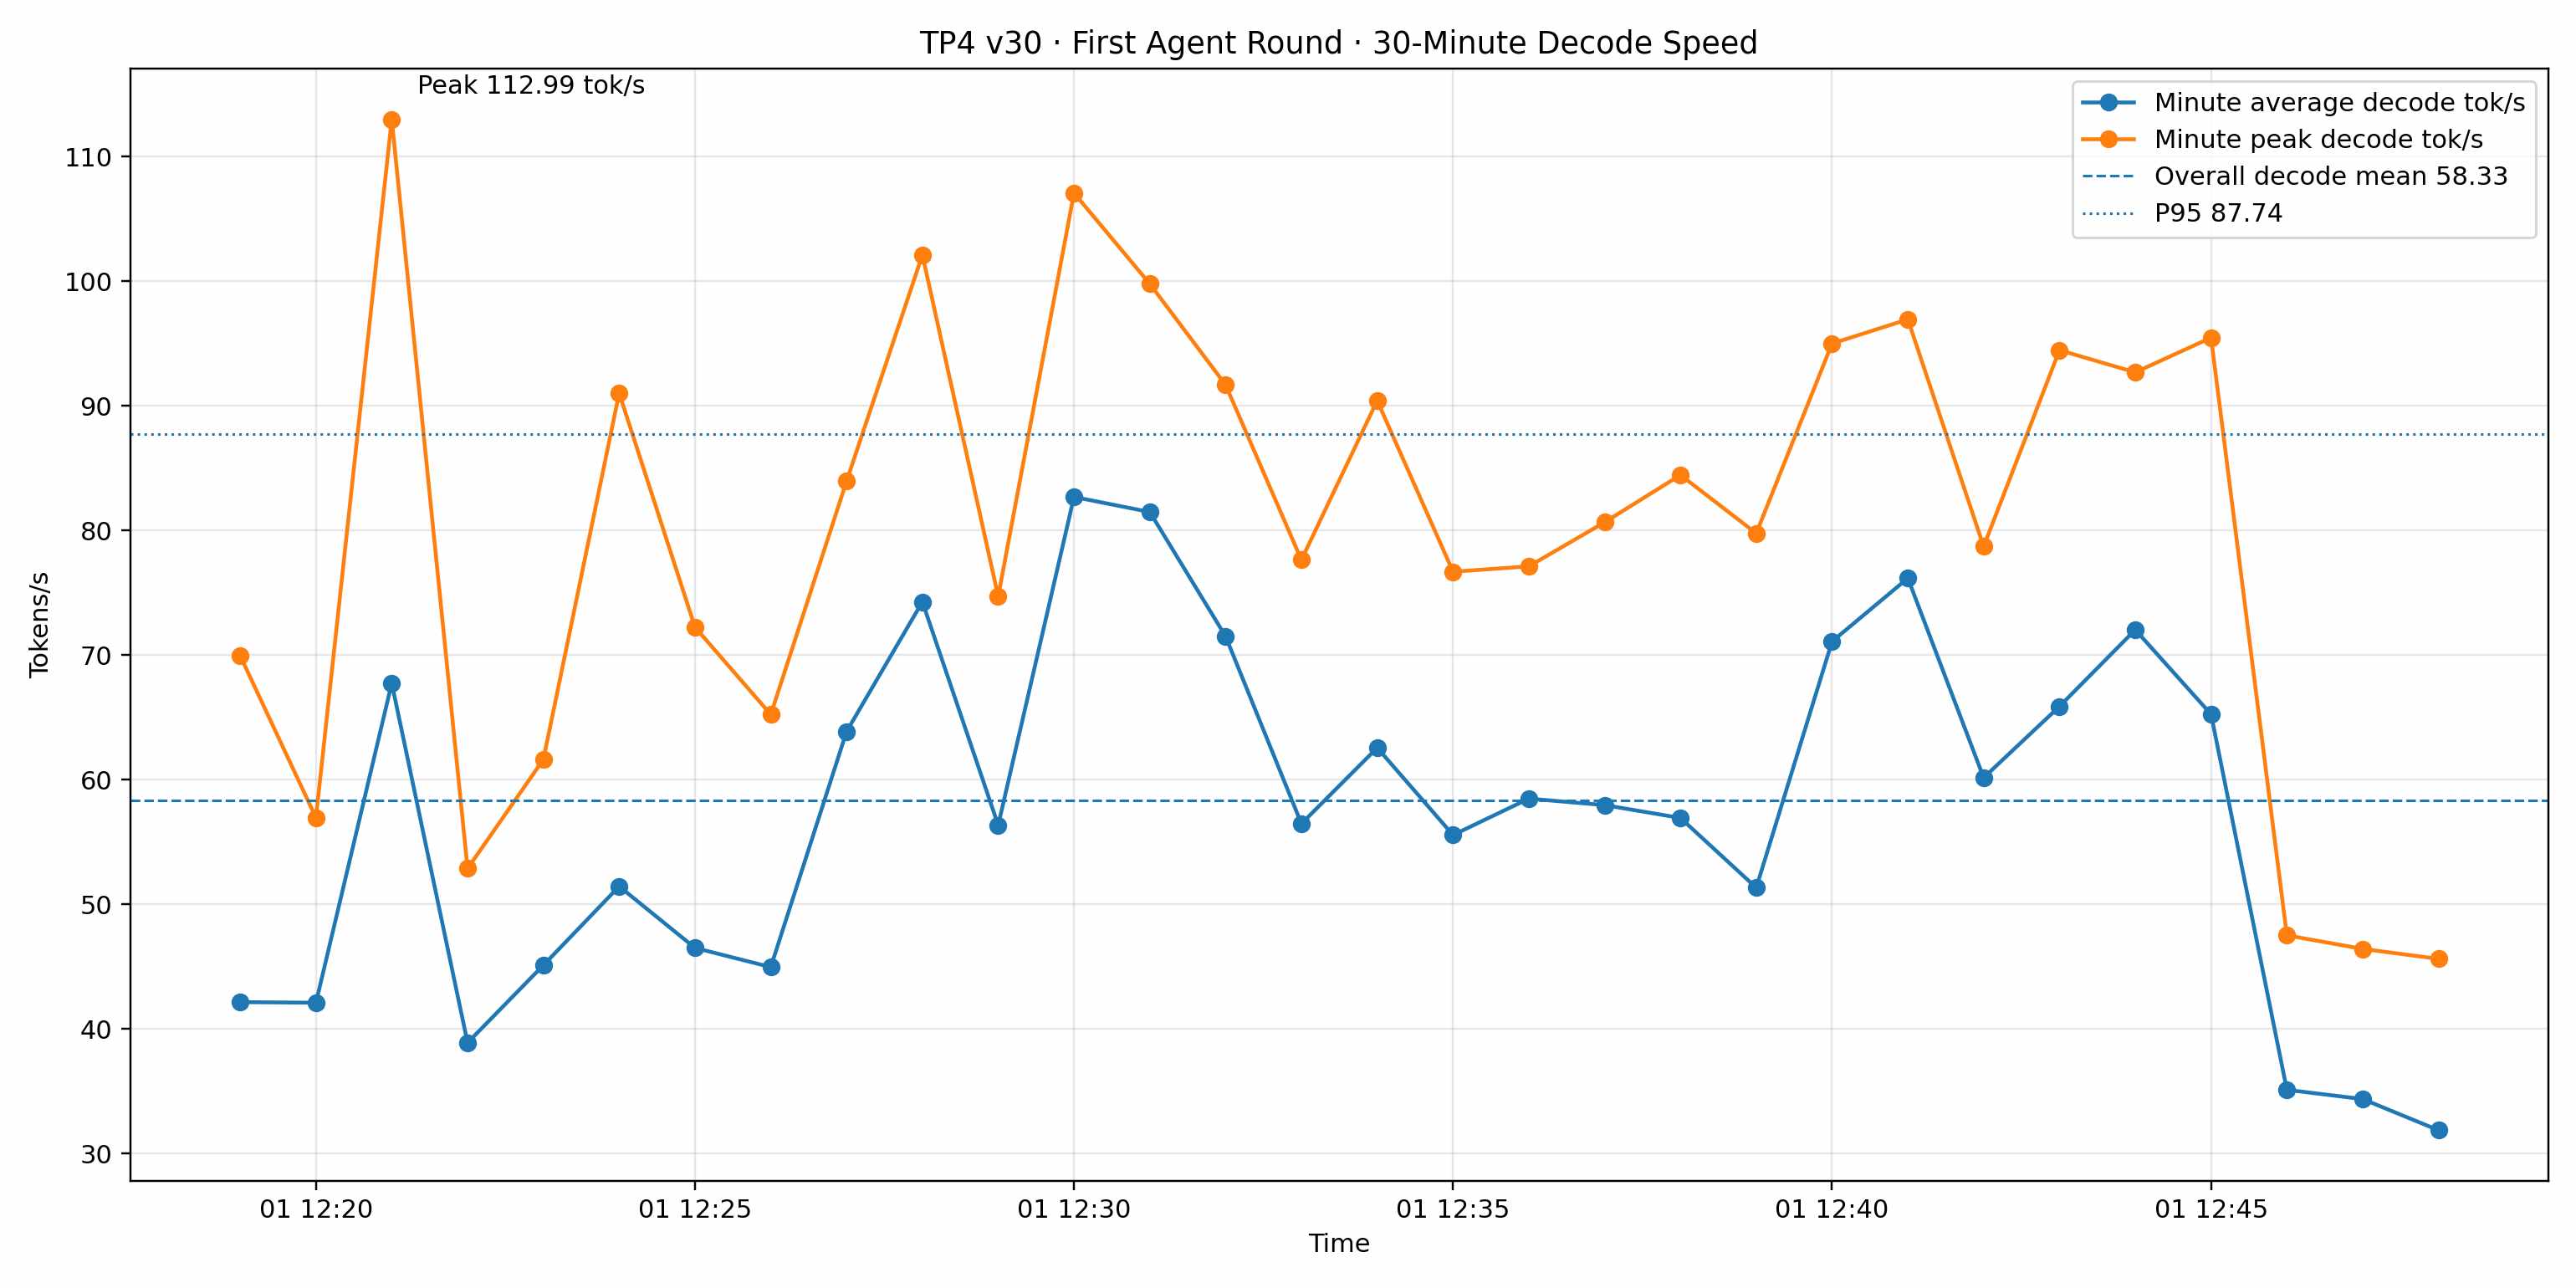
为了测试这套 Qwen3.8-27B W8A8 + DFlash2 在 K100AI 四卡 TP4 上的真实 Agent 使用性能,我直接把模型接入 OpenCode,让它以 Build Agent 的方式自主完成一个真实开发任务:**“编写网页版的 macOS,要求功能齐全、界面精美。”** 整个第一轮基本不进行人工干预,让 Agent 自己规划、写代码、修改文件并执行命令,最终从 12:19:04 跑到 12:48:18,持续** 29 分 14 秒**。期间 OpenCode 共进行了** 11 次模型请求、12 次工具调用**,累计 API 输入约** 90.7 万 tokens**、输出约** 9.29 万 tokens**(输入量包含多轮 Agent 上下文的重复传入,并非 90 万独立上下文)。实机日志统计中,模型在实际 Decode 输出阶段的**全程平均速度为 58.33 tok/s,P95 为 87.74 tok/s,最高瞬时速度达到 112.99 tok/s**。这里的 58.33 tok/s 只计算模型正在生成 token 时的 Decode 性能,不包含 Prefill/TTFT、工具执行和 Agent 请求之间的等待;如果把整整 29 分 14 秒的所有等待、工具调用和上下文处理时间全部算进去,用总输出 token 除以墙钟时间,端到端有效输出吞吐仍约为** 52.9 tok/s**。相比单纯跑固定输入输出的测速,我觉得这种让真实 Coding Agent 连续工作半小时的数据,更能反映模型在实际 Agent 场景下的性能。
核心技术工作:
* 完成** Qwen3.8-27B W8A8 INT8 在 K100AI/gfx928 上的深度适配与性能优化**。
* 针对 K100AI 重做并优化** INT8 GEMM/GEMV、GDN、RMSNorm、SwiGLU、QKV、LM Head 等关键算子**。
* 分别针对** ****TP1、TP2、TP4** 的不同计算几何进行专项调优,而不是使用一套通用参数。
* 优化** 多卡通信、P2P、All-Reduce 和 rank-local 计算**,提升 TP 多卡扩展效率。
* 针对** ****短、中、长上下文**分别优化执行路径,尤其强化** 128K~258K 长上下文 Prefill / TTFT**。
* 完整移植并深度优化** DFlash2 speculative decoding**,包括 Draft、Selector、Verifier 等核心路径。
* 针对不同 TP 优化** DFlash2 INT8 Verifier 与接受率**,显著提高实际 Decode 性能。
* 对** ****Prefix Cache、Mamba 状态恢复和长对话续写**进行底层修正,使缓存加速能够稳定用于真实 Agent 场景。
* 对** ****多并发 Decode 与调度**进行专项优化,在保持单请求速度的同时提高整体吞吐。
* 最终形成一套针对** ****K100AI + Qwen3.8 W8A8 + SGLang + DFlash2** 的完整专用推理优化方案。
项目地址:https://github.com/DocPang/qwen38-k100ai-int8-optimization
帮我点个star谢谢,个人精力有限,有问题留言尽量处理
全部评论(18)
只看楼主
Z
9/23
歪
TP4部署,加了1.32热补丁后,依然出现卡死现象,300秒重启
9/20
樱
BW卡可以使用吗?
9/8
_
多并发可以验证一下吗?
9/4
飞
请问是单并发还是多并发呢?
9/4
网
有没有vllm部署脚本啊
9/3
吕
验证成功,脚本在我的机器上有些问题,修改过后确实可以部署,单流60Token/S 确实比官方版本快很多
9/3
网
厉害
9/3
666
9/2
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据