0
1
0
0
实操干货|海光DCU实践分享:智能图像处理如何完成全面国产替代
2026-07-07 11:14:32
61
随着装备制造的智能化转型,智能图像处理技术被应用于精密零件的缺陷检测、高风险场所的生产安全监测等领域,在保障产品质量、提高运维效率等方面发挥着重要作用。然而,该技术高度依赖高性能图形处理器的算力支持,而目前国际市场上英伟达的图形处理器(如:RTX 4090)占据着主导地位。在当前复杂的国际环境下,过度依赖国外产品存在双重风险:设备断供的“卡脖子”风险和数据安全隐患。
我公司是国内大型装备制造公司(以下简称“我公司“”)积极响应国产化战略,推进重要设备的国产化替代,降低对外依赖风险。为此,我公司选择海光DCU K100\_AI加速卡开展智能图像处理软件的适配测试,评估其在复杂算法中的性能,为智能图像处理技术的研发提供支撑。
## DCU开发环境介绍
为了验证海光DCU K100\_AI是否能够满足我公司在智能图像处理领域的技术需求,海光产业生态合作组织(简称“光合组织”)为我公司免费提供了测试资源以开展测试与验证。
1、硬件配置
| **序号** | **类别** | **型号** | **配置** | **数量** |
| -------------- | -------------- | -------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------- |
| 1 | AI服务器 | X7850H0 | 处理器:C86 7490(64C,2.7GHz)\*2;内存:64G DDR5*8;硬盘:2.5寸 1.92TB SSD*1DCU:K100_AI*2网卡:2\*10Gb SFP接口(含光模块)阵列卡:SAS HBA\*1电源:1+1冗余电源模块 | 1 |
2、软件环境
| **序号** | **软件名称** | **软件版本** | **用途** |
| -------------- | ------------------ | ----------------------- | ---------------------------------------------- |
| 1 | Ubuntu操作系统 | 22.04 LTS | 控制和管理计算机硬件和软件资源 |
| 2 | Docker | 28.2.2 | 将软件及其依赖库打包成轻量级、可移植的独立单元 |
| 3 | Python | 3.10.12 | 解释型的高级编程语言 |
| 4 | PyTorch | 2.5.1+das.opt1.dtk25042 | 深度学习框架 |
| 5 | mmcv | 2.1.0+das.opt1.dtk24043 | 计算机视觉研究的基础库 |
| 6 | fvcore | 0.1.5.post20221221 | 计算机视觉研究的基础库 |
| 7 | Ultralytics软件 | 8.4.28 | 智能图像处理 |
| 8 | Detectron2软件 | 0.6 | 智能图像处理 |
| 9 | MMDetection软件 | 3.3.0 | 智能图像处理 |
## DCU测试过程记录
1、安装DCU驱动和DTK软件栈,检查DCU信息
打开终端,执行lscpu命令,获取处理器的信息,CPU为海光C86 7490,x86架构,支持32位和64位操作模式。
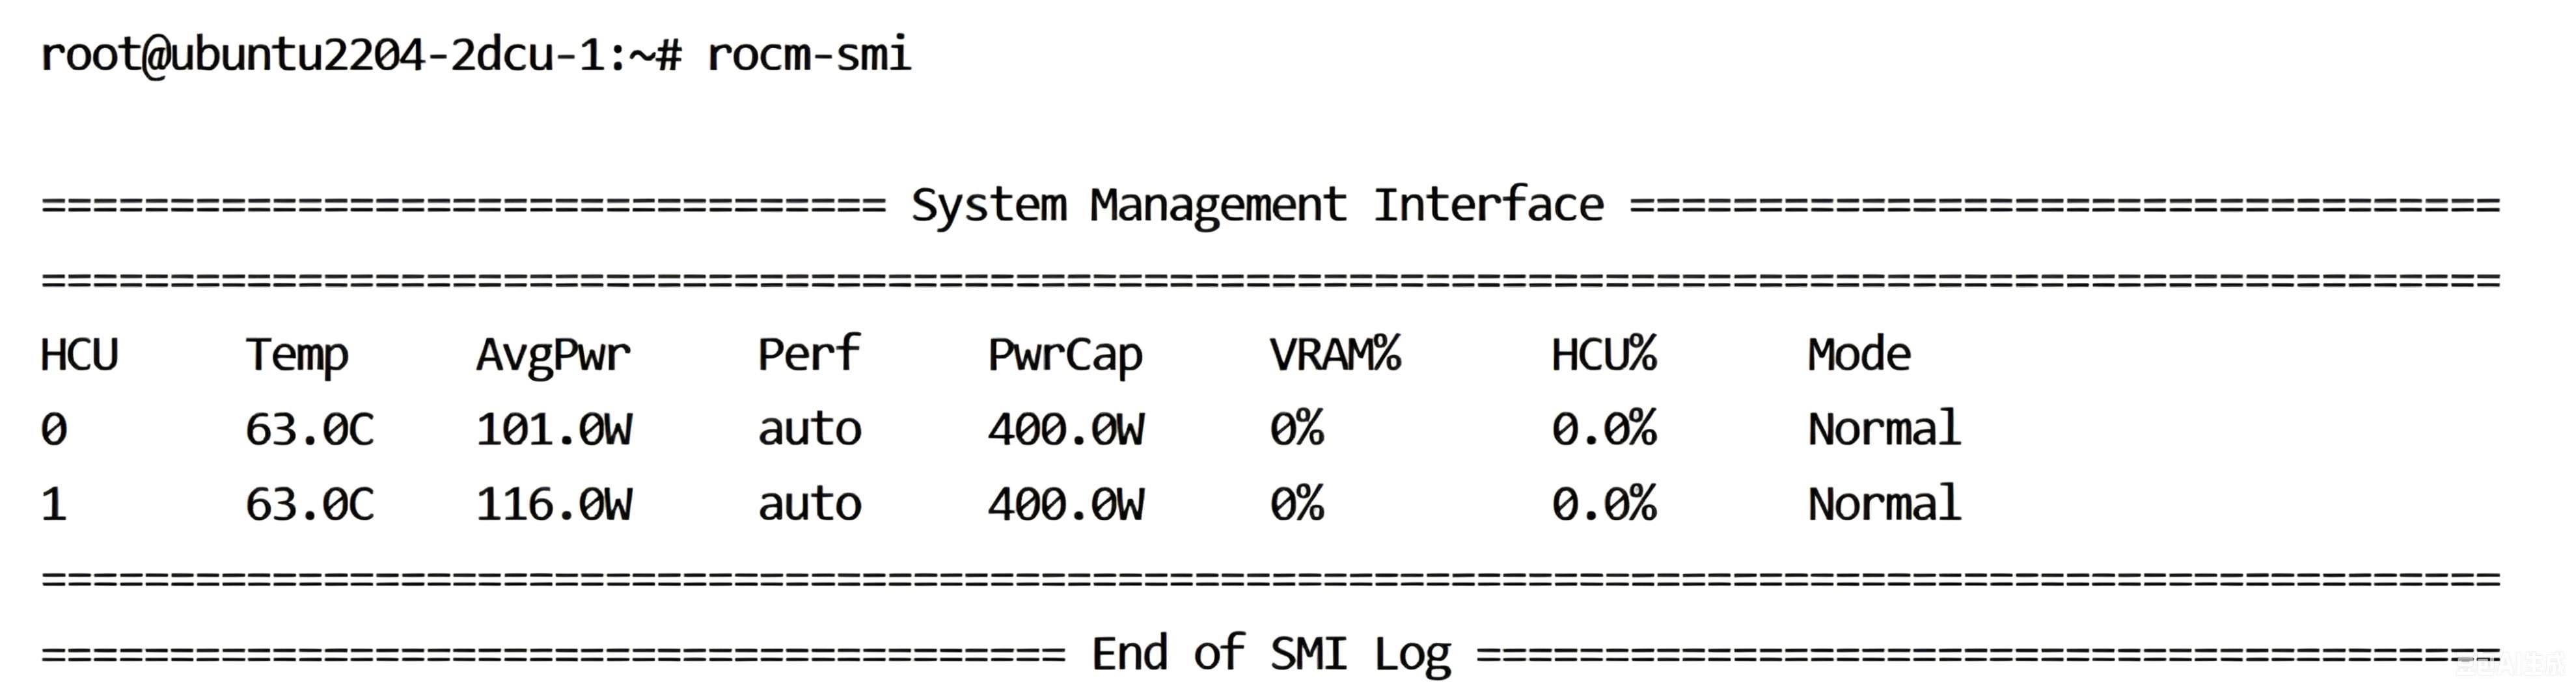
打开终端,执行rocm-smi命令,获取K100\_AI加速芯片状态信息。在空闲时,DCU K100\_AI状态信息如图2所示。当前,系统已识别到2个K100\_AI加速卡,平均功率分别为101.0W和116.0W,显存占用均为0,使用率均为0。
2、Docker环境部署
```
# 拉取镜像
docker pull harbor.sourcefind.cn:5443/dcu/admin/base/vllm:0.9.2-ubuntu22.04-dtk25.04.2-py3.10
# 启动容器
docker run -itd --name test --network=host --privileged --device=/dev/kfd --device=/dev/dri \
--device=/dev/mkfd --ipc=host --shm-size=128G --group-add video \
-v /opt/hyhal:/opt/hyhal --cap-add=SYS_PTRACE -v /data/:/data --security-opt seccomp=unconfined image.sourcefind.cn:5000/dcu/admin/base/vllm:0.9.2-ubuntu22.04-dtk25.04.2-py3.10
# 进入容器
docker exec -it test bash
# 查看容器的操作系统
cat /etc/os-release
```
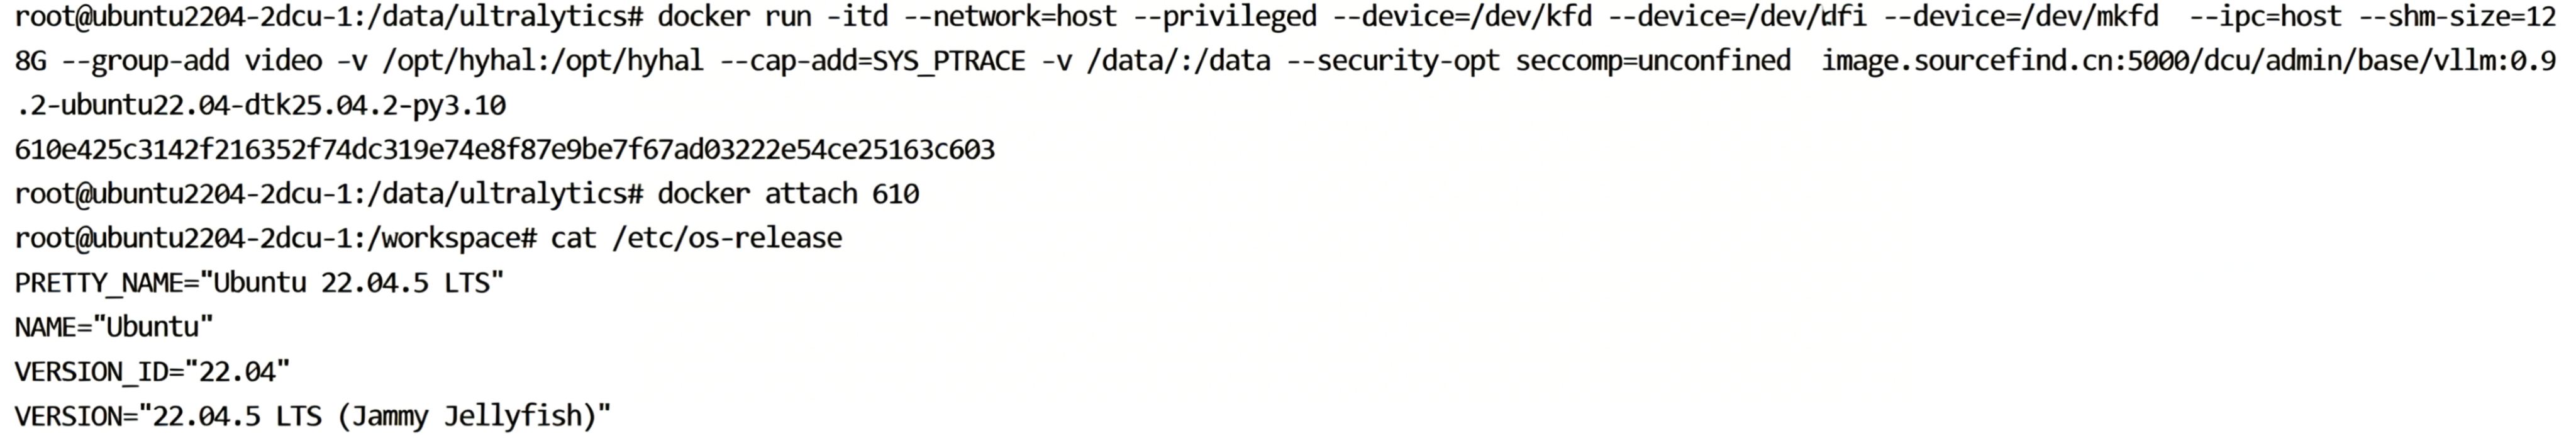
通过上图可知:容器已创建成功,容器ID为610e425c3142,容器操作系统为Ubuntu 22.04.5 LTS。
3、MMDetection模型训练和预测
基于已创建的容器环境开展K100\_AI在MMDetection模型的训练和预测,所使用的软件和数据集如下:
* 软件环境:MMDetection
* 数据集:MicroSoft (MS) COCO 2017数据集的验证集(由5000张图像组成)
测试步骤如下:
(1)对于MMDetection软件,安装过程如下:
```
# 进入DCU容器
docker exec -it test bash
# 进行如下安装即可完成适配
pip install -U openmim
mim install mmengine
mim install mmdet
pip install https://download.sourcefind.cn:65024/file/4/mmcv/DAS1.3/mmcv-2.1.0+das.opt1.dtk24043-cp310-cp310-manylinux_2_28_x86_64.whl
pip install numpy==1.25.0
```
(2)我们需要下载配置文件和模型权重文件。
```
mim download mmdet --config rtmdet_tiny_8xb32-300e_coco --dest .
```
(3)快速进行测试
```
from mmdet.apis import init_detector, inference_detector
config_file = 'rtmdet_tiny_8xb32-300e_coco.py'
checkpoint_file = 'rtmdet_tiny_8xb32-300e_coco_20220902_112414-78e30dcc.pth'
model = init_detector(config_file, checkpoint_file, device='cpu') # or device='cuda:0'
inference_detector(model, 'demo/demo.jpg')
```
(4)开始模型训练
```
训练过程使用COCO 2017训练集,在2块DCU K100_AI加速卡上执行,并持续12个轮次。ResNet-50作为骨干网络,它的初始化使用ImageNet大规模数据集。命令如下:
bash tools/dist_train.sh configs/mask_rcnn/mask-rcnn_r50_fpn_1x_coco.py 2 --work-dir mask-rcnn_r50_fpn_1x_coco
```
(5)进行模型推理
```
预测过程使用COCO 2017验证集。命令如下:
bash tools/dist_test.sh configs/mask_rcnn/mask-rcnn_r50_fpn_1x_coco.py mask-rcnn_r50_fpn_1x_coco/epoch_12.pth 2 --work-dir mask-rcnn_r50_fpn_1x_coco
```
当训练12个轮次时,MaskR-CNN的预测精度

测试结论:在海光DCU K100\_AI加速卡上,Mask R-CNN的实测AP:35.8,AP50:55.3,AP75:39.0,与已公开的基准精度相近或者相等。
[评价指标说明]
最重要的评价指标为平均精度(AP),其定义为当检测框与真实框之间的交并比的阈值从0.50增长到0.95(步长为0.05)时,这些阈值所对应的精度的平均值。另外,AP50和AP75作为辅助指标,前者是当交并比的阈值为0.50时的精度,后者是当交并比的阈值为0.75时的精度。根据已公开的基准精度,当加载现有权重时,YOLOv8n(yolov8n.pt作为权重)的AP为37.3,Faster R-CNN(model.pkl作为为权重)的AP为37.9,Mask R-CNN(coco\_model.pth作为权重)的AP为38.2。将实测精度与已公开的基准精度进行比较。
4、YOLOv8n模型训练和预测
基于已创建的容器环境开展海光DCU K100\_AI在YOLOv8n模型训练和预测,所使用的软件和数据集如下:
* 软件环境:Ultralytics
* 数据集:COCO 2017数据集的训练集(由118k张图像组成)和验证集(由5k张图像组成)
测试步骤如下:
(1)Ultralytics环境安装
```
# 进入DCU容器
docker exec -it test bash
# 进行如下安装即可完成适配
pip install ultralytics
pip install numpy==1.25.0
```
(2)训练过程使用COCO 2017训练集,在2块海光DCU K100\_AI执行并持续50个轮次(1次轮次表示模型遍历整个训练集1次),命令如下:
```
from ultralytics import YOLO
model = YOLO(‘yolov8n.yaml’)
model.train(data=‘coco.yaml’, imgsz=640, device=[0, 1], epochs=50, project=‘yolov8n_50e’, save_period=2, exist_ok=True)
```

图:训练50个轮次后,YOLOv8n的预算精度

图:训练50个轮次花费的时长
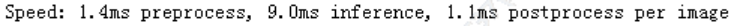
图:推理速度
(2)预测过程使用COCO 2017验证集,命令如下:
```
from ultralytics import YOLO
model = YOLO(‘runs/detect/yolov8n_50e/train/weights/best.pt’)
model.val(data=‘coco.yaml’, imgsz=640, device=[0, 1], project=‘yolov8n_50e’, save_json=True, save_txt=True, exist_ok=True)
```
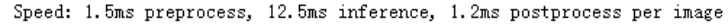
图:推理速度
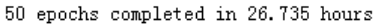
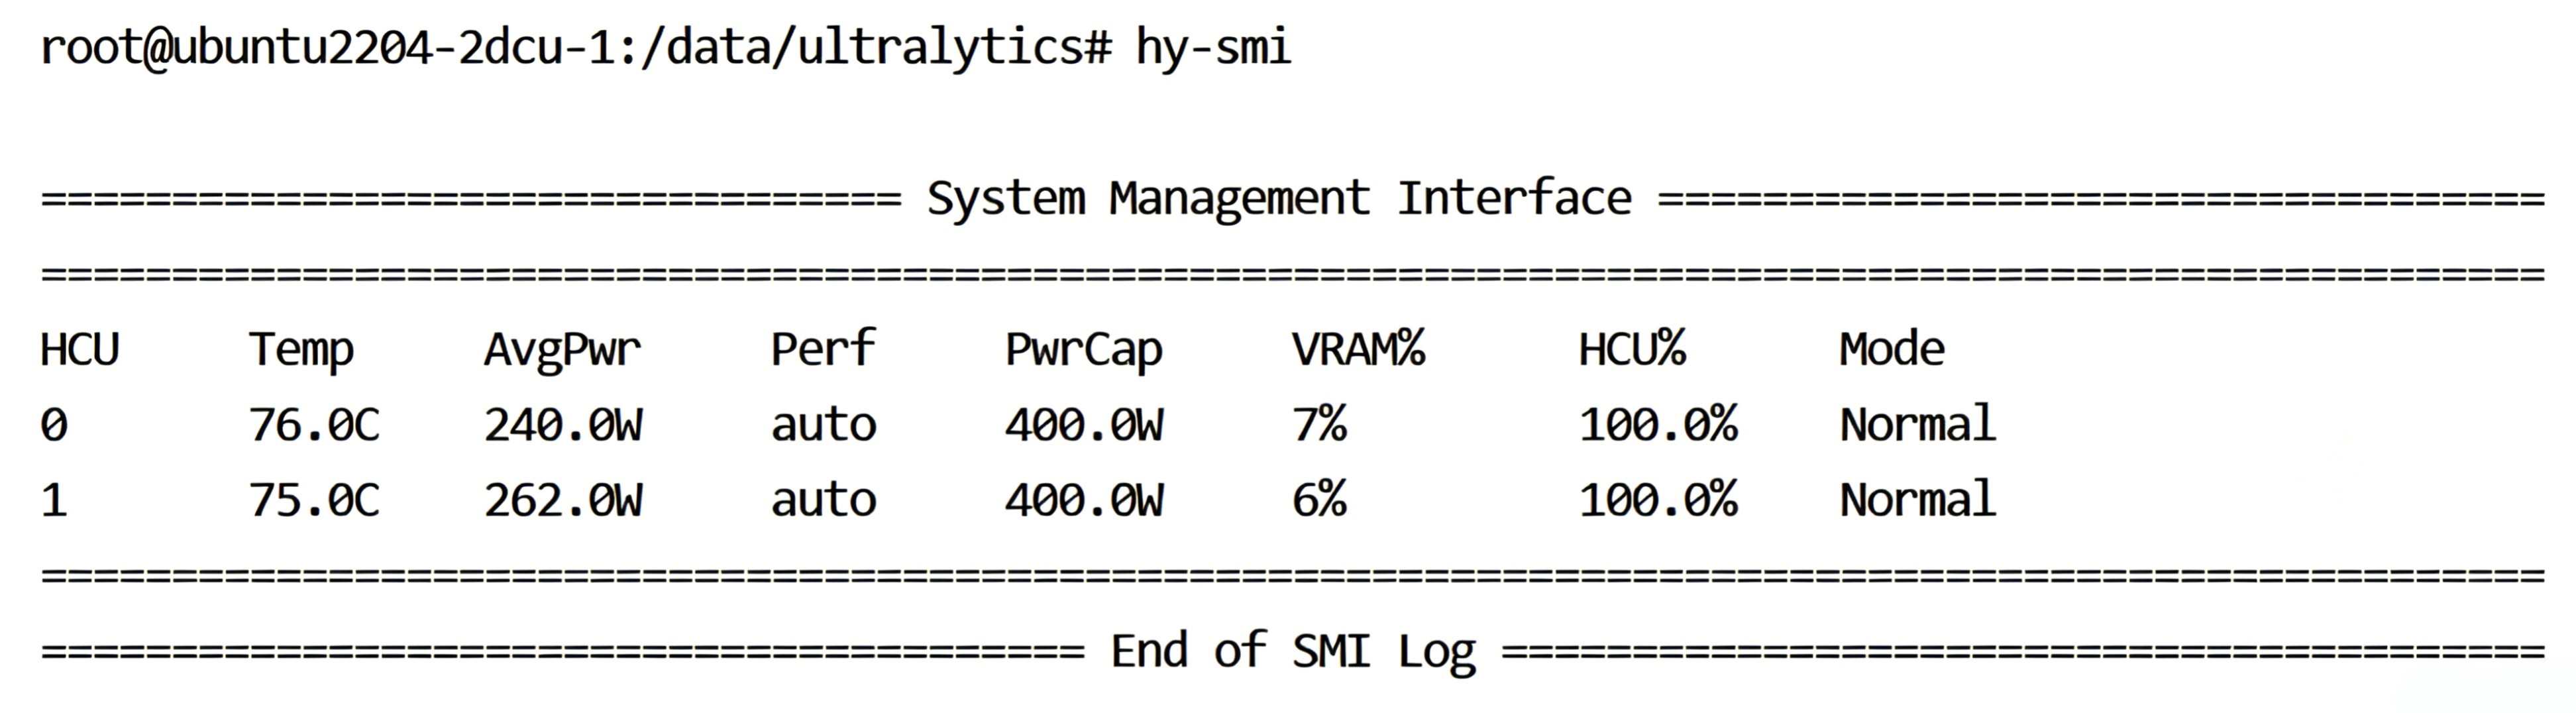
图:推理时DCU
测试结论:
* AP:31.7;AP50:45.6;AP75:34.4;
* 训练时长:24小时;
* 推理速度:111.1张图像/秒。
* 2块图形处理器的平均功率分别为240.0W和262.0W,显存占用分别为7%和6%,使用率均为100%。
5、RTDETR-l模型训练和预测
基于已创建的容器环境开展海光DCU K100\_AI在RTDETR-l模型训练和预测,所使用的软件和数据集如下:
* 软件环境:Ultralytics
* 数据集:COCO 2017数据集的训练集
(1)训练过程使用COCO 2017训练集,在2块海光DCU K100\_AI上执行并持续20个轮次,命令如下:
```
from ultralytics import RTDETR
model = RTDETR(‘rtdetr-l.yaml’)
model.train(data=‘coco.yaml’, imgsz=640, device=[0, 1], epochs=20, project=‘rtdetr-l_20e’, save_period=2, exist_ok=True)
```

图:训练20个轮次时,RTDETR-l的预测精度
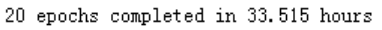
图:训练20个轮次花费的时长
(2)预测过程使用COCO 2017验证集,命令如下:
```
from ultralytics import RTDETR
model = RTDETR(‘runs/detect/rtdetr-l_20e/train/weights/best.pt’)# model.val(data=‘coco.yaml’, imgsz=640, device=[0, 1], project=‘rtdetr-l_20e’, save_json=True, save_txt=True, exist_ok=True)
```
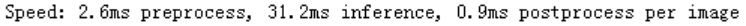
图:推理速度
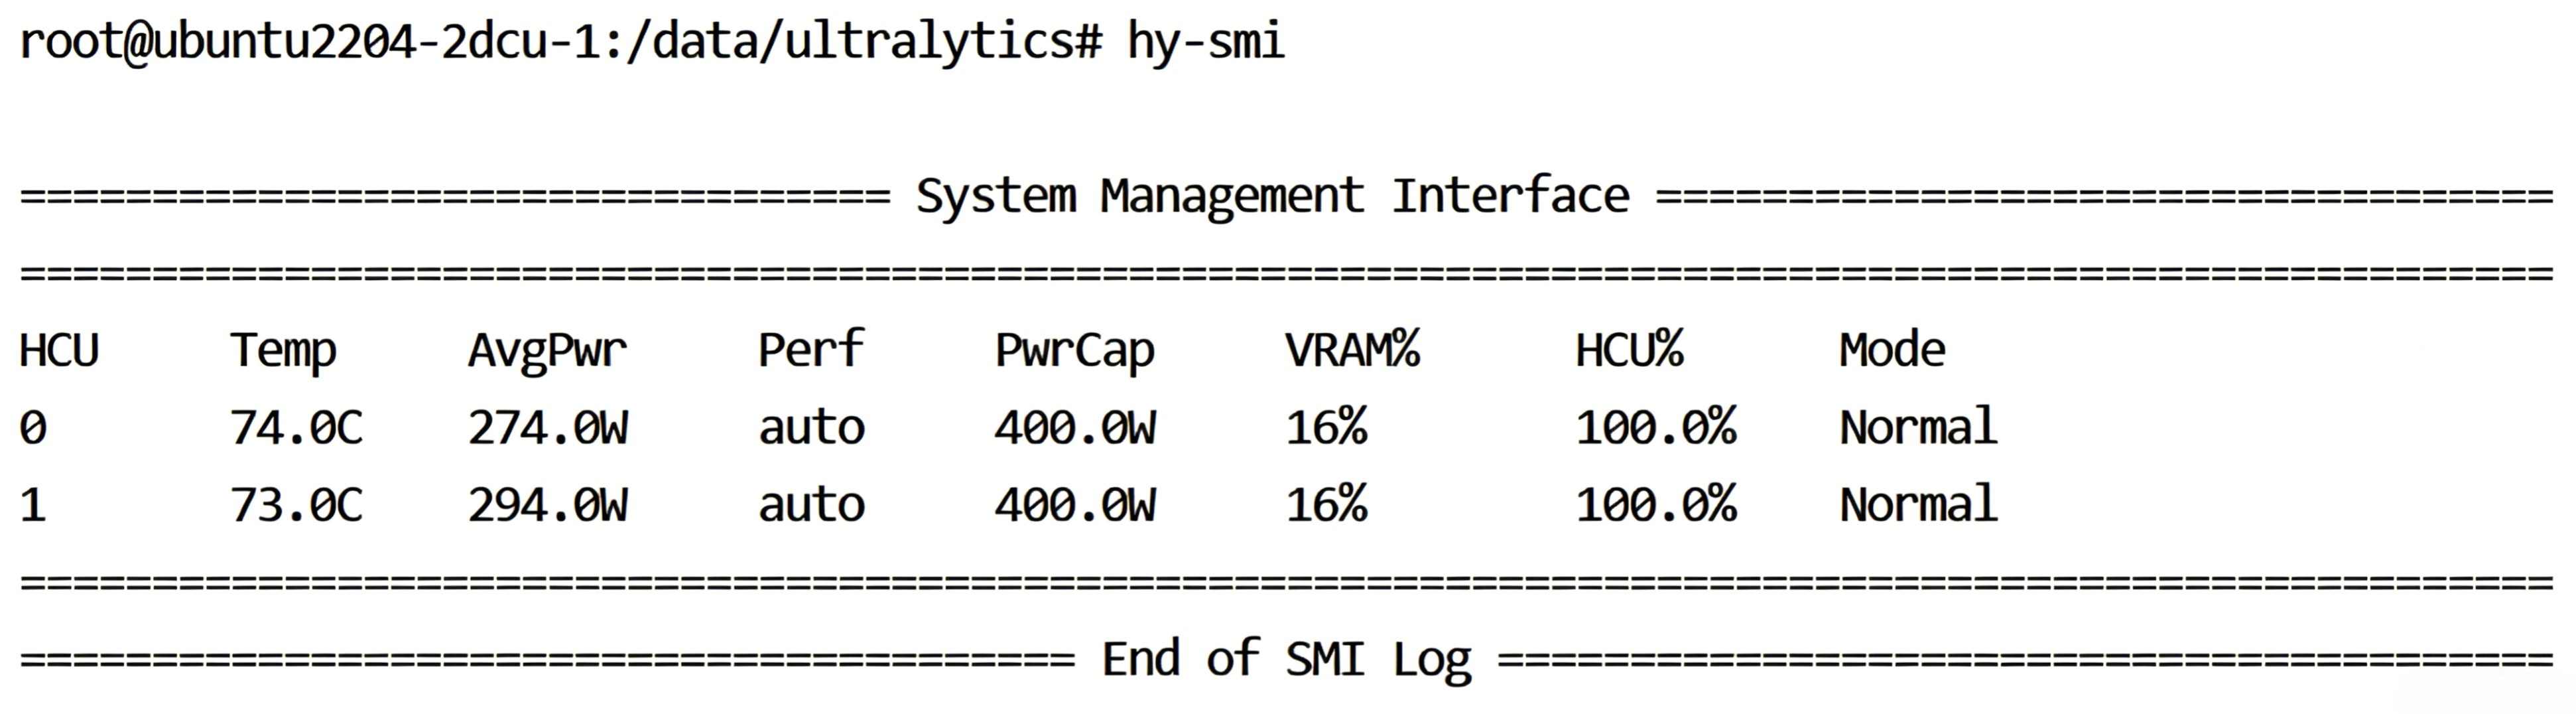
图:训练时,K100\_AI状态信息
测试结论:
* AP:37.1;AP50:53.0;AP75:39.9;
* 训练时长:34小时
* 推理速度:32.1张图像/秒
## DCU使用体验总结
通过我公司开发人员严谨的测试工作和细心的验证,在搭载海光C86-4G 7490处理器和海光DCU K100\_AI加速卡的国产服务器能够完全完成了MMDetection软件、Ultralyitcs软件所有相关测试内容。
海光DCU K100\_AI 具有优秀的生态兼容性,DTK软件栈可以完美兼容CUDA生态,对PyTorch AI框架支持非常好,本次测试的软件代码几乎没有修改,即可顺利运行。各项功能响应及时、输出准确,支持并发及长时间运行。
通过我公司开发人员的使用和体验,全面验证了海光DCU优异的生态兼容性和良好的性能,是我公司后续国产替代优先选择的国产加速卡。
---
*免责申明:本文观点和内容仅用于行业知识交流,不构成任何采购或技术选型建议,不对依据本文内容产生的任何后果承担责任。*
全部评论(0)
只看楼主
 暂无数据
--
楼主

0 点赞
0 帖子
楼主热帖
暂无数据常见问题新帖
暂无数据