请问这个测试工具是?
0
1
0
0
K100_AI上 Qwen3.6-27B 推理优化:vLLM 0.20.2rc1 + DFlash草稿生成带来 10 tokens/s 提升
2026-05-21 22:25:54
1046
**DCU K100\_AI 4卡** 环境下对 **Qwen3.6-27B** 模型进行推理测试,对比了普通生成与草稿生成(Speculative Decoding)在不同 vLLM 版本下的性能表现。测试发现:**vLLM 0.20.2rc1 配合 DFlash 草稿模型,相比无草稿基线可稳定提升约 10 tokens/s**。
## 测试配置
### 无草稿生成(基线)
```
vllm serve /modelpath/Qwen3.6-27B \
--served-model-name Qwen3.6 \
--gpu_memory_utilization 0.95 \
--tensor-parallel-size 4 \
--port 8001 \
--enable-auto-tool-choice \
--tool-call-parser qwen3_coder \
--reasoning-parser qwen3 \
--max-num-batched-tokens 32768 \
--max-num-seqs 128 \
--enable-prefix-caching \
--enable-chunked-prefill
```
### 使用草稿生成(vLLM 0.20.0 / 0.20.2rc1)
增加以下参数:
```
--speculative-config "{\"method\": \"dflash\", \"model\": \"/modelpath/Qwen3.6-27B-DFlash\", \"num_speculative_tokens\": 15}"
```
## 测试结果对比
| 配置 | 生成速度(tokens/s) | 提升 |
| ---------------------------------- | -------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------- |
| 无草稿(vLLM 0.20.0) | 8tokens/s | 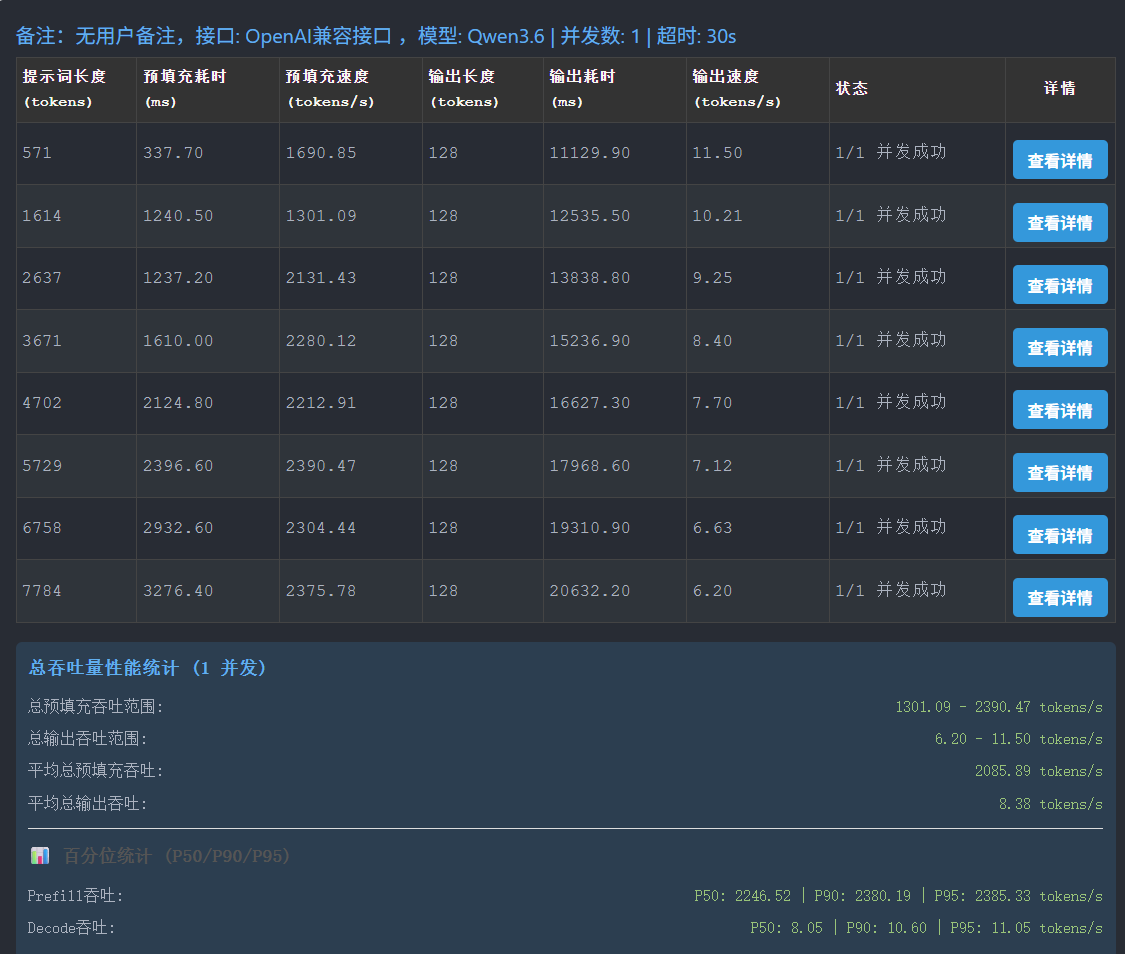 |
| 有草稿(vLLM 0.20.0) | 23tokens/s | 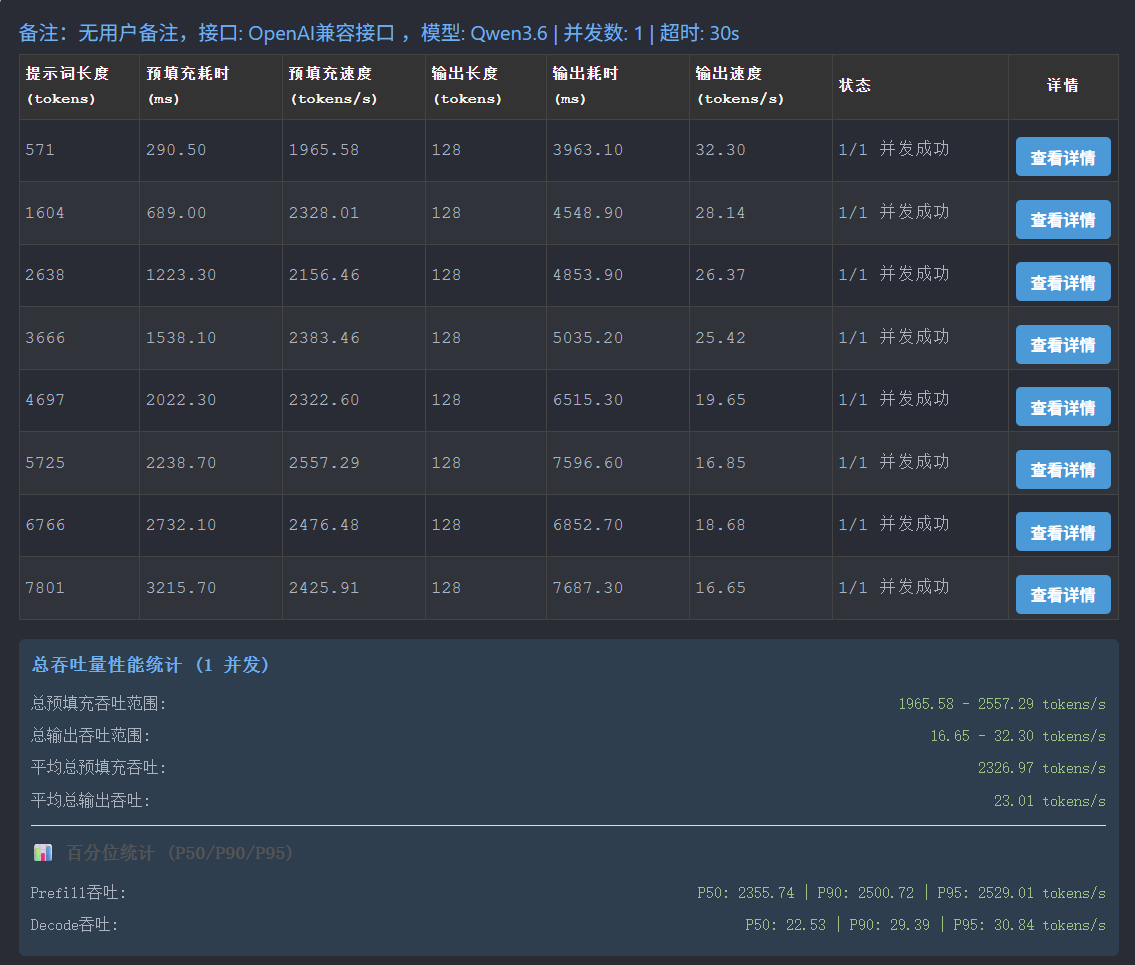 |
| **有草稿(vLLM 0.20.2rc1)** | **34tokens/s** | 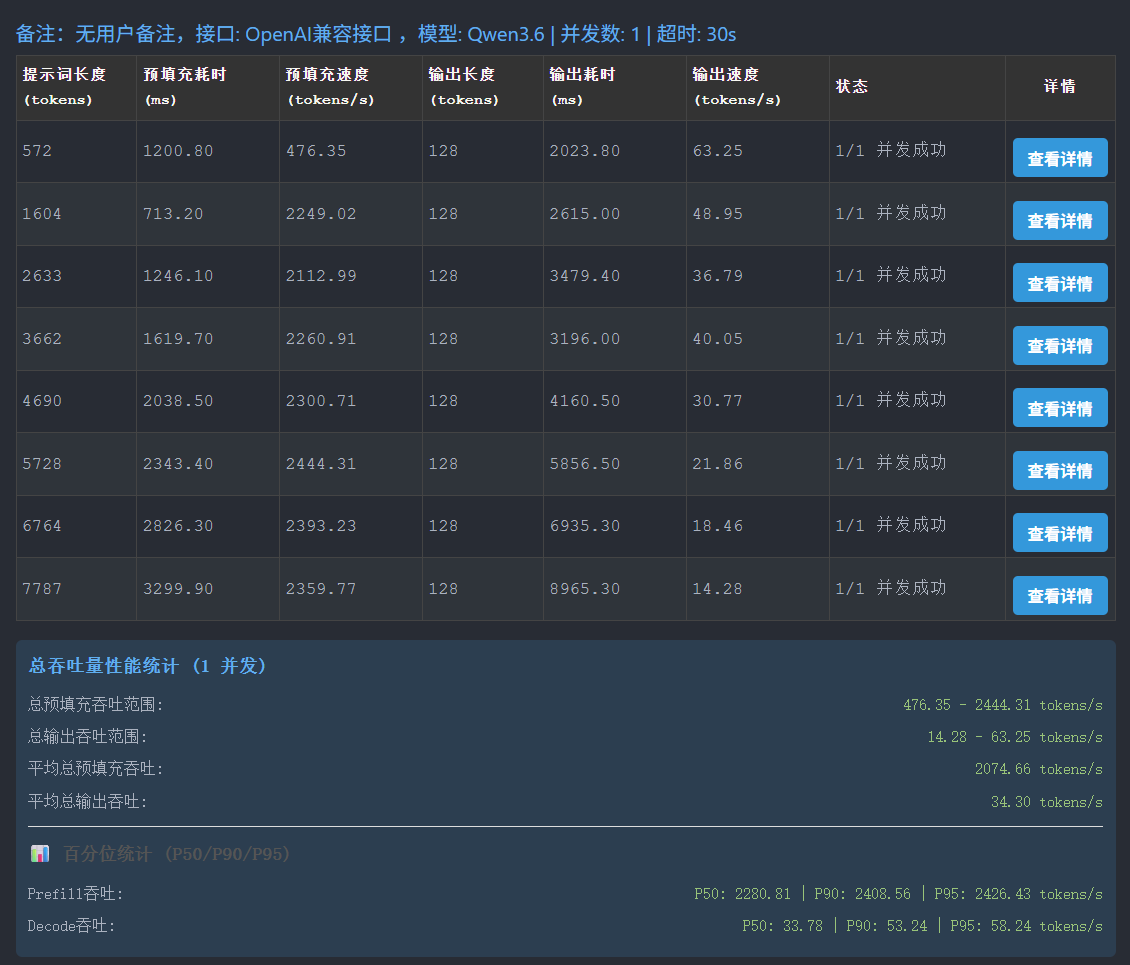 |
## 有需要的可升级到 vLLM 0.20.2rc1
在提供的镜像内执行以下命令:
```
# 下载 wheel 包
wget http://60.190.128.9:18601/vllm-0.20.2rc1.dev51+gce026b01c.d20260516.rocm633-cp310-cp310-linux_x86_64.whl
# 安装
pip install vllm-0.20.2rc1.dev51+gce026b01c.d20260516.rocm633-cp310-cp310-linux_x86_64.whl
# 降级 numpy 以兼容依赖
pip install numpy==1.26.4
```
* **DFlash 草稿生成**在 DCU 上对 Qwen3.6-27B 有效,但需要配合较新的 vLLM 版本才能发挥性能。
* **vLLM 0.20.2rc1** 相比 0.20.0 有明显优化,草稿生成带来 **+10 tokens/s** 的提升。
* 推荐使用上述镜像 + 升级后的 vLLM 版本 + DFlash草稿模型进行部署
* Gemma-4-31B-it + 草稿 提升不明显,输出低于20 **tokens/s**
* 草稿模型的效果受提示词(Prompt)长度影响显著:当输入提示词较长时,草稿生成的命中率下降,输出 tokens/s 增益会明显降低;反之在短提示词、长生成场景下收益最高。
全部评论(7)
只看楼主
小
7/10
H
请问vLLM 0.20.2rc1 对应的vllm_hcu怎么升级,我的镜像还是0.18.1
5/27
Z
请问使用的是哪个基座vllm镜像?
5/24
网
我那还有个量化版本的27b,到时候我试试能不能进一步提升
5/23
网
厉害啊,短提示词的情况27b这提升有5倍了,我上次给qwen3.6 35b a3b开MTP感觉收益不大,毕竟不开已经有50-60tps了。
5/23
没有更多内容了
--
楼主

0 点赞
0 帖子
楼主热帖
 暂无数据
常见问题新帖
暂无数据